

راهنمای جامع تاریخچه مدل زبانی بزرگ (LLM)؛ از شبکههای عصبی اولیه تا سیستمهای هوش مصنوعی امروزی دارای قابلیت استدلال و گردشهای کاری عاملمحور .
مقدمه
چشمانداز هوش مصنوعی از زمانی که ChatGPT در نوامبر ۲۰۲۲ برای نخستین بار توجه عموم را به خود جلب کرد، به شکل چشمگیری تغییر کرده است. آنچه در ابتدا بهعنوان یک هوش مصنوعی مکالمهای چشمگیر آغاز شد، اکنون به سیستمهای استدلال پیشرفته ، عاملهای خودکار (Autonomous Agents) و مدلهای تخصصی تبدیل شده است؛ فناوریهایی که در حال تغییر شیوه کار، پژوهش و نوآوری ما هستند.
با بیش از ۲۰۰ میلیون کاربر فعال در سراسر جهان و رسیدن سهم کدهای تولیدشده توسط هوش مصنوعی به نزدیک ۴۶ درصد از نرمافزارهای جدید، طبق گزارش سال ۲۰۲۴ گیتهاب (GitHub)، مدلهای زبانی بزرگ (LLMs) به بخشی جداییناپذیر از زیرساخت فناوری مدرن تبدیل شدهاند.
این راهنمای جامع، تاریخچه مدل زبانی بزرگ (LLM) را بررسی میکند؛ از مبانی نظری آنها در دهه ۱۹۵۰ گرفته تا انقلاب ترنسفورمر و ورود به عصر کنونی مدلهای استدلالی، قابلیتهای چندوجهی و هوش مصنوعی عاملمحور (Agentic AI).
در این مسیر، نقاط عطف مهم را بررسی میکنیم و نگاهی به آیندهای خواهیم داشت که این فناوریِ بهسرعت در حال تکامل برای ما رقم خواهد زد.

تاریخچه مدل زبانی بزرگ (LLM) : از ELIZA تا GPT
مسیر حرکت به سوی مدلهای زبانی بزرگ (LLM) در دهههای ۱۹۵۰ و ۱۹۶۰ با آزمایشهای اولیه در پردازش زبان طبیعی(NLP) آغاز شد. در سال ۱۹۵۴، پژوهشگران در IBM و دانشگاه جورجتاون یکی از نخستین سیستمهای ترجمه ماشینی را به نمایش گذاشتند که بهصورت خودکار عبارات روسی را به انگلیسی تبدیل میکرد. این دستاورد، جرقهای برای دههها پژوهش در زمینه زبانشناسی محاسباتی بود.
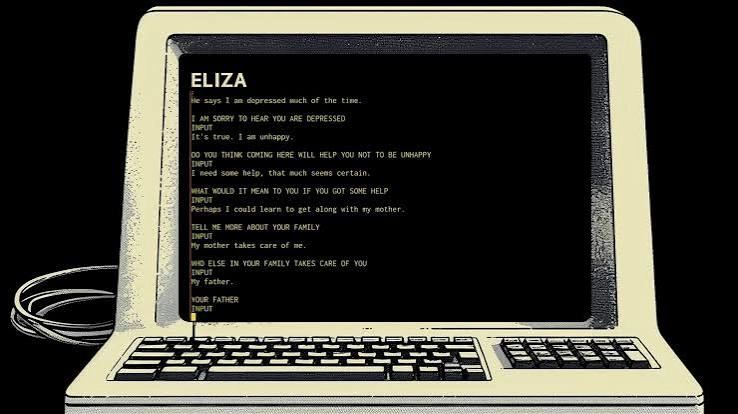
الیزا (ELIZA) که توسط پژوهشگر MIT، جوزف وایزنباوم در سال ۱۹۶۶ ساخته شد، به نخستین چتبات جهان تبدیل شد. الیزا با استفاده از تطبیق الگوی ساده میتوانست با منعکس کردن نظرات کاربران در قالب پرسش، مکالمه را شبیهسازی کند. با وجود اینکه الیزا بر اساس استانداردهای امروزی بسیار ابتدایی بود، نشان داد که رایانهها میتوانند وارد گفتگوهایی شبیه به تعامل انسانی شوند و زمینه را برای هوش مصنوعی مکالمهای فراهم کرد.
این حوزه در سال ۱۹۹۷ با معرفی شبکههای حافظه کوتاهمدت طولانی (LSTM) پیشرفت چشمگیری کرد؛ شبکههایی که میتوانستند دادههای متوالی را پردازش کنند و در عین حال اطلاعات را برای دورههای طولانیتری حفظ کنند. این قابلیت، امکان درک پیچیدهتر زبان را فراهم ساخت. مجموعه CoreNLP استنفورد در سال ۲۰۱۰ نیز با قابلیتهایی مانند تحلیل احساسات و تشخیص موجودیتهای نامدار، این تواناییها را بیش از پیش گسترش داد.
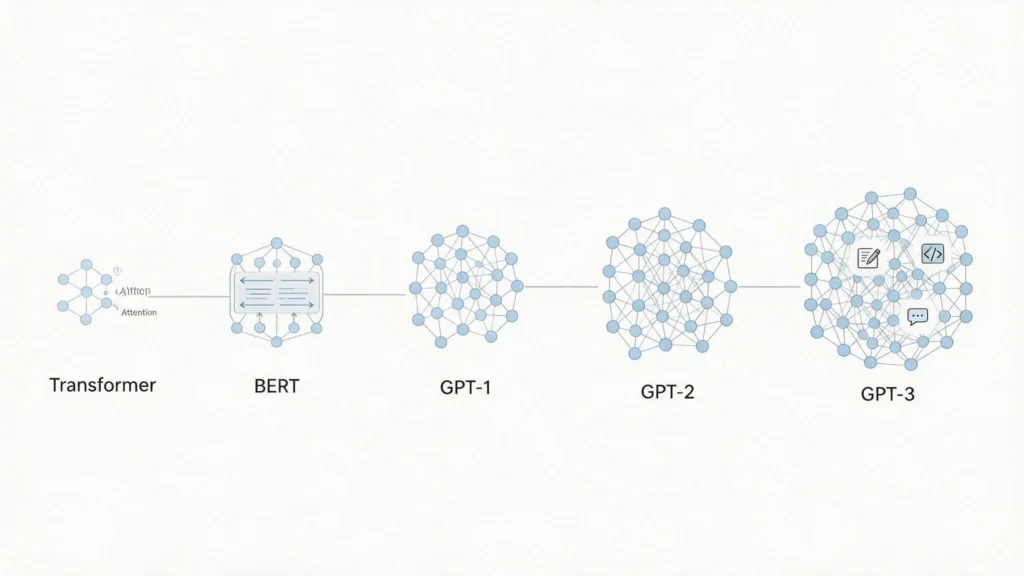
معماری ترنسفورمر (Transformer) که در مقاله تأثیرگذار گوگل در سال ۲۰۱۷ با عنوان «attention is all you need» معرفی شد، این حوزه را متحول کرد.برخلاف معماریهای پیشین که دنبالهها را یک عنصر در هر مرحله پردازش میکردند، ترنسفورمرها میتوانستند کل دنباله را بهصورت موازی پردازش کنند و با استفاده از مکانیسمهای توجه، روابط میان هر یک از عناصر را بدون توجه به فاصله آنها از یکدیگر شناسایی کنند.
ظهور مدلهای زبانی بزرگ مدرن: ۲۰۱۸ تا ۲۰۲۳
معماری ترنسفورمر (Transformer) امکان مقیاسپذیری سریع مدلهای زبانی را فراهم کرد. BERT که توسط گوگل در سال ۲۰۱۸ با ۳۴۰ میلیون پارامتر معرفی شد، میتوانست بافت و مفهوم متن را از هر دو جهت درک کند. BERT بهسرعت به یکی از پایههای اصلی جستجوی گوگل تبدیل شد و استانداردهای جدیدی را در بسیاری از وظایف پردازش زبان طبیعی (NLP) تعیین کرد.
سری مدلهای GPT شرکت OpenAI، قدرت مقیاسپذیری مدلهای زبانی را نشان داد.
- GPT-1 در سال ۲۰۱۸ ثابت کرد که مدلهای زبانی میتوانند پس از پیشآموزی روی مجموعهای متنوع از متون، وظایف مختلفی را انجام دهند.
- GPT-2 در سال ۲۰۱۹ با ۱.۵ میلیارد پارامتر، متنی بسیار منسجم تولید میکرد؛ بهگونهای که OpenAI در ابتدا انتشار کامل آن را به دلیل نگرانی درباره سوءاستفاده احتمالی به تأخیر انداخت.
- GPT-3 در سال ۲۰۲۰ با ۱۷۵ میلیارد پارامتر، یک جهش بزرگ محسوب میشد؛ این مدل میتوانست با نیاز بسیار کم به آموزش اختصاصی برای هر وظیفه، مقاله بنویسد، کدنویسی انجام دهد و در گفتگوهای پیچیده شرکت کند.
انقلاب استدلال: ۲۰۲۴ تا ۲۰۲۵
دوره بین سالهای ۲۰۲۴ تا ۲۰۲۵ شاید شاهد مهمترین تغییر معماری از زمان معرفی ترنسفورمر اولیه (Transformer) بود: ظهور مدلهای استدلالی (Reasoning Models). این سیستمها تنها متن روان تولید نمیکنند؛ بلکه بهصورت مرحلهبهمرحله درباره مسائل فکر میکنند، روند حل مسئله خود را بررسی میکنند و در طول فرآیند پاسخدهی، عملکرد خود را بهبود میدهند.
مدلهای o1 و o3 شرکت OpenAI: یک رویکرد جدید
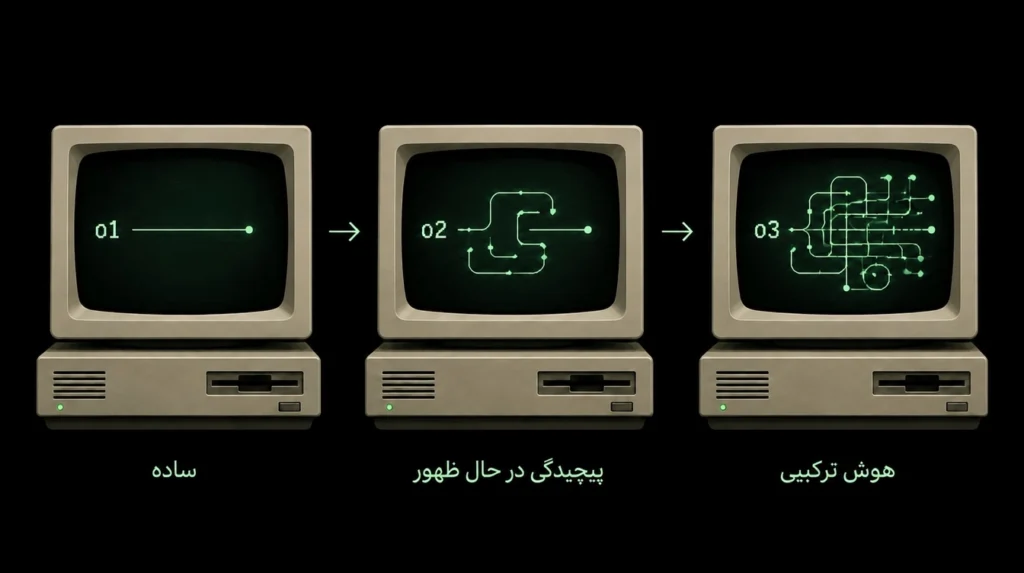
در سپتامبر ۲۰۲۴، شرکت OpenAI مدل o1-preview را منتشر کرد؛ نخستین مدل از سری جدید «مدلهای استدلالی» که بهطور ویژه برای حل مسائل پیچیده با استفاده از زنجیره افکار (Chain-of-Thought) آموزش دیده بودند. برخلاف GPT-4 که پاسخها را بهصورت مستقیم تولید میکند، o1 زمان بیشتری را صرف «فکر کردن» میکند و پیش از ارائه پاسخ نهایی، مسیرهای استدلال داخلی ایجاد میکند.
این رویکرد برای حل مسائل پیچیده تحولآفرین بود. در مسابقه ریاضی AIME سال ۲۰۲۴، مدل GPT-4o تنها توانست ۱۲ درصد از مسائل را حل کند، در حالی که o1 با یک بار تلاش به موفقیت ۷۴ درصدی رسید و با استفاده از تکنیکهای نمونهبرداری پیشرفته این میزان را به ۹۳ درصد افزایش داد.
خانواده o3 که در دسامبر ۲۰۲۴ معرفی شد، قابلیتهای استدلال را حتی بیشتر توسعه داد. این مدل با استفاده از «استدلال شبیهسازیشده» (SR) و جستجو در زمان آزمایش (Test-Time Search) ــ یعنی تولید چندین مسیر استدلالی احتمالی و انتخاب بهترین مسیر ــ توانست در بنچمارک ARC-AGI به امتیاز ۸۷.۵ درصد دست یابد و به عملکرد انسانی (۸۵ درصد) نزدیک شود.
OpenAI همچنین مفهوم همراستایی مشورتی (Deliberative Alignment) را معرفی کرد؛ رویکردی که در آن مدلها آموزش میبینند تا در طول فرآیند استدلال خود، به سیاستهای ایمنی داخلی ارجاع دهند. این موضوع نشاندهنده رویکردی جدید در زمینه ایمنی هوش مصنوعی است.
مدل GPT-4o و یکپارچهسازی چندوجهی
ماه می ۲۰۲۴ شاهد انتشار GPT-4o («Omni») بود؛ مدلی که برای ترکیب یکپارچه قابلیتهای متنی، صوتی و تصویری طراحی شده بود. GPT-4o میتوانست در مکالمات صوتی بلادرنگ (Real-Time) شرکت کند، تصاویر را تحلیل کند و خروجیهایی در قالبهای مختلف تولید کند؛ آن هم با تأخیر بسیار کمتر نسبت به مدلهای پیشین.
این پیشرفت، نشاندهنده حرکت به سمت تعامل طبیعیتر میان انسان و رایانه بود.
مدل GPT-5: مدل همگرایی
مدل GPT-5 شرکت OpenAI که در سال ۲۰۲۵ عرضه شد، نشاندهندهی ادغام قابلیتهای چندوجهی و استدلال در یک مدل پرچمدار واحد است. با یک پنجرهی متنی ۴۰۰ هزار توکنی (افزایشیافته از ۱۲۸ هزار در GPT-4) و بهبود قابلیت اطمینان – نرخ توهم به حدود ۶.۲ درصد کاهش یافته است – مدل GPT-5 توانست نمرات کامل را در معیار ریاضی AIME 2025 کسب کند. شرکت OpenAI همچنین با مدلهای gpt-oss-120b و gpt-oss-20b که تحت مجوز Apache 2.0 عرضه شدند، وارد عرصهی مدلهای متنباز شد.
انقلاب دیپسیک(Deepseek): همگانی کردن استدلال
ژانویه ۲۰۲۵ یکی از مهمترین تغییرات در تاریخ هوش مصنوعی را رقم زد: انتشار DeepSeek R1 توسط آزمایشگاه هوش مصنوعی چینی دیپسیک (DeepSeek). این مدل استدلالی متنباز (Open-Source) در وظایف مرتبط با ریاضیات، برنامهنویسی و استدلال، به عملکردی قابل مقایسه با مدل o1 شرکت OpenAI دست یافت؛ اما با هزینهای بسیار کمتر.
رویکرد دیپسیک تحولی مهم به شمار میرفت. مدل R1-Zero نشان داد که قابلیتهای استدلالی میتوانند تنها از طریق یادگیری تقویتی (Reinforcement Learning) و بدون استفاده از تنظیم دقیق (Fine-Tuning) نظارتشده یا نمونههای استدلالی برچسبگذاریشده توسط انسان، به وجود بیایند.
این مدل بهصورت خودجوش تواناییهایی مانند خودآزمایی (Self-Verification)، تأمل (Reflection) و زنجیره افکار گسترده را توسعه داد؛ قابلیتهایی که پیشتر تصور میشد تنها از طریق آموزش مستقیم و هدفمند به دست میآیند.
شاید مهمترین جنبه این دستاورد، موضوع هزینه بود. دیپسیک اعلام کرد که آموزش V3 (مدل پایه) حدود ۵ میلیون دلار و توسعه R1 نیز ۲۹۴ هزار دلار هزینه داشته است؛ رقمی که چندین مرتبه کمتر از صدها میلیون دلاری است که پیش از این برای توسعه مدلهای پیشرو (Frontier Models) ضروری در نظر گرفته میشد. این انتشار همزمان با ارزیابی دوباره اقتصاد هوش مصنوعی توسط سرمایهگذاران، باعث زیانی نزدیک به ۱ تریلیون دلار در بازار سهام شد.
دیپسیک همچنین توانایی انتقال دانش (Knowledge Distillation) را بهخوبی نشان داد. مدل انتقال یافته ۱۴ میلیارد پارامتری این شرکت توانست عملکردی بهتر از مدل بسیار بزرگتر QwQ-32B داشته باشد؛ موضوعی که نشان میدهد مدلهای کوچکتر نیز میتوانند قابلیتهای استدلال پیچیده را از مدلهای بزرگتر به ارث ببرند.
این پیشرفت، مسیرهای جدیدی را برای اجرای مدلهای هوش مصنوعی قدرتمند روی سختافزارهای مصرفی فراهم کرد.
چشمانداز فعلی مدلها: دنیای چندقطبی هوش مصنوعی
تا اوایل سال ۲۰۲۶، چشمانداز هوش مصنوعی از دوره سلطه OpenAI به یک محیط رقابتی و چندقطبی تبدیل شده است:
OpenAI
مدل GPT-5.2 با پنجره زمینه (Context Window) ۴۰۰ هزار توکنی و کاهش میزان توهمات، همچنان در میان مدلهای پرچمدار قرار دارد. سری o (شامل o1، o3 و o4-mini) نیز قابلیتهای استدلال تخصصی ارائه میدهد. OpenAI همچنان بیشترین سهم ذهنی کاربران (Consumer Mindshare) را در اختیار دارد؛ ChatGPT بیش از ۲۰۰ میلیون کاربر دارد، اما با رقابت فزایندهای از سوی سایر شرکتها روبهرو است.
Anthropic
مدل Claude 4 در نسخههای Opus و Sonnet، با تکیه بر اصول «هوش مصنوعی قانوناساسیمحور» (Constitutional AI) و حالتهای تفکر گسترده، بر ایمنی و استدلال دقیق تأکید دارد. مدل Claude Opus 4 در آزمونهای کدنویسی SWE-Bench به امتیاز ۷۲.۵ درصد دست یافت، در حالی که GPT-4 امتیاز ۵۴.۶ درصد را کسب کرد؛ نتیجهای که جایگاه این مدل را در وظایف مهندسی نرمافزار تقویت کرد. اکنون Claude 4.5 نیز در بسیاری از بنچمارکها بهطور مستقیم با GPT-5 رقابت میکند.
Google DeepMind
خانواده جمینای (Gemini) در طول سال ۲۰۲۵ با انتشار نسخههای ۲.۰، ۲.۵ و ۳.۰ بهسرعت توسعه یافت. مدلهای جمینای (Gemini) از پنجرههای زمینهای بیش از یک میلیون توکن، پردازش چندوجهی بومی (Native Multimodal Processing) و قیمتگذاری رقابتی پشتیبانی میکنند.
نسخه استدلالی Deep Think گوگل نیز در مسابقات ریاضی به رقابت مستقیم با o3 پرداخته است. طبق گزارشها، در دسامبر ۲۰۲۵ شرکت OpenAI در واکنش به پیشرفت Gemini 3 وضعیت «کد قرمز» (Code Red) اعلام کرد.
Meta
مدل لاما ۴ (Llama 4) که در آوریل ۲۰۲۵ منتشر شد، شامل نسخههای Scout و Maverick با قابلیتهای چندوجهی و پنجره زمینه گستردهتر است. با این حال، Llama در رقابت با برخی مدلهای متنباز چینی جایگاه خود را تا حدی از دست داده است؛ بر اساس ردیابیهای پروژه ATOM، مدل Qwen شرکت علیبابا اکنون از نظر میزان دانلود و تعداد مدلهای توسعهیافته توسط جامعه کاربری، پیشتاز است.
بازیگران نوظهور
مدل میسترال ۳ (Mistral 3) از شرکت Mistral AI با ۶۷۵ میلیارد پارامتر و معماری ترکیب متخصصان (Mixture-of-Experts) توانسته است با صرف حدود ۱۵ درصد از هزینه، ۹۲ درصد از عملکرد GPT-5.2 را ارائه دهد.
مدل Qwen 3 شرکت علیبابا نیز در پذیرش مدلهای متنباز جایگاه پیشرو دارد. دیگر آزمایشگاههای هوش مصنوعی چینی مانند MiniMax، GLM و Yi همچنان به توسعه خود ادامه میدهند، در حالی که Grok 3 از شرکت xAI در رده مدلهای ممتاز (Premium Tier) به رقابت میپردازد.
ظهور هوش مصنوعی عاملی: از دستیارها تا سیستمهای خودکار
شاید تحولآفرینترین پیشرفت در سالهای ۲۰۲۴ تا ۲۰۲۵، ظهور هوش مصنوعی عاملی (Agentic AI) بود؛ سیستمهایی که دیگر فقط به پرامپتها پاسخ نمیدهند، بلکه برای دستیابی به اهداف پیچیده، بهصورت خودکار برنامهریزی میکنند، اقدامات لازم را انجام میدهند و خود را با شرایط جدید سازگار میکنند.
بازار عاملهای هوش مصنوعی از ۵.۴ میلیارد دلار در سال ۲۰۲۴ به ۷.۶ میلیارد دلار در سال ۲۰۲۵ افزایش یافت و پیشبینی میشود تا سال ۲۰۳۰ به ۵۰ میلیارد دلار برسد.
مدلهای زبانی بزرگ عاملی (Agentic LLMs) تفاوت اساسی با چتباتهای سنتی دارند. در حالی که یک مدل زبانی بزرگ معمولی صرفاً پاسخ تولید میکند، یک عامل میتواند نتیجه ایجاد کند. این سیستمها قادرند برنامههای چندمرحلهای را با استفاده از استدلال پیش ببرند، ابزارها و رابطهای برنامهنویسی کاربردی (API) خارجی را فراخوانی کنند، حافظه را در طول تعاملات حفظ کنند، نتایج را بررسی کنند و از خطاها بازیابی شوند؛ آن هم با کمترین میزان نظارت انسانی.
گارتنر (Gartner) پیشبینی میکند که تا سال ۲۰۲۹، ۸۰ درصد از درخواستهای پشتیبانی مشتریان توسط عاملهای هوش مصنوعی مدیریت خواهد شد.
قابلیتهای کلیدی عاملها اکنون شامل موارد زیر است:
- استفاده از ابزار (فراخوانی APIها، دسترسی به پایگاههای داده و مرور وب)
- حافظه پایدار (حفظ اطلاعات و زمینه در تعاملات مختلف)
- برنامهریزی خودکار (تقسیم اهداف پیچیده به مراحل قابل اجرا)
- خوداصلاحی (شناسایی و اصلاح خطاها).
چارچوبهایی مانند LangChain، LangGraph، CrewAI و AutoGen مایکروسافت برای پشتیبانی از توسعه عاملهای هوش مصنوعی ایجاد شدهاند.
پلتفرمهای بزرگ فناوری نیز محصولات عاملی اختصاصی خود را عرضه کردهاند. محصول Operator از OpenAI وظایف مرتبط با وب را بهصورت خودکار انجام میدهد، Project Mariner از گوگل گردشهای کاری مبتنی بر مرورگر را خودکار میکند و Claude 4 از شرکت Anthropic از قابلیتهای گسترده «استفاده از رایانه» پشتیبانی میکند.
بر اساس گزارش «وضعیت عاملهای هوش مصنوعی» از LangChain، در حال حاضر ۲۳ درصد از سازمانها در حال توسعه و گسترش سیستمهای هوش مصنوعی عاملی خود هستند و ۳۹ درصد دیگر نیز بهطور فعال در حال آزمایش این فناوری هستند.

آینده مدلهای زبانی بزرگ: ۲۰۲۶ و پس از آن
چندین روند مهم، مسیر مرحله بعدی تکامل مدلهای زبانی بزرگ را مشخص میکنند:
مقیاسگذاری محاسبات در زمان اجرا
به جای اینکه تنها مدلهای بزرگتر آموزش داده شوند، صنعت هوش مصنوعی به سمت استفاده بیشتر از توان محاسباتی در زمان استنتاج (Inference) حرکت میکند.
مدلهای استدلالی مانند o3 چندین راهحل احتمالی تولید میکنند، آنها را ارزیابی کرده و رویکرد خود را اصلاح میکنند؛ یعنی سرعت را با دقت بیشتر معاوضه میکنند. این رویکرد، نشاندهنده یک الگوی جدید در مقیاسگذاری فراتر از پیشآموزش سنتی است.
عاملهای خودکار در مقیاس گسترده
رویکرد عاملی (Agentic) همچنان گسترش خواهد یافت. مدلهایی که میتوانند وظایف طولانیمدت را مدیریت کنند، از ابزارها بهصورت مؤثر استفاده کنند و از خطاها بازیابی شوند، شیوه انجام کارهای دانشی را متحول خواهند کرد.
سیستمهای چندعاملی (Multi-Agent Systems) ــ یعنی تیمهایی از عاملهای تخصصی هوش مصنوعی که برای حل مسائل پیچیده با یکدیگر همکاری میکنند ــ هماکنون در محیطهای عملیاتی در حال ظهور هستند.
مدلهای زبانی کوچک و کارآمد
تمام پیشرفتها به مدلهای بسیار بزرگ وابسته نیستند. مدلهای زبانی کوچک (Small Language Models – SLMs) با ۱ تا ۱۲ میلیارد پارامتر، برای بسیاری از وظایف عاملی کافی هستند؛ بهخصوص زمانی که خروجیها محدود بوده و استفاده از ابزارها در نظر گرفته شود.
مدلهایی مانند نسخههای تقطیرشده DeepSeek R1، Phi-4-Mini و Gemini Nano، قابلیتهای پیشرفته را به دستگاههای لبه (Edge Devices) و کاربردهای حساس به هزینه منتقل میکنند.
سیستمهای خودبهبوددهنده
نمایش موفقیتآمیز DeepSeek R1 در شکلگیری تواناییهای استدلالی تنها از طریق یادگیری تقویتی، نشان میدهد که مدلها ممکن است در آینده بهطور فزایندهای دادههای آموزشی خود را تولید کنند.
آزمایشهای گوگل در زمینه تولید نمونههای آموزشی توسط مدلهای زبانی بزرگ برای تنظیم دقیق، به سمت چرخههای بهبود خودکارتر مدلها اشاره دارند.
مدلهای متخصصان پراکنده
معماریهای ترکیب متخصصان (Mixture-of-Experts – MoE) که در مدلهایی مانند DeepSeek V3 و Mistral 3 استفاده شدهاند، تنها بخشهای مرتبطی از پارامترهای مدل را برای هر وظیفه فعال میکنند.
این رویکرد امکان ساخت مدلهایی با تعداد بسیار بیشتری پارامتر را بدون افزایش شدید هزینههای محاسباتی فراهم میکند و میتواند به ادامه پیشرفت قابلیتهای مدلها، بدون افزایش متناسب هزینه استنتاج، کمک کند.
حرکت به سوی هوش مصنوعی عمومی (AGI)؟
اگرچه مدلهای پیشرو امروزی در بسیاری از بنچمارکها به سطح عملکرد انسانی نزدیک شدهاند، هوش مصنوعی عمومی واقعی (Artificial General Intelligence – AGI) همچنان دستنیافتنی باقی مانده است.
مدلها در تطبیق الگوهای موجود در دادههای آموزشی عملکرد بسیار خوبی دارند، اما ممکن است در مواجهه با مسائل کاملاً جدید، به شکل غیرمنتظرهای شکست بخورند.
مسیر حرکت از تواناییهای فعلی به سمت هوش عمومی واقعی ــ در صورت امکانپذیر بودن ــ هنوز مشخص نیست. با این حال، آنچه قطعی است این است که قابلیتهای هوش مصنوعی همچنان با سرعت زیادی پیشرفت خواهند کرد و توجه مداوم به ایمنی، همراستایی و استفاده مفید از این فناوری ضروری خواهد بود.
جمع بندی و نتیجه گیری
توسعه مدلهای زبانی بزرگ (LLMs) از چتباتهای سادهای مانند الیزا تا سیستمهای استدلالی پیشرفته و عاملهای خودمختار (Agentic AI) امروزی، نشاندهنده یک انقلاب تکنولوژیک است. با ظهور معماریهای بهینهتر، پیشرفت مدلهای متنباز مانند دیپسیک و تکامل سیستمهای چندوجهی عظیم مانند GPT-5 و Gemini 3، هوش مصنوعی از یک تولیدکننده صرفِ متن، به زیرساختی هوشمند برای برنامهریزی و حل مستقل مسائل پیچیده تبدیل شده است. اگرچه دستیابی به هوش مصنوعی عمومی (AGI) همچنان با چالشهایی روبهروست، اما این مسیر نشان میدهد که در آینده، توسعه مسئولانه، ایمنی و همراستایی این ابزارهای قدرتمند با ارزشهای انسانی، از مهمترین اولویتهای جهان فناوری خواهد بود.

دیدگاهتان را بنویسید