
واژهنامه · فنی
تنظیم دقیق (Fine Tuning) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
تنظیم دقیق (Fine tuning) در یادگیری ماشین به فرآیند سازگار کردن یک مدل از پیش آموزشدیده برای انجام وظایف یا کاربردهای خاص گفته میشود.
تعریف تخصصی تنظیم دقیق (Fine tuning)
تنظیم دقیق (Fine-tuning) به فرایند آموزش بیشتر یک مدل زبانی بزرگ (LLM) از پیش آموزشدیده (Pre-trained) با استفاده از یک مجموعهداده مخصوص یک وظیفه گفته میشود؛ این فرایند نوعی یادگیری انتقال (Transfer learning) است. به بیان ساده، یک مدل از پیش آموزشدیده (Pre-trained model) پیش از آن اطلاعات عمومی زیادی را یاد گرفته است و تنظیم دقیق به آن کمک میکند تا در یک حوزه خاص تخصص پیدا کند.
تفاوت تنظیم دقیق (Fine-tuning) و مهندسی پرامپت (Prompt engineering) و RAG
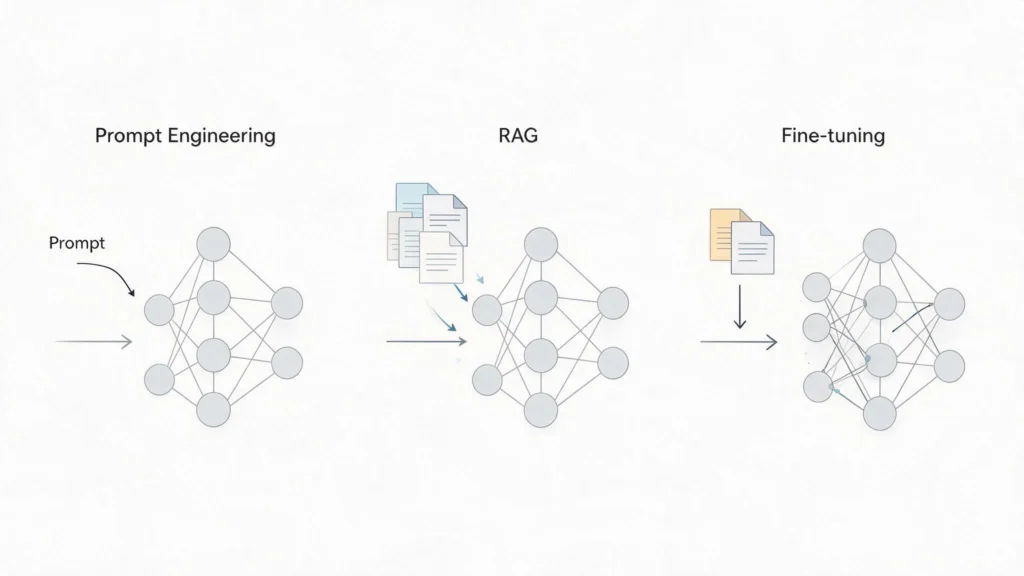
این سه روش برای سازگار کردن مدلهای هوش مصنوعی با نیازهای خاص استفاده میشوند، اما هرکدام بخش متفاوتی از مدل را تغییر میدهند:
مهندسی پرامپت (Prompt engineering)
فقط دستورالعمل و ساختار ورودی مدل را تغییر میدهد و به وزنهای مدل دست نمیزند. این روش سریع و کمهزینه است، اما به قابلیتهای موجود مدل و پنجره زمینه (Context window) آن محدود میشود.
تولید تقویتشده با بازیابی (RAG)
اطلاعاتی را که مدل هنگام تولید پاسخ به آنها دسترسی دارد، افزایش میدهد. در این روش، اسناد مرتبط از منابع خارجی، معمولاً با استفاده از پایگاه داده برداری (Vector database)، بازیابی و در اختیار مدل قرار میگیرند، بدون اینکه وزنهای مدل تغییر کنند. RAG بیشتر زمانی مناسب است که مدل توانایی انجام وظیفه را دارد اما به اطلاعات داخلی یا بهروز دسترسی ندارد.
تنظیم دقیق (Fine tuning)
وزنهای مدل را تغییر میدهد تا رفتار آن برای یک وظیفه، سبک یا حوزه خاص سازگار شود. این روش نسبت به دو روش دیگر به داده، توان محاسباتی و تخصص بیشتری نیاز دارد و معمولاً زمانی استفاده میشود که مهندسی پرامپت و RAG پاسخگوی نیاز نباشند.
در نتیجه، مهندسی پرامپت نحوه دستور دادن به مدل را تغییر میدهد، RAG اطلاعات در دسترس مدل را تغییر میدهد و تنظیم دقیق (Fine tuning) رفتار و پارامترهای مدل را تغییر میدهد.
تنظیم دقیق (Fine tuning) در هوش مصنوعی چگونه کار میکند؟
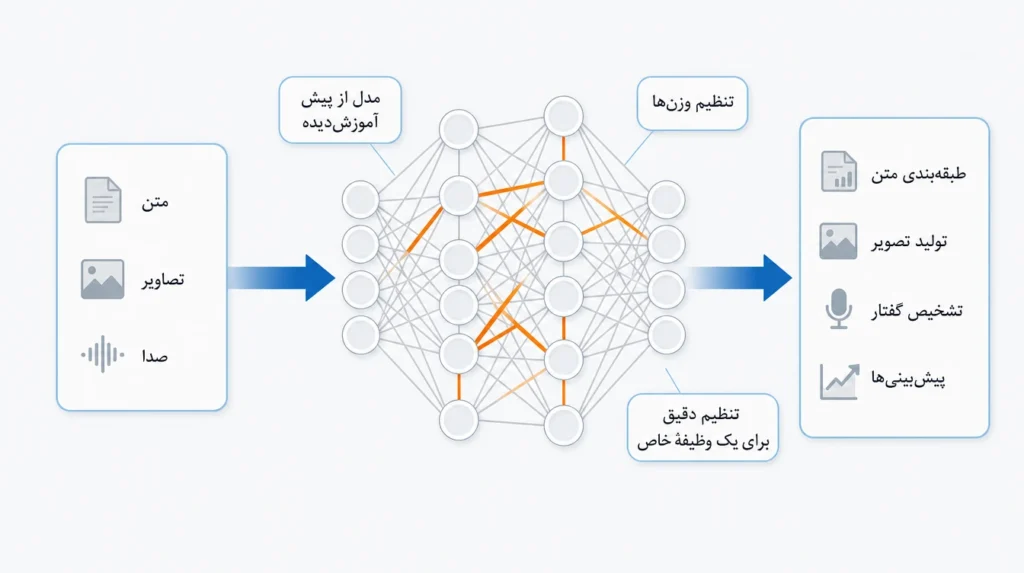
تنظیم دقیق (Fine-tuning) با اصلاح بازنماییهای آموختهشدهی یک مدل هوش مصنوعی انجام میشود تا مدل بتواند خود را بهتر با یک وظیفه یا دامنهی خاص هماهنگ کند. بیشتر سیستمهای هوش مصنوعی مدرن کار خود را با مدلهای ازپیشآموزشدیده آغاز میکنند؛ مدلهایی که پیشتر با الگوهای کلی موجود در مجموعهدادههای بزرگ آموزش دیدهاند.
در طول تنظیم دقیق، مدل در معرض مجموعهدادهای کوچکتر و هدفمندتر قرار میگیرد و پارامترهای داخلی آن بهصورت انتخابی بهروزرسانی میشوند. این فرایند به مدل اجازه میدهد الگوهای یادگیری خود را تنظیم کند، بدون آنکه دانش بنیادی بهدستآمده در طول پیشآموزش را کنار بگذارد.
ابتدا، یک مجموعهداده مرتبط انتخاب و آماده میشود تا وظیفه یا دامنه هدف را منعکس کند. در مرحله بعد، مدل با استفاده از این دادهها و تنظیمات کنترلشده، وزنهای خود را آموزش میدهد و به این ترتیب، ضمن حفظ دانش بنیادی، بر ویژگیهای خاص وظیفه تمرکز میکند. وزنها به پارامترهایی در یک مدل هوش مصنوعی، بهویژه شبکههای عصبی، اشاره دارند که قدرت اتصالات میان نورونها یا لایهها را تعیین میکنند. این وزنها در مرحله پیشآموزش یاد گرفته میشوند و در طول تنظیم دقیق تغییر میکنند تا عملکرد مدل در یک وظیفه یا مجموعهداده خاص بهبود یابد.
تنظیمات وزن بسیار مهم هستند، زیرا مستقیماً بر نحوه تفسیر ورودیها و تولید خروجیها توسط مدل تأثیر میگذارند. ارزیابی و تکرار مداوم به مدل کمک میکند تا بدون بیشبرازش یا کاهش عملکرد کلی، بهبود یابد.
یکی از سازوکارهای اصلی در فرایند تنظیم دقیق (Fine-tuning)، استفاده از «یادگیری انتقالی» در هوش مصنوعی است؛ روشی که در آن دانش حاصل از یک وظیفه، برای بهبود عملکرد در وظیفهای دیگر مجدداً به کار گرفته میشود. مدل بهجای یادگیری دوباره از صفر، درک موجود خود از زبان، تصاویر یا الگوها را منتقل کرده و آن را با اهداف جدید سازگار میسازد. این رویکرد، بهویژه زمانی که دادههای اختصاصی مربوط به یک وظیفه محدود هستند، موجب تسریع آموزش و افزایش پایداری مدل میشود. در تنظیم دقیق مبتنی بر یادگیری انتقالی، تنها جنبههای مرتبطتر رفتار مدل بهروزرسانی میشوند و در عین حال، توانمندیهای کلی آن حفظ میگردد.
مراحل تنظیم دقیق
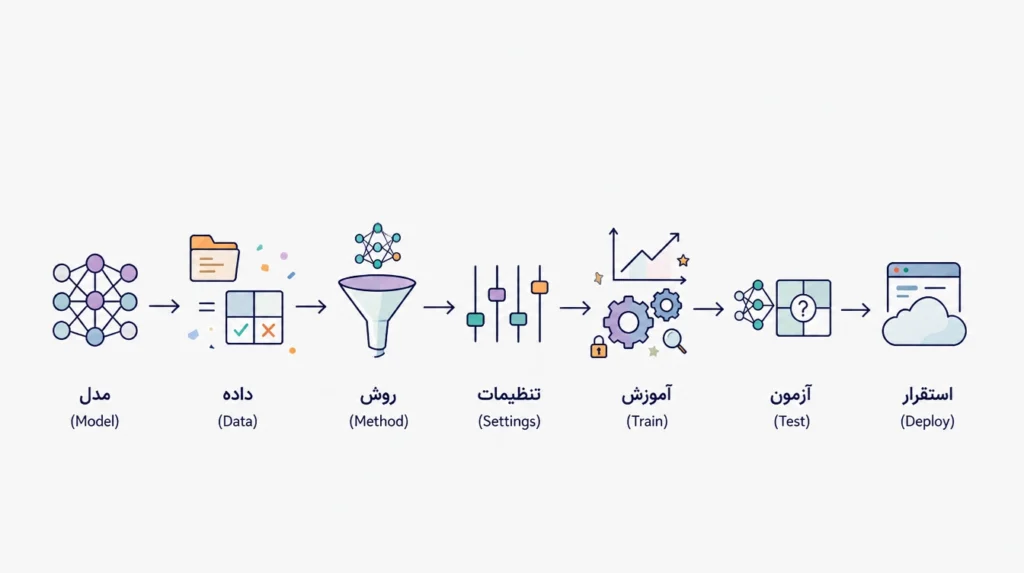
فرایند تنظیم دقیق یک مدل هوش مصنوعی معمولاً شامل مراحل زیر است:
- انتخاب یک مدل پایه (Base model): مانند GPT، BERT یا LLaMA.
- آمادهسازی یک مجموعهداده برچسبگذاریشده (Labeled dataset): شامل قالببندی و پاکسازی دادهها و ایجاد بخش اعتبارسنجی (Validation split). بخش اعتبارسنجی، بخشی جداگانه از مجموعهداده است که برای آموزش و ارزیابی مدل استفاده میشود.
- انتخاب روش تنظیم دقیق (Fine-tuning approach): مانند تنظیم دقیق کامل (Full fine-tuning) یا روشهای انطباق کمرتبه (LoRA) و آداپتور (Adapter).
- تنظیم ابرپارامترها (Hyperparameters): مانند نرخ یادگیری (Learning rate)، تعداد دورههای آموزش (Epochs) و اندازه دسته (Batch size).
- آموزش مدل و نظارت بر معیارها (Metrics): از جمله میزان خطا (Loss)، دقت (Accuracy) و عملکرد مدل در بخش اعتبارسنجی.
- ارزیابی مدل روی یک مجموعهداده کنارگذاشتهشده (Holdout set): مجموعهای از دادهها که در فرایند آموزش استفاده نشدهاند.
- استقرار مدل (Deployment) و نظارت بر عملکرد آن: در محیط تولید (Production).
انواع تنظیم دقیق (Fine tuning)
| نوع | توضیحات | کاربردها |
|---|---|---|
| تنظیم دقیق نظارتشده (Supervised fine-tuning) | مدل روی یک مجموعه داده برچسبگذاری شده با جفتهای ورودی-خروجی آموزش داده میشود. | طبقهبندی متن، تشخیص موجودیتهای نامدار، تحلیل احساسات. |
| تنظیم دقیق مبتنی بر دستورالعمل (Instruction fine-tuning) | مدل روی مجموعهای از دستورالعملها و پاسخهای مطلوب آموزش داده میشود. | چتباتها، سیستمهای پرسش و پاسخ، تولید کد. |
| یادگیری چند-نمونهای (Few-shot learning) | چند نمونه از وظیفه مورد نظر درون پرامپت (درخواست) به مدل ارائه میشود. | انطباق با وظایف جدید با دادههای محدود. |
| یادگیری انتقالی (Transfer learning) | مدل از دانشی که از پیشآموزش روی یک مجموعه داده همهمنظوره به دست آورده، بهره میبرد. | انطباق با وظایف مرتبط. |
| تنظیم دقیق مختص به دامنه (Domain-specific fine-tuning) | مدل برای یک دامنه یا صنعت خاص تطبیق داده میشود. | تحلیل اسناد حقوقی، تولید گزارشهای پزشکی، پیشبینی مالی. |
| یادگیری چندوظیفهای (Multi-task learning) | مدل به طور همزمان روی چندین وظیفه آموزش میبیند. | بهبود عملکرد در وظایف مرتبط. |
| تنظیم دقیق متوالی (Sequential fine-tuning) | مدل طی چندین مرحله برای مجموعهای از وظایف مرتبط تطبیق داده میشود. | پالایش تدریجی قابلیتها برای وظایف پیچیده. |
مزایا تنظیم دقیق (Fine-tuning):
تنظیم دقیق (Fine-tuning) به مدلهای هوش مصنوعی اجازه میدهد تا با مصرف منابع محاسباتی، زمان و هزینه بسیار کمتر نسبت به آموزش از صفر، در حوزههای تخصصی (مانند پزشکی، حقوق یا مالی) به دقت و عملکرد بسیار بالایی دست یابند.
این روش به شدت انعطافپذیر است و این امکان را فراهم میکند که حتی با استفاده از مجموعه دادههای کوچک اما باکیفیت، مدلها را به سرعت برای صنایع، زبانها و وظایف جدید سفارشیسازی کرد تا دقیقاً پاسخگوی نیازهای خاص هر کسبوکار باشند.
چالشهای تنظیم دقیق (Fine-tuning):
در مقابل، یکی از بزرگترین چالشهای این روش خطر «بیشبرازش» (Overfitting) است؛ به این معنا که مدل دادههای آموزشی را طوطیوار حفظ کرده و در مواجهه با اطلاعات جدید دچار مشکل میشود.
علاوه بر این، استفاده از دادههای بیکیفیت میتواند باعث انتقال سوگیریها و خطاهای انسانی به سیستم شود که به ویژه در صنایع حساس، نگرانیهای اخلاقی و قانونی (مثل نقض حریم خصوصی) ایجاد میکند.
از نظر فنی نیز، خطر «فراموشی فاجعهبار» وجود دارد که در آن مدل هنگام یادگیری تخصصهای جدید، دانش عمومی و پایهای گذشته خود را از دست میدهد و برای جلوگیری از این موارد همچنان به مدیریت دقیق و سختافزارهای پردازشی قدرتمند نیاز است.
نتیجهگیری علمی
تنظیم دقیق (Fine-tuning) یکی از رویکردهای مهم یادگیری انتقال (Transfer learning) است که با بهروزرسانی هدفمند پارامترها و وزنهای مدل از پیشآموزشدیده، آن را برای وظایف و حوزههای تخصصی سازگار میکند؛ بدون نیاز به آموزش مدل از صفر (From scratch). در مقایسه با مهندسی پرامپت (Prompt engineering) و RAG، این روش تغییرات پایدارتری در رفتار مدل ایجاد میکند، اما موفقیت آن به کیفیت دادهها، منابع محاسباتی و انتخاب روش مناسب وابسته است. در نهایت، استفاده مؤثر از تنظیم دقیق مستلزم ایجاد تعادل میان بهبود عملکرد تخصصی و حفظ قابلیتهای عمومی مدل، همراه با مدیریت چالشهایی مانند بیشبرازش (Overfitting) و فراموشی فاجعهبار (Catastrophic forgetting) است.