
واژهنامه
پنجره زمینه (Context Window) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
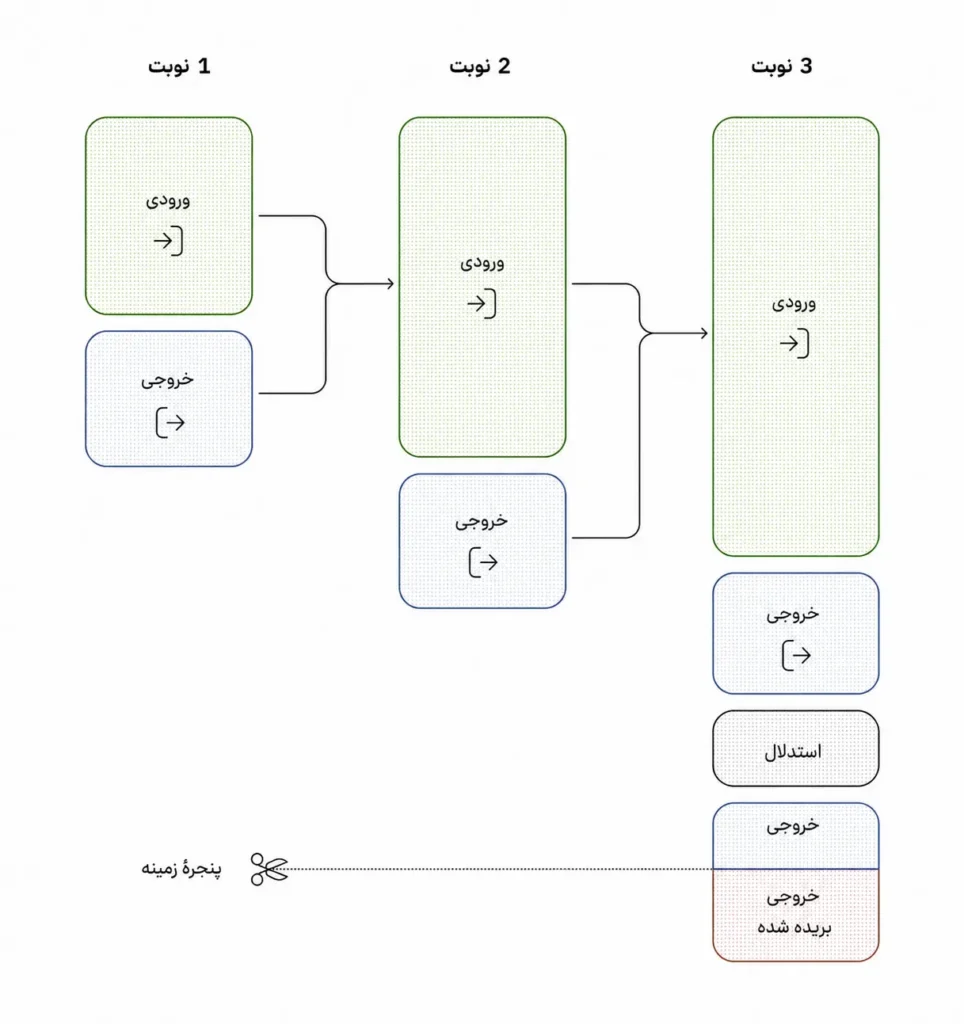
«پنجره زمینه» (Context Window) بیشترین مقدار متنی است که یک مدل زبانی بزرگ میتواند هنگام تولید پاسخ، آن را نگه دارد و به آن ارجاع دهد. این مفهوم شامل هر چیزی است که مدل میتواند در طول یک تعاملِ واحد «ببیند»: دستور یا درخواست کاربر، دستورالعملهای سیستم، تاریخچهی گفتگو، اسناد بازیابیشده و خروجیِ خودِ مدل.
پنجره زمینه مانند حافظهی فعال یا کاری (Working memory) برای یک مدل زبانی بزرگ (LLM) است. البته این تشبیه نیز محدودیتهایی دارد. انسانها بهتدریج برخی مسائل را فراموش میکنند؛ اما افزایش داده در یک مدل زبانی بزرگ باعث کمرنگ شدن مطالب قبلی نمیشود. اطلاعات یا درون این پنجره هستند یا نیستند. بهمحض اینکه پنجره پر شود، محتوای اولیهی متن — بدون هیچگونه هشداری — کوتاه یا بهکلی حذف میشود.
تفاوت پنجره زمینه و حافظه بلند مدت
پنجره زمینه همان حافظهی بلندمدت نیست. این مدلها اطلاعات را بین نوبتهای مختلف حفظ نمیکنند مگر اینکه یک سیستم خارجی آنها را تأمین کند. این فضا دادهی آموزشی هم نیست. پنجرهی زمینه چیزی را در خود نگه میدارد که مدل همین الان میتواند به آن رجوع کند، نه آنچه در طول آموزش یاد گرفته است. و این مفهوم با تنظیم دقیق (Fine-tuning) که رفتار یک مدل را بهطور دائم تنظیم میکند، تفاوت دارد. پنجره زمینه موقتی، محدود به همان نشست و متناهی است.
پنجره زمینه و توکنسازی
طولِ زمینهی یک مدل زبانی بر اساس کلمات اندازهگیری نمیشود، بلکه واحد سنجش آن «توکن» است. برای درک نحوهی عملکرد پنجرههای زمینه در عمل، شناخت نحوهی کارکرد این توکنها اهمیت زیادی دارد.
نحوهی پردازش زبان توسط مدلهای زبانی بزرگ (LLM) با انسانها تفاوت اساسی دارد. در حالی که کوچکترین واحد اطلاعاتی که ما برای بازنمایی زبان استفاده میکنیم یک کاراکتر منفرد — مانند یک حرف، عدد یا علامت نگارشی — است، کوچکترین واحد زبانی که مدلهای هوش مصنوعی به کار میبرند یک توکن است.
برای آموزش یک مدل جهت درک زبان، به هر توکن یک شمارهی شناسه (ID) اختصاص داده میشود؛ برای آموزش مدل، بهجای کلمات یا حتی خودِ توکنها، از همین شمارههای شناسه استفاده میشود. این فرآیند توکنسازیِ زبان، توان پردازشی مورد نیاز برای پردازش متن و یادگیری از آن را بهطور چشمگیری کاهش میدهد.
میزان متنی که یک توکن میتواند نمایش دهد دارای تنوع بسیار زیادی است: یک توکن میتواند نمایندهی یک کاراکتر منفرد، بخشی از یک کلمه (مانند پسوند یا پیشوند)، یک کلمهی کامل یا حتی یک عبارت کوتاه چندکلمهای باشد. به نقشهای متفاوتی که حرف «a» در مثالهای زیر ایفا میکند توجه کنید:
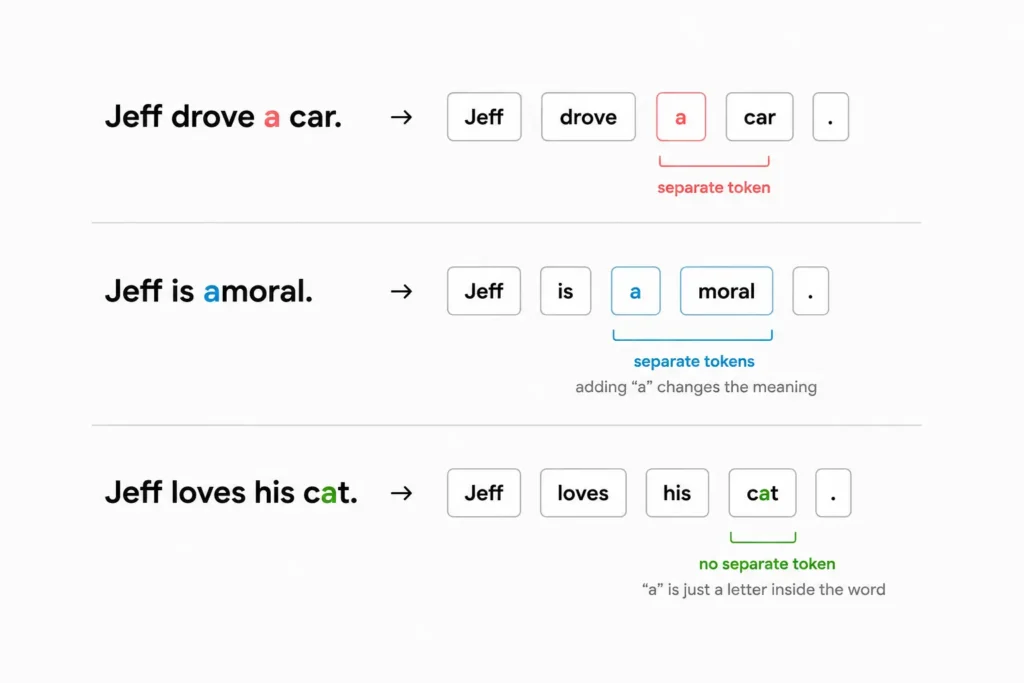
- «Jeff drove a car.»در اینجا، حرف «a» یک کلمهی کامل است. در این وضعیت، این حرف با یک توکن مجزا نمایش داده میشود.
- «Jeff is amoral.»در اینجا، حرف «a» یک کلمه نیست، اما افزودن آن به کلمهی moral معنای کلمه را بهشدت تغییر میدهد. بنابراین، کلمهی Amoral با دو توکن مجزا نمایش داده خواهد شد: یک توکن برای a و توکنی دیگر برای moral.
- «Jeff loves his cat.»در اینجا، حرف «a» صرفاً حرفی در درون کلمهی «cat» است. این حرف بهتنهایی هیچ معنای معنایی (Semantic) با خود حمل نمیکند و بنابراین نیازی نیست که با یک توکن مجزا نمایش داده شود.
هیچ «نرخ تبدیل» ثابت و مشخصی بین کلمه و توکن وجود ندارد و مدلها یا توکنسازهای مختلف — که زیرمجموعهای ماژولار از یک مدل بزرگتر و مسئولِ توکنسازی هستند — ممکن است یک متن واحد را به شکلهای متفاوتی توکنسازی کنند. توکنسازیِ کارآمد میتواند به افزایش حجمِ واقعیِ متنی که در محدوده و تنگنای یک پنجرهی زمینه جای میگیرد، کمک کند. اما برای اهداف عمومی، یک برآورد مناسب تقریباً معادلِ ۱.۵ توکن به ازای هر کلمه است.
تغییرات در ساختار زبانی و نحوهی بازنمایی در دادههای آموزشی میتواند باعث شود که برخی زبانها نسبت به سایرین به شکل کارآمدتری توکنسازی شوند. برای مثال، در یک مطالعه در اکتبر ۲۰۲۴، نمونهای بررسی شد که در آن یک جملهی واحد به دو زبان انگلیسی و تلوگو (Telugu) توکنسازی شده بود. با وجود اینکه ترجمهی تلوگو کاراکترهای بهمرکور کمتری نسبت به معادل انگلیسی خود داشت، اما تعداد توکنهای آن در زمینه بیش از ۷ برابر شد.
چه عواملی پنجره زمینه را پر میکنند؟
متن ورودی کاربر تنها چیزی نیست که فضای پنجره زمینه را اشغال میکند. برای مثال، در چتباتها معمولاً یک پرامپت سیستمی نیز وجود دارد که ممکن است از دید کاربر پنهان باشد و رفتار مدل و نحوهٔ پاسخگویی آن را تعیین کند. همچنین اطلاعات اضافی که از منابع خارجی برای تولید (RAG) دریافت میشود، هنگام استنتاج وارد پنجرهٔ زمینه میشود. کاراکترهای ویژه، خطهای جدید و سایر عناصر قالببندی نیز بخشی از ظرفیت موجود پنجرهٔ زمینه را مصرف میکنند.
در ادامه میبینیم که چه مواردی فضای درون یک پنجره زمینه را اشغال میکنند:
- درخواست یا سوال کاربر: آنچه پرسیده شده است.
- دستورالعملهای سیستمی: دستورات پنهانی که رفتار مدل را شکل میدهند (از چند دوجین تا چندین هزار توکن).
- تاریخچهی گفتگو: تکتک تبادلات قبلی در آن نوبت (session).
- اسناد بازیابیشده: محتوایی که از طریق RAG یا فراخوانی ابزارها به درون مدل کشیده شده است.
- خروجیِ ابزارها: نتایج حاصل از فراخوانیهای API، پرسوجوهای پایگاه داده، یا سایر عملکردهای ایجنت (Agent).
- پاسخِ خودِ مدل: که آن هم جزو موارد مصرفکننده و محدودکنندهی ظرفیت محسوب میشود.
چرا مدلها حداکثر طول زمینه دارند؟
اگرچه مفهوم پنجرهٔ زمینه بیشتر در ارتباط با LLMهایی مطرح میشود که برای خلاصهسازی، تولید متن و سایر وظایف پردازش زبان طبیعی استفاده میشوند، طول زمینه فقط به مدلهای زبانی محدود نیست. این مفهوم برای هر مدل یادگیری ماشینی مبتنی بر معماری ترنسفورمر اهمیت دارد؛ معماریای که در بیشتر مدلهای مولد هوش مصنوعی امروزی، از جمله تقریباً تمام LLMها، استفاده میشود.
مدلهای ترنسفورمر از سازوکاری به نام مکانیسم توجه (Self-Attention) استفاده میکنند تا ارتباطها و وابستگیهای میان بخشهای مختلف ورودی را محاسبه کنند؛ برای مثال، ارتباط میان کلماتی که در ابتدا و انتهای یک پاراگراف قرار دارند. از نظر ریاضی، این سازوکار برای هر توکن در یک دنبالهٔ متنی، مجموعهای از وزنها را محاسبه میکند که نشان میدهند آن توکن تا چه اندازه با سایر توکنهای موجود در دنباله مرتبط است.
یک LLM با شبکه عصبی بازگشتی(RNN) هنگام تولید هر توکن جدید، بهصورت تکرارشونده از این اطلاعات استفاده میکند. اندازهٔ پنجره زمینه تعیین میکند که مدل در هر لحظه حداکثر میتواند به چه تعداد توکن «توجه» داشته باشد.
پنجرههای زمینه و منابع محاسباتی
مجهز کردن یک مدل به یک پنجره زمینهی بزرگ با هزینهای همراه است. نیازهای محاسباتی با طول یک دنباله مقیاسِ مربعی پیدا میکنند؛ یعنی مثلا اگر تعداد توکنهای ورودی دو برابر شود، مدل برای مدیریت آن به ۴ برابر قدرت پردازشی نیاز دارد.
به همین ترتیب، افزایش طول زمینه نیز میتواند خروجیها را کندتر کند. هر بار که مدل بهصورت خودساخته توکن بعدی را در یک دنباله پیشبینی میکند، روابط بین آن توکن و تکتک توکنهای پیشین در آن دنباله را محاسبه میکند. فرآیند استنتاج ممکن است در ابتدای یک دنباله یا گفتگو نسبتاً سریع باشد، اما با افزایش طول زمینه بهتدریج کندتر شود. این موضوع برای کاربردهایی که به استنتاج تقریباً آنی در زمان واقعی نیاز دارند، مشکلساز است.
پیشرفتهای اخیر در میانگین طول زمینه برای مدلهای زبانی، تا حدی توسط تکنیکهای جدیدی میسر شده است که سرعت و کارایی استنتاج را به اندازهی کافی افزایش میدهند تا این معاوضهها و هزینههای ذاتی را بهخوبی جبران کنند. این تکنیکهای بهینهسازی به مدلهای زبانی بزرگِ مدرن، کوچک و متنباز اجازه دادهاند تا پنجرههای زمینهای ارائه دهند که بهطور تصاعدی بزرگتر از مدل اولیهی GPT-3.5 است؛ مدلی که چتجیپیتیِ OpenAI را در اواخر سال ۲۰۲۲ راهاندازی کرد.
چرا پنجره زمینه برای ایجنتهای هوش مصنوعی اهمیت دارند؟
در یک تعامل ساده با یک چتبات، میزان استفاده از زمینه قابل پیشبینی است؛ کاربر سوالی میپرسد، مدل پاسخ میدهد و تبادل به پایان میرسد. پنجره زمینه تعیین میکند که مدل در هر مرحله با چه مقدار اطلاعات میتواند کار کند؛ و در یک تبادل تکمرحلهای، این موضوع بهندرت مشکلساز میشود.
هنگامی که یک ایجنت هوش مصنوعی یک وظیفهی چندمرحلهای (مانند پرسوجو از پایگاههای داده، فراخوانی APIها، و استدلال روی نتایج میانی) را اجرا میکند، هر مرحله به حجم زمینه اضافه میکند. یک روند کاری ۵۰ مرحلهای که در آن هر فراخوانی مدل زبانی ۲۰,۰۰۰ توکن مصرف میکند، به معنای ۱,۰۰۰,۰۰۰ توکن زمینه کل در طول آن وظیفه است. اگر ایجنت نیاز داشته باشد که در مراحل بعدی به نتایج اولیه رجوع کند، زمینه نهتنها در طول فراخوانیهای مختلف، بلکه درون خود پنجره نیز انباشته میشود.
این دقیقاً همان نقطهای است که پنجره زمینه از یک مشخصهی فنیِ انتزاعی به یک محدودیتِ واقعی در محیط تولید (Production) تبدیل میشوند که پیامدهای جدی به همراه دارد. هنگامی که پنجره در میانهی روند کاری پر میشود، ایجنت متوقف نمیشود تا به شما اطلاع دهد؛ بلکه با هرآنچه از اطلاعات باقی مانده است به کار خود ادامه میدهد. و احتمال دارد هرآنچه باقی مانده، شامل اطلاعاتی نباشد که ایجنت برای گرفتن تصمیم درست به آن نیاز دارد.
اندازه پنجره زمینه در مدلهای بزرگ
پنجرههای زمینه بهطور چشمگیری رشد کردهاند. مدل اولیهی GPT-3.5 که در اواخر سال ۲۰۲۲ چتجیپیتی را راهاندازی کرد، دارای محدودیت ۴,۰۹۶ توکنی بود. مدلهای پیشرو و امروزیِ هوش مصنوعی از صدها هزار یا حتی میلیونها توکن پشتیبانی میکنند.
| مدل | حداکثر ظرفیت |
|---|---|
| GPT-5.4 (OpenAI) | ۱,۰۵۰,۰۰۰ توکن (~۷۸۸,۰۰۰ کلمه) |
| Claude Opus 4.6 (Anthropic) | ۱,۰۰۰,۰۰۰ توکن (~۷۵۰,۰۰۰ کلمه) |
| Gemini 2.5 Pro (Google) | ۱,۰۰۰,۰۰۰ توکن (~۷۵۰,۰۰۰ کلمه) |
| Llama 4 Scout (Meta) | ۱۰,۰۰۰,۰۰۰ توکن (~۷,۵۰۰,۰۰۰ کلمه) |
| Mistral Large 3 | ۲۵۶,۰۰۰ توکن (~۱۹۲,۰۰۰ کلمه) |
پنجرههای زمینهی بزرگتر مزایای واقعی به همراه دارند. آنها به مدلها اجازه میدهند انسجام خود را در طول گفتگوهای طولانیتر حفظ کنند، با ارجاع به اطلاعات بیشتر پاسخهای دقیقتری تولید کنند، و با استناد به مواد منبعِ بیشتر، توهمات را کاهش دهند.
البته طولِ زمینهی بیشتر بهطور خودکار به معنای عملکرد بهتر نیست. زمینهی بیشتر، محاسباتِ بیشتری، هزینهی بالاتری و فرصتهای بیشتری را برای گیج شدن مدل توسط اطلاعات نامربوط ایجاد میکند.
نکته مهم
سؤالِ پیش روی متخصصان این نیست که «کدام مدل بزرگترین پنجره را دارد؟»، بلکه این است که «چه چیزی باید برای این کار درون پنجره قرار گیرد و چگونه بقیه موارد را بیرون نگه دارم؟»
چالشهای پنجرههای زمینهی بزرگ
حتی زمانی که اقدامات مناسب برای جبران هزینهها در نیازهای محاسباتی و سرعت پردازش انجام شود، افزایش محدودیت طول زمینهی مدل، چالشها و پیچیدگیهای بیشتری را به همراه دارد.
چالشهای عملکردی
مانند انسانها، مدلهای زبانی بزرگ (LLM) نیز ممکن است با حجم زیادی از جزئیات اضافی غرق شوند. آنها همچنین ممکن است تنبلی کنند و میانبرهای شناختی را انتخاب کنند. مقالهای در سال ۲۰۲۳ نشان داد که «مدلهای زبانی بزرگ از اطلاعات موجود در زمینههای ورودی طولانی بهطور قابلاتکا استفاده نمیکنند.». بهطور خاصتر، نویسندگان مشاهده کردند که مدلها زمانی بهترین عملکرد را دارند که اطلاعات مربوطه در ابتدا یا انتهای زمینهی ورودی قرار داشته باشد. آنها همچنین مشاهده کردند که وقتی مدل مجبور است اطلاعات موجود در میانیِ زمینههای طولانی را بهدقت بررسی کند، عملکردش افت میکند.
روشهای نوین برای بهبود کاراییِ مکانیسم توجه (Self-attention) در ترنسفورمر، مانند rotary position embedding ، با هدف اصلاح رمزگذاری موقعیتی توکنها در بردارهای توجه عمل میکنند. بهکارگیری گستردهی روشهای مبتنی بر RoPE باعث بهبود عملکرد و سرعت در وظایفی شده است که شامل توکنهایی با فاصلهی زیاد از یکدیگر هستند.
پژوهشهای در حال انجام منجر به تولید تعدادی بنچمارک شده است که برای سنجش توانایی یک مدل زبانی بزرگ در یافتن و استفادهی مؤثر از اطلاعات مرتبط در متون حجیم طراحی شدهاند؛ از جمله آزمونهای سوزن در انبار کاه (NIAH)، رولر (RULER) و لانگبنچ (LongBench).
چالشهای ایمنی و امنیت سایبری
پنجرهی زمینهی طولانیتر ممکن است پیامد ناخواستهی دیگری نیز داشته باشد و سطح حملهی طولانیتری را برای دستورات خصمانه فراهم کند. پژوهشهای اخیر شرکت انتروپیک (Anthropic) نشان داد که افزایش طول زمینهی یک مدل، آسیبپذیری آن را در برابر فرار از زندان و در نتیجه تحریک مدل برای تولید پاسخهای مضر — افزایش میدهد.
منابع: