
واژهنامه · فنی
پردازش زبان طبیعی (NLP) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
زیرشاخهای از علوم کامپیوتر و هوش مصنوعی (AI) است که با استفاده از یادگیری ماشین، کامپیوترها را قادر میسازد زبان انسان را درک کرده و با آن ارتباط برقرار کنند.
پردازش زبان طبیعی (NLP) با ترکیب زبانشناسی محاسباتی، مدلسازی مبتنی بر قاعده زبان انسان، مدلسازی آماری، یادگیری ماشین و یادگیری عمیق، کامپیوترها و دستگاههای دیجیتال را قادر میسازد تا متن و گفتار را تشخیص، درک و تولید کنند.
تحقیقات NLP به فعال شدن عصر هوش مصنوعی مولد، از مهارتهای ارتباطی مدلهای زبانی بزرگ (LLM) گرفته تا توانایی مدلهای تولید تصویر برای درک درخواستها، کمک کرده است. NLP در حال حاضر بخشی از زندگی روزمره بسیاری از افراد است، موتورهای جستجو را تقویت میکند، چتباتها را برای خدمات مشتری با دستورات گفتاری، سیستمهای GPS با عملکرد صوتی و دستیارهای دیجیتال پرسش و پاسخ در تلفنهای هوشمند مانند الکسای آمازون، سیری اپل و کورتانا مایکروسافت، به کار میگیرد.
پردازش زبان طبیعی (NLP) همچنین نقش رو به رشدی در راهکارهای سازمانی ایفا میکند که به سادهسازی و خودکارسازی عملیات تجاری، افزایش بهرهوری کارکنان و سادهسازی فرآیندهای تجاری کمک میکنند.
تاریخچه پردازش زبان طبیعی (NLP) در سامانههای هوشمند
پیشفرض NLP نمادین اغلب با استفاده از آزمایش فکری «اتاق چینی» جان سرل تصویر میشود: با داشتن مجموعهای از قوانین (مانند یک کتاب عبارتپردازی چینی با سؤالات و پاسخهای متناظر)، کامپیوتر با اعمال آن قوانین بر روی دادههای دریافتی، درک زبان طبیعی (یا سایر وظایف NLP) را شبیهسازی میکند.
دهه ۱۹۵۰: آزمایش جورجتاون در سال ۱۹۵۴ شامل ترجمه کاملاً خودکار بیش از شصت جمله روسی به انگلیسی بود. نویسندگان ادعا کردند که ظرف سه یا پنج سال، ترجمه ماشینی به یک مسئله حلشده تبدیل خواهد شد. با این حال، پیشرفت واقعی بسیار کندتر بود و پس از انتشار گزارش ALPAC در سال ۱۹۶۶ — که نشان داد ده سال تحقیق نتوانسته انتظارات را برآورده کند — بودجه مربوط به ترجمه ماشینی به شدت کاهش یافت.
دهه ۱۹۶۰: سیستمهایی مانند SHRDLU و ELIZA موفقیت چشمگیری داشتند. ELIZA با وجود استفاده از حداقل اطلاعات درباره تفکر انسانی، قادر بود تعاملاتی شبیه به انسان ایجاد کند.
دهه ۱۹۷۰: بسیاری از برنامهنویسان شروع به نوشتن «هستیشناسیهای مفهومی» کردند که اطلاعات دنیای واقعی را به دادههای قابل درک برای کامپیوتر ساختار میدادند. در این دوره اولین چتباتها (مثل PARRY) نوشته شدند.
دهه ۱۹۸۰: دهههای ۱۹۸۰ و اوایل دهه ۱۹۹۰ دوران اوج روشهای نمادین در NLP بود. حوزههای تمرکز شامل تحقیق روی تجزیه مبتنی بر قاعده، واژهشناسی، معناشناسی و ارجاع بود.
دهه ۱۹۹۰: موفقیتهای اولیه در روشهای آماری (مانند مدلهای همترازی IBM) به دلیل استفاده از پیکرههای متنی بزرگ (مثل اسناد پارلمان کانادا و اتحادیه اروپا) حاصل شد.
دهه ۲۰۰۰: با رشد وب، تحقیقات بر روی الگوریتمهای یادگیری بدون نظارت و نیمهنظارتی متمرکز شد. اگرچه این کار دشوارتر است، اما دسترسی به مقادیر عظیم دادههای وب این ضعف را جبران کرد.
سال ۲۰۰۳: مدل ان-گرام کلمه (word n-gram model) توسط مدل پرسپترون چندلایه بنژیو و همکاران عملکردش پشت سر گذاشته شد.
سال ۲۰۱۰ و پس از آن: توماش میکولوف با معرفی Word2Vec و استفاده از شبکههای عصبی بازگشتی (RNN) مسیر را برای یادگیری عمیق هموار کرد. در دهه ۲۰۱۰، روشهای یادگیری بازنمایی و شبکههای عصبی عمیق فراگیر شدند. این پیشرفتها اکنون در پزشکی و تحلیل پروندههای الکترونیک سلامت برای بهبود مراقبت از بیمار اهمیت حیاتی دارند.

مزایای پردازش زبان طبیعی (NLP)
پردازش زبان طبیعی (NLP) با فراهم کردن امکان برقراری ارتباط و همکاری با ماشینها به زبان طبیعی انسانی که هر روز از آن استفاده میکنند، ارتباط و همکاری انسانها با ماشینها را آسانتر میکند. این امر مزایایی را در بسیاری از صنایع و برنامهها ارائه میدهد.
- خودکارسازی وظایف تکراری
- بهبود تحلیل دادهها و بینشها
- جستجوی پیشرفته، تولید محتوا
یادگیری عمیق NLP
اخیراً، مدلهای یادگیری عمیق با استفاده از حجم عظیمی از دادههای خام و بدون ساختار، چه متنی و چه صوتی، برای دقیقتر شدن، به شیوه غالب پردازش زبان طبیعی (NLP) تبدیل شدهاند. یادگیری عمیق را میتوان به عنوان تکامل بیشتر پردازش زبان طبیعی آماری در نظر گرفت، با این تفاوت که از مدلهای شبکه عصبی استفاده میکند. چندین زیرشاخه از مدلها وجود دارد:
مدلهای توالی به توالی: این مدلها که بر اساس شبکههای عصبی بازگشتی (RNN) ساخته شدهاند، عمدتاً برای ترجمه ماشینی با تبدیل عبارتی از یک حوزه (مانند زبان آلمانی) به عبارت حوزه دیگر (مانند انگلیسی) مورد استفاده قرار گرفتهاند.
مدلهای تبدیلکننده: این مدلها از توکنسازی زبان (موقعیت هر کلمه یا زیرکلمات توکنی) و خودتوجهی (در نظر گرفتن وابستگیها و روابط) برای محاسبه رابطه بخشهای مختلف زبان با یکدیگر استفاده میکنند.
مدلهای ترانسفورماتور را میتوان با استفاده از یادگیری خودنظارتی در پایگاههای داده متنی عظیم، به طور مؤثر آموزش داد. نقطه عطفی در مدلهای ترانسفورماتور، نمایشهای رمزگذار دو طرفه گوگل از ترانسفورماتورها (BERT) بود که اساس عملکرد موتور جستجوی گوگل شد و همچنان نیز هست.
مدلهای خودهمبسته (Autoregressive models): این نوع مدل تبدیلکننده (transformer model) بهطور خاص برای پیشبینی کلمه بعدی در یک دنباله آموزش داده میشود که نشاندهنده جهش بزرگی در توانایی تولید متن است. نمونههایی از LLMهای خودهمبسته شامل GPT، Llama، Claude و Mistral متنباز هستند.
مدلهای بنیادی: مدلهای بنیادی از پیش ساخته شده و گزینش شده میتوانند سرعت شروع یک تلاش NLP را افزایش داده و اعتماد به عملکرد آن را افزایش دهند. آنها از وظایف پردازش زبان طبیعی (NLP) از جمله تولید محتوا و استخراج بینش پشتیبانی میکنند. علاوه بر این، آنها تولید افزوده بازیابی را تسهیل میکنند، چارچوبی برای بهبود کیفیت پاسخ با پیوند دادن مدل به منابع خارجی دانش. این مدلها همچنین تشخیص موجودیتهای نامگذاری شده را انجام میدهند که شامل شناسایی و استخراج اطلاعات کلیدی در یک متن است.
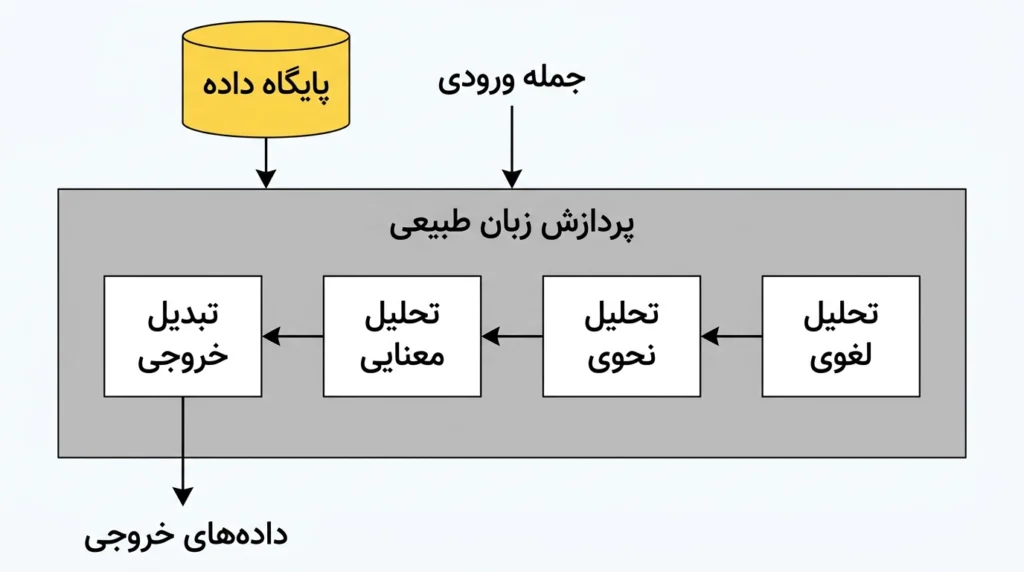
وظایف پردازش زبان طبیعی
چندین وظیفه NLP معمولاً به پردازش دادههای متنی و صوتی انسان به روشهایی کمک میکنند که به کامپیوتر کمک میکند تا آنچه را که مصرف میکند، درک کند. برخی از این وظایف عبارتند از:
- تفکیک هم مرجعی
- تشخیص موجودیتهای نامدار
- برچسبگذاری اجزای کلام
- ابهامزدایی معنای کلمه
تشخیص منبع
این وظیفه شناسایی این است که آیا و چه زمانی دو کلمه به یک موجودیت اشاره میکنند. رایجترین مثال، تعیین شخص یا شیئی است که یک ضمیر خاص به آن اشاره میکند(such as “she” = “Mary). اما همچنین میتواند یک استعاره یا اصطلاح را در متن شناسایی کند (such as an instance in which “bear” isn’t an animal, but a large and hairy person).
تشخیص موجودیتهای اسمی (NER)
NER کلمات یا عبارات را به عنوان موجودیتهای مفید شناسایی میکند. NER «لندن» را به عنوان یک مکان یا «ماریا» را به عنوان نام یک شخص شناسایی میکند.
برچسبگذاری نقش کلمات
این فرآیند که برچسبگذاری دستوری نیز نامیده میشود، فرآیندی است که بر اساس کاربرد و زمینه، مشخص میکند یک کلمه یا متن متعلق به کدام بخش از گفتار است. برای مثال، بخش گفتار، کلمه «make» را به عنوان فعل در جمله «I can make a paper plane» و به عنوان اسم در جمله «What brand of car do you own؟» شناسایی میکند.
نحوه کار پردازش زبان طبیعی
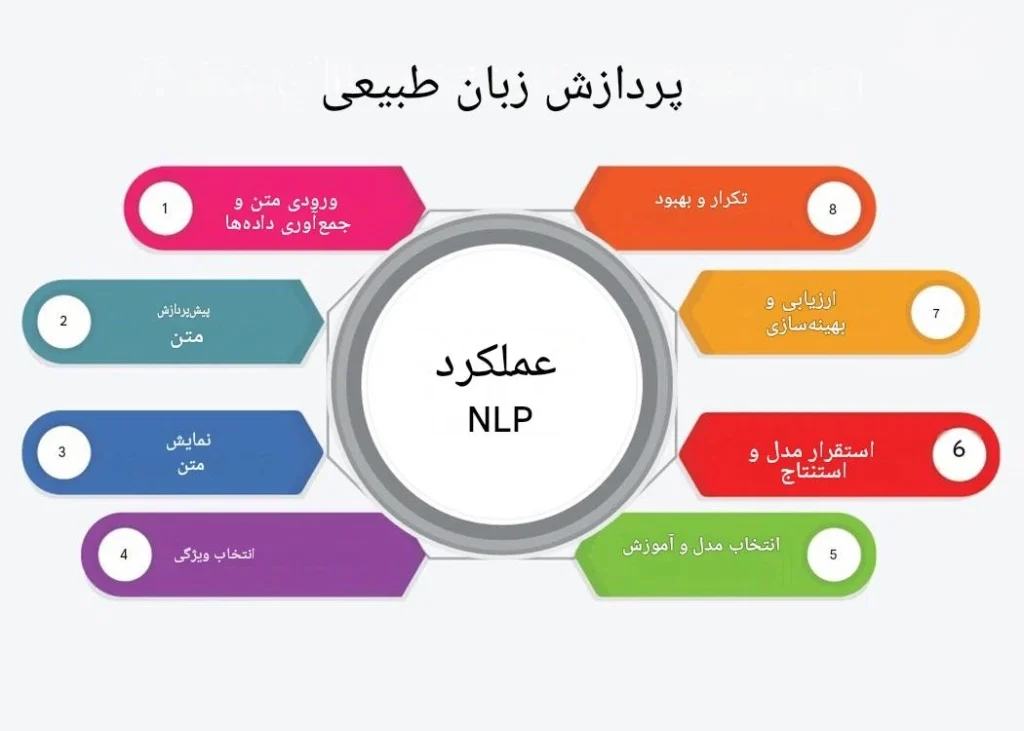
پردازش زبان طبیعی (NLP) با ترکیب تکنیکهای محاسباتی مختلف برای تجزیه و تحلیل، درک و تولید زبان انسانی به روشی که ماشینها بتوانند پردازش کنند، کار میکند. در اینجا مروری بر یک خط لوله معمولی پردازش زبان طبیعی و مراحل آن آورده شده است:
- پیشپردازش متن
- استخراج ویژگی
- تحلیل متن
- آموزش مدل

چالشهای NLP
حتی مدلهای پیشرفتهی پردازش زبان طبیعی (NLP) نیز بینقص نیستند، همانطور که گفتار انسان مستعد خطا است. همانند هر فناوری هوش مصنوعی، پردازش زبان طبیعی (NLP) نیز با مشکلات بالقوهای همراه است. زبان انسان پر از ابهاماتی است که نوشتن نرمافزاری را که به طور دقیق معنای مورد نظر دادههای متنی یا صوتی را تعیین کند، برای برنامهنویسان دشوار میکند.یادگیری زبان انسان ممکن است سالها طول بکشد و بسیاری از آنها هرگز از یادگیری دست نمیکشند. اما در این صورت برنامهنویسان باید به برنامههای کاربردی مبتنی بر زبان طبیعی آموزش دهند تا بینظمیها را تشخیص داده و درک کنند تا برنامههای آنها دقیق و مفید باشند. خطرات مرتبط ممکن است شامل موارد زیر باشد:
.
آموزش جهتدهیشده
همانند هر عملکرد هوش مصنوعی، دادههای جانبدارانهای که در آموزش استفاده میشوند، پاسخها را منحرف میکنند. هرچه کاربران یک عملکرد NLP متنوعتر باشند، این خطر بیشتر میشود، مانند خدمات دولتی، مراقبتهای بهداشتی و تعاملات منابع انسانی. به عنوان مثال، مجموعه دادههای آموزشی که از وب استخراج میشوند، مستعد جانبداری هستند.
تفسیر نادرست
همانند برنامهنویسی، خطر ورودی بیکیفیت، خروجی بیکیفیت (GIGO) وجود دارد. تشخیص گفتار، که با نام گفتار به متن نیز شناخته میشود، وظیفه تبدیل قابل اعتماد دادههای صوتی به دادههای متنی را بر عهده دارد. اما اگر ورودی گفتاری با گویشی نامفهوم، نامفهوم، پر از اصطلاحات عامیانه، همنام، دستور زبان نادرست، اصطلاحات، قطعات، تلفظهای نادرست، انقباضات یا ضبط شده با نویز پسزمینه زیاد باشد، راهحلهای NLP میتوانند گیجکننده شوند.
واژگان جدید
کلمات جدید دائماً در حال اختراع یا وارد شدن هستند. قراردادهای دستور زبان میتوانند تکامل یابند یا عمداً شکسته شوند. در این موارد، NLP میتواند یا بهترین حدس را بزند یا بپذیرد که مطمئن نیست و در هر صورت، این امر باعث ایجاد پیچیدگی میشود.
لحن صدا
وقتی افراد صحبت میکنند، بیان کلامی یا حتی زبان بدن آنها میتواند معنای کاملاً متفاوتی نسبت به کلمات به تنهایی ارائه دهد. اغراق برای تأثیرگذاری، تأکید بر کلمات برای اهمیت یا کنایه میتواند توسط NLP اشتباه گرفته شود و تحلیل معنایی را دشوارتر و غیرقابل اعتمادتر کند.
موارد استفاده از NLP بر اساس صنعت
کاربردهای پردازش زبان طبیعی (NLP) اکنون تقریباً در هر صنعتی یافت میشود.
امور مالی
در معاملات مالی، نانوثانیهها میتوانند تفاوت بین موفقیت و شکست را هنگام دسترسی به دادهها یا انجام معاملات یا معاملات ایجاد کنند. پردازش زبان طبیعی (NLP) میتواند استخراج اطلاعات از صورتهای مالی، گزارشهای سالانه و نظارتی، انتشار اخبار یا حتی رسانههای اجتماعی را سرعت بخشد.
بهداشت و درمان
بینشها و پیشرفتهای جدید پزشکی میتوانند سریعتر از آنچه بسیاری از متخصصان مراقبتهای بهداشتی میتوانند با آن همگام شوند، از راه برسند. ابزارهای مبتنی بر NLP و هوش مصنوعی میتوانند به سرعت بخشیدن به تجزیه و تحلیل سوابق سلامت و مقالات تحقیقاتی پزشکی کمک کنند، تصمیمات پزشکی آگاهانهتری را ممکن سازند یا در تشخیص یا حتی پیشگیری از بیماریهای پزشکی یاری رسانند.
بیمه
پردازش زبان طبیعی (NLP) میتواند ادعاها را تجزیه و تحلیل کند تا الگوهایی را پیدا کند که میتوانند زمینههای نگرانی را شناسایی کرده و ناکارآمدیها را در پردازش ادعاها پیدا کنند و منجر به بهینهسازی بیشتر پردازش و تلاشهای کارکنان شوند.
قانونی
تقریباً هر پرونده حقوقی ممکن است نیاز به بررسی انبوهی از مدارک، اطلاعات پیشینه و سوابق قانونی داشته باشد. پردازش زبان طبیعی (NLP) میتواند به خودکارسازی کشف اسناد حقوقی، سازماندهی اطلاعات، سرعت بخشیدن به بررسی و اطمینان از ثبت تمام جزئیات مربوطه برای بررسی کمک کند.