
در ۸ سپتامبر ۲۰۲۶، OpenAI اعلام کرد که با بهکارگیری حدود ۱۰ هزار عامل هوش مصنوعی بهصورت همزمان، ۸۸ ساعت صرف تولید یک اثبات ریاضی ۱۶۶ صفحهای کرده بود. موضوع این اثبات، معادلات ناویر–استوکس بود؛ یکی از هفت مسئلهٔ هزاره که بیش از یک قرن است در برابر تلاش ریاضیدانان سراسر جهان مقاومت کرده است.
معادلات ناویر–استوکس از جمله مسائل مشهور ریاضیات هستند که برای حل آنها یک میلیون دلار جایزه تعیین شده است. مؤسسهٔ کلی (Clay Mathematics Institute) این جایزه را برای حل مسائل هزاره در نظر گرفته، اما تاکنون برای مسئلهٔ ناویر–استوکس پرداختی انجام نشده است. بااینحال، اینترنت تقریباً شش ساعت بعد از کنار خبر اثبات تولیدشده توسط OpenAI گذشت.
البته خبری با این بزرگی تنها 6 ساعت توجه رسانهها را به خود جلب کرد! خبرها با چنان سرعتی منتشر میشوند و مدلها با چنان سرعتی بزرگتر و توانمندتر میشوند که حتی پیشرفتهایی که تا چند سال پیش میتوانستند یک نقطهٔ عطف تاریخی محسوب شوند، خیلی زود در پسزمینه محو میشوند.
یک مدل مسائل مربوط به دینامیک سیالات را بررسی میکند، مدل دیگری با تریلیونها پارامتر از راه میرسد و همزمان، پژوهشگران مقالههایی منتشر میکنند که نشان میدهند بعضی از رفتارهای این سیستمها از نظر نظری آنقدرها هم ساده نیستند. برای فهمیدن اینکه این وضعیت دقیقاً به چه معناست، باید کمی عقبتر برویم.
بزرگتر شدن مدلهای هوش مصنوعی، خوب یا بد؟
در سال ۲۰۱۹، مقالهای منتشر شد که بیسروصدا یکی از فرضهای بنیادین یادگیری ماشین را زیر سؤال برد. فرض ساده بود: اگر مدل شما نسبت به دادههای آموزشی بیش از حد بزرگ باشد، مدل بهجای یادگیری الگوی واقعی دادهها، دادههای آموزشی را حفظ میکند. در نتیجه، وقتی آن را روی دادههای جدید آزمایش کنید، عملکردش افت خواهد کرد.
این ایده برای سالها بخشی از آموزش استاندارد یادگیری ماشین بود. وقتی مدلی بیش از حد با دادههای آموزشی متناسب شود، عملکرد آن روی دادههای جدید کاهش پیدا میکند؛ پدیدهای که معمولاً با عنوان overfitting شناخته میشود.
گاهی مدلهای بزرگ تر بازدهی بهتری دارند
میخائیل بلکین و همکارانش نشان دادند که این منحنی آنجایی که همه تصور میکردند، به پایان نمیرسد. آنها پدیدهای را مشاهده کردند که بعدها با عنوان «نزول دوگانه» (Double Descent) شناخته شد.
وقتی اندازهٔ مدل از یک نقطهٔ مشخص عبور میکند، خطای آن روی دادههای آزمایشی ابتدا افزایش پیدا میکند؛ درست همان چیزی که انتظار داریم. اما اگر مدل را باز هم بزرگتر کنید، خطا دوباره کاهش مییابد.
این یعنی مدلهای بسیار بزرگ میتوانند از مرحلهای عبور کنند که در آن به نظر میرسد بیشازحد بزرگ شدهاند و دوباره عملکرد بهتری روی دادههای جدید نشان دهند. در نتیجه، رابطهٔ میان اندازهٔ مدل و عملکرد آن بسیار پیچیدهتر از این تصور ساده است که «مدل بزرگتر، دادههای بیشتری را حفظ میکند».
راز شبکههای عصبی بزرگ؛ آیا درون آنها «بلیتهای برنده» پنهان است؟
اگر تعداد پارامترهای یک شبکهٔ عصبی را باز هم افزایش دهید و از نقطهای که مدل بیشازحد بزرگ به نظر میرسد عبور کنید، اتفاق غیرمنتظرهای رخ میدهد. خطای مدل دوباره کاهش پیدا میکند و مدل میتواند الگوهای موجود در دادههای جدید را بهتر تشخیص دهد.
در سال ۲۰۱۹، جاناتان فرنکل و مایکل کارلین نظریهای را با عنوان «فرضیهٔ بلیت بختآزمایی» (Lottery Ticket Hypothesis) مطرح کردند. از نگاه آنها، شبکههای عصبی بزرگ صرفاً به این دلیل عملکرد خوبی ندارند که بزرگاند؛ بلکه درون این شبکههای عظیم، زیرشبکههای کوچکتری وجود دارد که از همان ابتدای مقداردهی اولیه، ساختار مناسبی برای یادگیری پیدا کردهاند.
«بلیتهای برنده» چه هستند؟
فرنکل و کارلین این زیرشبکهها را «بلیتهای برنده» (Winning Tickets) نامیدند. برای درک این ایده میتوان یک شبکهٔ عصبی بسیار بزرگ را شبیه قرعهکشیای با میلیاردها بلیت در نظر گرفت.
شبکه الزاماً به این دلیل قدرتمند نیست که تمام این بلیتها مفیدند. با افزایش تعداد بلیتها، احتمال پیدا شدن یک زیرشبکهٔ مناسب بیشتر میشود؛ زیرشبکهای که بتواند الگوی زیربنایی دادهها را یاد بگیرد، نه اینکه صرفاً دادههای آموزشی را حفظ کند.
چرا مقیاسپذیری اهمیت دارد؟
این توانایی همان چیزی است که در یادگیری ماشین از آن با عنوان تعمیم یاد میشود؛ یعنی مدل بتواند الگوهای یادگرفتهشده را روی دادههای جدید هم به کار ببرد.
برای نمونه، GPT-3 دارای ۱۷۵ میلیارد پارامتر است، اما این به آن معنا نیست که تمام این پارامترها برای هر وظیفه به یک اندازه درگیر هستند. بخشهایی از یک مدل میتوانند در انجام یک وظیفهٔ مشخص نقش بسیار پررنگتری داشته باشند.
بنابراین، اندازهٔ عظیم مدل لزوماً به معنای استفادهٔ همزمان از تمام ظرفیت آن نیست. مدل بزرگتر میتواند فضای بیشتری برای پیدا کردن مسیرهای مؤثرتر در اختیار سیستم قرار دهد.
Kimi K3 چگونه از تریلیونها پارامتر استفاده میکند؟
Kimi K3 در مجموع ۲.۸ تریلیون پارامتر دارد، اما برای هر توکن مشخص، فقط ۱۰۴ میلیارد پارامتر آن فعال میشوند. بخش باقیمانده در همان لحظه مورد استفاده قرار نمیگیرد و میتواند برای ورودیهای دیگر فعال شود.
از بیرون، چنین معماریای ممکن است شبیه هدررفت ظرفیت به نظر برسد. اما از نگاه معماری مدل، هدف دقیقاً برعکس است: مدل بهجای استفاده از تمام ظرفیت خود برای هر ورودی، تنها بخشهایی را فعال میکند که برای همان ورودی مناسبتر هستند.
Mixture of Experts چگونه کار میکند؟
Moonshot AI، Kimi K3 را بر پایهٔ معماری Mixture of Experts یا «ترکیبی از متخصصان» ساخته است. در این معماری، ۸۹۶ متخصص وجود دارد و برای هر توکن فقط ۱۶ متخصص انتخاب میشوند.
این انتخاب بهصورت پویا انجام میشود. یعنی مدل برای هر توکن و در هر مرحله تصمیم میگیرد کدام بخشهای شبکه باید وارد محاسبات شوند.
از این منظر، شباهت جالبی میان Kimi K3 و ایدهٔ بلیت بختآزمایی وجود دارد. در یک شبکهٔ عظیم، همهٔ مسیرها قرار نیست برای همهٔ ورودیها مفید باشند؛ سیستم باید بتواند از میان گزینههای متعدد، مسیرهایی را انتخاب کند که برای همان ورودی کاربرد بیشتری دارند.
چرا معماری kimi k3 مهم است؟
بزرگی مدل در اختیار سیستم باقی میماند، اما تمام این ظرفیت مجبور نیست برای هر توکن محاسبه شود. این رویکرد یکی از راههایی است که مدلهای بسیار بزرگ میتوانند از ظرفیت عظیم خود استفاده کنند، بدون اینکه هزینهٔ هر محاسبه مستقیماً متناسب با کل تعداد پارامترها افزایش پیدا کند.
اما حتی اگر بدانیم مدل از میان تعداد زیادی مسیر، برخی از آنها را انتخاب میکند، هنوز نمیدانیم این مسیرها دقیقاً چه چیزی را در خود ذخیره کردهاند. برای پاسخ به این سؤال، باید به مسئلهٔ دیگری برویم: برهمنهی.
مدلهای هوش مصنوعی واقعاً چه چیزی را در خود ذخیره میکنند؟
پژوهشگران MIT با بررسی «مسئلهٔ برهمنهی» (Superposition) سؤال متفاوتی مطرح کردند. بهجای اینکه بپرسند چرا مدلهای بزرگ کار میکنند، میخواستند بفهمند وقتی این مدلها کار میکنند، اطلاعات درون آنها چگونه ذخیره میشود.
یک ترنسفورمر با فضای embedding چهار هزار و چندصدبُعدی لزوماً فقط به همان تعداد مفهوم محدود نمیشود. پژوهشها نشان دادهاند که یک مدل میتواند تعداد بسیار بیشتری مفهوم را در فضایی با ابعاد محدود نمایش دهد.
وقتی مفاهیم روی هم قرار میگیرند
این اتفاق به این دلیل ممکن است که بازنماییهای مربوط به مفاهیم مختلف میتوانند تا حدی روی یکدیگر قرار بگیرند. میتوان آن را با دو سیگنال رادیویی مقایسه کرد که فرکانسهای نزدیک به یکدیگر دارند و هنگام قرار گرفتن روی هم، نوعی تداخل ایجاد میکنند.
در شبکهٔ عصبی نیز بازنماییهای مختلف میتوانند در فضای چندبعدی با یکدیگر همپوشانی داشته باشند و بخشی از ظرفیت یک فضا را بهصورت مشترک استفاده کنند.
برهمنهی شدید چه معنایی دارد؟
پژوهشگران این وضعیت را با مفهوم «برهمنهی شدید» (Strong Superposition) بررسی کردهاند. در این حالت، مدل میتواند تعداد بیشتری ویژگی را در فضایی با ابعاد کمتر از تعداد ویژگیها نمایش دهد، اما این کار هزینهای هم دارد: بازنماییها دیگر کاملاً مستقل از یکدیگر نیستند.
از نظر ریاضی، با افزایش تعداد ابعاد میتوان میزان این تداخل را کاهش داد. اما حذف کامل آن ممکن نیست. بنابراین، افزایش ظرفیت مدل میتواند مشکل را کاهش دهد، ولی اصل محدودیت همچنان وجود دارد.
آیا مدلهای هوش مصنوعی به یک سقف میرسند؟
هرچه مدلها بخواهند اطلاعات بیشتری را در خود جای دهند، مسئلهٔ برهمنهی پیچیدهتر میشود. توکنهای بیشتر، زمینهٔ طولانیتر و زنجیرههای استدلال طولانیتر به این معنا هستند که مدل باید اطلاعات بیشتری را در یک فضای محدود نمایش و پردازش کند.
این محدودیت لزوماً به شکل یک دیوار ناگهانی ظاهر نمیشود. مدلها ممکن است برای مدت طولانی با بزرگتر شدن، بهتر شوند، سپس سرعت پیشرفتشان کاهش پیدا کند و در نهایت به محدودهای برسند که افزایش بیشتر ظرفیت، سود کمتری ایجاد میکند.
ریاضیات جای دقیق سقف مدلهای AI را مشخص نمیکند
بااینحال، ریاضیات بهتنهایی نمیگوید این سقف دقیقاً کجاست. اینکه یک مدل برای یک وظیفهٔ مشخص در نهایت به عملکردی پایینتر یا بالاتر از انسان برسد، از این محدودیت نظری قابل استخراج نیست.
بنچمارکها میتوانند عملکرد فعلی مدلها را اندازهگیری کنند، اما نمیتوانند بهتنهایی جایگاه نهایی این سقف را مشخص کنند. ریاضیات میتواند وجود یک محدودیت را نشان دهد، بدون اینکه نقطهٔ دقیق آن را برای هر مدل و هر وظیفه تعیین کند.
Kimi K3 و زمینهٔ یکمیلیونتوکنی
پنجرهٔ زمینهٔ Kimi K3 برابر با ۱٬۰۴۸٬۵۷۶ توکن است؛ یعنی بیش از یک میلیون توکن. چنین ظرفیتی به مدل اجازه میدهد حجم بسیار بزرگی از اطلاعات را در یک زمینهٔ واحد پردازش کند.
اما وقتی تعداد اطلاعات ذخیرهشده و پردازششده افزایش پیدا میکند، مسئلهٔ تداخل میان بازنماییها نیز اهمیت بیشتری پیدا میکند. تفاوت میان چهار هزار توکن و یک میلیون توکن فقط تفاوتی در اندازه نیست؛ روابط بسیار بیشتری باید در یک زمینهٔ واحد مدیریت شوند.
FlashKDA چگونه مشکل پردازش متنهای بسیار طولانی را حل میکند؟
تیم معماری Moonshot AI، معماری FlashKDA را برای مدیریت سازوکار توجه (Attention) در دنبالههای بسیار طولانی طراحی کرده است. این معماری از روشی مبتنی بر کرنلهای محاسباتی استفاده میکند تا پردازش اطلاعات در متنهای طولانی با هزینهٔ محاسباتی قابلکنترلتری انجام شود.
هرچه طول متن و حجم اطلاعاتی که مدل باید همزمان پردازش کند بیشتر شود، محاسبات مربوط به Attention نیز پیچیدهتر و پرهزینهتر میشود. FlashKDA با هدف حل همین مشکل طراحی شده است: حفظ کارایی مدل هنگام پردازش زمینههای بسیار طولانی، بدون اینکه هزینهٔ محاسباتی بهسرعت افزایش پیدا کند.
مسئلهٔ فیزیکی همچنان باقی است
حل مسئلهٔ مهندسی به این معنا نیست که محدودیتهای بنیادی مربوط به نمایش اطلاعات از بین رفتهاند. مدل میتواند سریعتر و کارآمدتر اطلاعات طولانی را پردازش کند، اما همچنان باید این اطلاعات را در ساختار داخلی خود نمایش دهد.
برای دیدن تفاوت این دو مسئله، باید به مثال دیگری برگردیم: معادلات ناویر–استوکس. اینجا دیگر با یک مشکل معماری مواجه نیستیم، بلکه با یک مسئلهٔ ریاضی روبهرو هستیم که بیش از یک قرن است حل نشده باقی مانده است.
معادلات ناویر–استوکس چه مسئلهای را مطرح میکنند؟
معادلات ناویر–استوکس حرکت سیالات را توصیف میکنند؛ از حرکت آب درون لوله گرفته تا جریان هوا روی بال هواپیما و حرکت خون درون رگها. این معادلات مدتهاست در فیزیک و مهندسی مورد استفاده قرار میگیرند.
مسئلهٔ هزاره دربارهٔ این نیست که آیا معادلات ناویر–استوکس در عمل کار میکنند یا نه. مسئله این است که آیا برای شرایط مشخص، جوابهای این معادلات همیشه وجود دارند و آیا این جوابها همیشه هموار باقی میمانند.
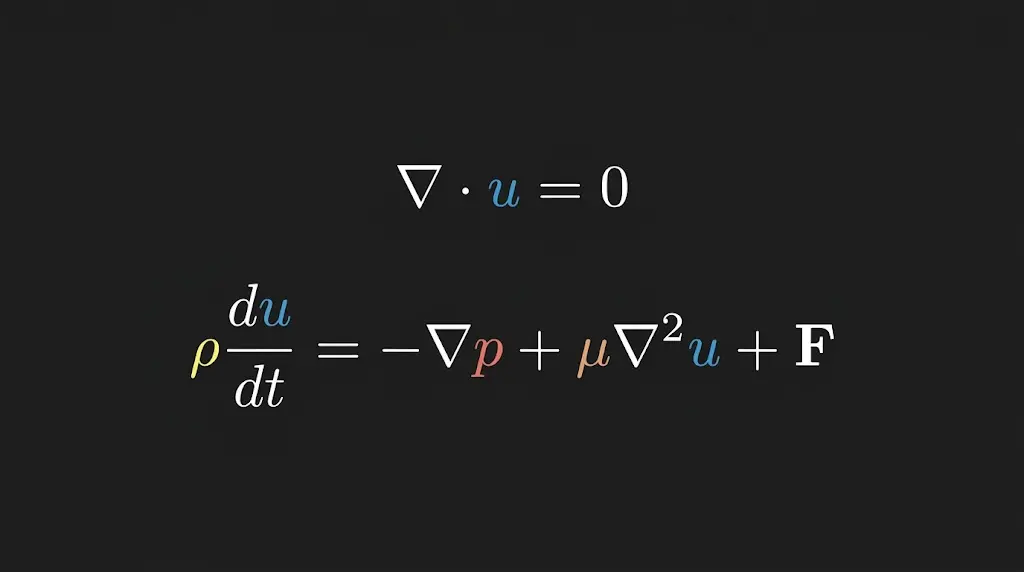
تکینگی(Singularity) چیست؟
یکی از نگرانیهای اصلی این است که آیا یک سیال میتواند بهطور خودبهخود در یک نقطه به رفتاری برسد که سرعت آن به سمت بینهایت میل کند. چنین نقطهای یک تکینگی (Singularity) محسوب میشود؛ جایی که ساختار ریاضی مورد استفاده برای توصیف سیستم دیگر رفتار منظم خود را حفظ نمیکند.
همین پرسش، یکی از مسائل عمیق ریاضیات مدرن است. به همین دلیل، تولید یک اثبات دربارهٔ بخشی از معادلات ناویر–استوکس میتواند از نظر علمی جالب باشد؛ اما برای ارزیابی اهمیت آن باید دقیقاً مشخص کنیم سیستم چه بخشی از مسئله را بررسی کرده است.
اثبات ۱۶۶ صفحهای OpenAI؛ آیا تولید اثبات به معنای فهمیدن آن است؟
سیستم OpenAI به چیزی پرداخت که ریاضیدانان آن را «مسئلهٔ دارای نیروی خارجی» مینامند؛ یعنی حالتهایی که در آن یک جملهٔ خارجی بهطور مداوم به سیال نیرو وارد میکند.
مسئلهٔ بدون نیروی خارجی، یعنی حالتهایی که در آن چنین نیرویی وجود ندارد، همچنان حلنشده باقی مانده است. این بخش همان چیزی است که معمولاً در بحث مسئلهٔ هزارهٔ ناویر–استوکس مورد توجه قرار میگیرد.
چرا «حل مسئلهٔ هزاره» تعبیر دقیقی نیست؟
بنابراین، تولید یک اثبات برای حالتهای دارای نیروی خارجی را نباید بدون توضیح بهعنوان حل کامل مسئلهٔ هزاره معرفی کرد. این دو مسئله با یکدیگر تفاوت دارند و بخش بدون نیروی خارجی همچنان نیازمند بررسی است.
بااینحال، چیزی که OpenAI نشان داد همچنان قابل توجه است. حدود ۱۰ هزار عامل هوش مصنوعی بهطور همزمان روی مسیرهای مختلف کار کردند و در نهایت یک متن ریاضی ۱۶۶ صفحهای تولید شد.
وقتی هزاران عامل روی یک مسئله کار میکنند
این ساختار، برخلاف کار یک عامل منفرد، بر تقسیم مسئله به مسیرهای متعدد و ترکیب نتایج آنها تکیه داشت. عاملهای مختلف میتوانستند مسیرهای متفاوتی را بررسی کنند و نتایج خود را در اختیار ساختار کلی قرار دهند.
اما همین معماری یک سؤال بنیادی ایجاد میکند: آیا تولید یک اثبات با فهمیدن آنچه اثبات میشود یکسان است؟
تولید اثبات در برابر فهم اثبات
عاملها میتوانستند ساختارهای ریاضی لازم را تولید کنند، مسیرهای مختلف را بررسی کنند و نتایج را با یکدیگر ترکیب کنند. اما این موضوع بهتنهایی نشان نمیدهد که سیستم همان مفهومی را که یک ریاضیدان انسانی از یک اثبات دارد، درک میکند.
مؤسسهٔ کلی نیز این اثبات را بررسی نکرده است و در نتیجه، تولید این متن بهخودیخود به معنای حل مسئلهٔ هزاره یا دریافت جایزهٔ یک میلیون دلاری نیست.
اهمیت اتفاق در جای دیگری قرار دارد: شاید یک سیستم هوش مصنوعی توانسته باشد یک استدلال ریاضی رسمی، طولانی و ساختاریافته تولید کند که بررسی کامل آن برای متخصصان انسانی زمان قابلتوجهی میطلبد.
معماری Kimi K3؛ از KDA تا کنترل جریان اطلاعات
Kimi K3 در ۶۹ لایه از مجموع ۹۳ لایهٔ خود از سازوکاری استفاده میکند که Moonshot AI آن را Knowledge-Dense Attention یا KDA مینامد. ۲۴ لایهٔ باقیمانده از نوع دیگری از attention به نام Gated Multi-head Latent Attention استفاده میکنند.
تفاوت مهم این طراحی در نحوهٔ کنترل جریان اطلاعات است. attention به مدل کمک میکند مشخص کند کدام بخشهای ورودی برای محاسبهٔ توکن فعلی اهمیت بیشتری دارند؛ اما سازوکار gated میتواند مرحلهٔ دیگری اضافه کند و مشخص کند کدام اطلاعات اجازه دارند در محاسبات بعدی جریان پیدا کنند.
چرا کنترل جریان اطلاعات مهم است؟
به زبان ساده، مسئله فقط این نیست که «کدام توکن مهم است؟». سؤال دیگر این است که وقتی اطلاعات یک توکن وارد محاسبه شد، کدام بخش از آن اطلاعات اجازه دارد روی مراحل بعدی تأثیر بگذارد.
این نوع کنترل میتواند در معماریهایی که باید زنجیرههای بسیار طولانی از اطلاعات را پردازش کنند اهمیت داشته باشد. یکی از اهداف چنین طراحیهایی کاهش نوعی «فروپاشی توجه» است؛ وضعیتی که ممکن است در استدلالهای بسیار طولانی رخ دهد و باعث شود اطلاعات مهم در میان حجم بزرگی از محاسبات گم یا کماثر شوند.
آیا KDA لزوماً استدلال را بهتر میکند؟
اینکه یک معماری برای یک مشکل طراحی شده باشد، با اثبات اینکه واقعاً در همهٔ وظایف استدلالی عملکرد بهتری دارد، یکسان نیست. برای مثال، هنوز سؤال متفاوتی وجود دارد: آیا چنین معماریای میتواند به یک مدل کمک کند خطاهای موجود در یک اثبات ۱۶۶ صفحهای را پیدا کند؟
پاسخ به این سؤال نیازمند آزمایش و ارزیابی مستقل است و صرفاً از ساختار معماری مدل به دست نمیآید.
مسئلهٔ تفسیرپذیری هوش مصنوعی چیست؟
فاصلهٔ میان چیزی که سیستمهای هوش مصنوعی تولید میکنند و چیزی که ما میتوانیم دربارهٔ چرایی آن توضیح دهیم، تمام داستانهای این مقاله را به یکدیگر مرتبط میکند.
فرضیهٔ بلیت بختآزمایی توضیحی نظری دربارهٔ نقش شبکههای بزرگ ارائه میدهد، اما لزوماً مشخص نمیکند که در یک مدل خاص و در یک لحظهٔ مشخص، دقیقاً کدام زیرشبکه نقش اصلی را ایفا میکند.
مدل چه چیزی را واقعاً در خود ذخیره کرده است؟
پژوهشهای مربوط به برهمنهی نیز میتوانند نشان دهند که مدل چگونه تعداد زیادی ویژگی را در فضای محدود نمایش میدهد. اما دانستن اینکه بازنماییها با یکدیگر همپوشانی دارند، با داشتن یک نقشهٔ کامل از مفاهیمی که مدل در خود ذخیره کرده است تفاوت دارد.
اینجاست که مسئلهٔ تفسیرپذیری (Interpretability) مطرح میشود. تفسیرپذیری تلاش میکند بفهمد درون یک مدل چه اتفاقی میافتد، کدام بخشهای آن در تولید یک خروجی نقش دارند و چگونه میتوان ارتباط میان ساختار داخلی مدل و رفتار قابل مشاهدهٔ آن را توضیح داد.
چرا بنچمارک کافی نیست؟
تعداد پارامترها یا امتیاز یک بنچمارک بهتنهایی پاسخ کاملی به پرسش «مدل چگونه به این نتیجه رسید؟» نمیدهد. حتی اگر خروجی مدل درست باشد، همچنان میتوان پرسید آیا میتوان مسیر رسیدن به آن خروجی را از درون مدل بازسازی و توضیح کرد یا نه.
پژوهشگران روشهای مختلفی برای تحلیل بازنماییهای داخلی، مسیرهای محاسباتی و ویژگیهای فعالشده در مدلها توسعه دادهاند، اما هیچ روش واحدی وجود ندارد که بتواند رفتار یک مدل بزرگ را بهطور کامل و شفاف توضیح دهد.
Kimi Code؛ عملکرد بالا بدون توضیح کامل دربارهٔ چرایی آن
Kimi Code، محصول برنامهنویسی Moonshot AI که بر پایهٔ K3 ساخته شده، نمونهٔ دیگری از همین فاصله است. این سیستم در ارزیابیهای مهندسی نرمافزار عملکرد بالایی نشان داده و خروجیهای آن برای بررسی درستی پاسخها ارزیابی شدهاند.
اما درست بودن خروجی، لزوماً توضیحی دربارهٔ سازوکار درونی مدل ارائه نمیکند. ممکن است یک مدل کدی تولید کند که کاملاً درست اجرا میشود، اما همچنان ندانیم کدام بازنماییها یا مسیرهای محاسباتی باعث شدهاند مدل دقیقاً به همان راهحل برسد.
پیچیدگی مدلهای AI فقط مختص Kimi نیست
این مسئله فقط به Kimi K3 یا Kimi Code مربوط نمیشود. هرچه مدلها قدرتمندتر میشوند، فاصلهٔ میان توانایی قابل مشاهدهٔ آنها و درک ما از سازوکار درونیشان بیشتر به چشم میآید.
مدل میتواند نتیجهای تولید کند که از نظر عملی مفید و حتی شگفتانگیز است، درحالیکه توضیح کامل فرایند درونی تولید آن نتیجه همچنان دشوار است.
هوش مصنوعی جعبه سیاه است!
Kimi K3 نشان میدهد که مدلها میتوانند با ترکیب تعداد بسیار زیادی پارامتر و فعال کردن تنها بخشی از آنها در هر مرحله، ظرفیت محاسباتی عظیمی در اختیار داشته باشند. معماریهایی مانند Mixture of Experts، روشهای attention و زیرساختهای توزیعشده کمک میکنند این مدلها در مقیاس بسیار بزرگ آموزش داده و اجرا شوند.
اما افزایش مقیاس بهتنهایی مسئلهٔ تفسیرپذیری را حل نمیکند. حتی اگر مدل بزرگتر شود، هنوز این پرسش پابرجاست که دقیقاً چه چیزی درون آن ذخیره شده، کدام مسیرها هنگام تولید یک پاسخ فعال شدهاند و چرا مدل در نهایت به یک نتیجهٔ مشخص رسیده است.
شاید عجیبترین ویژگی هوش مصنوعی مدرن همین باشد: ما هر روز بیشتر میتوانیم از این سیستمها بخواهیم، اما هنوز نمیتوانیم تمام جزئیات درونی فرایندی را که به پاسخ منجر میشود توضیح دهیم.
مدلها بزرگتر میشوند، معماریها پیچیدهتر میشوند و بنچمارکها یکی پس از دیگری جابهجا میشوند؛ اما فاصلهٔ میان «میدانیم چه خروجیای تولید شد» و «میدانیم چرا تولید شد» همچنان باقی است.
آزمایشگاههای هوش مصنوعی به سمت سقفی حرکت میکنند که ریاضیات محدودیتهایش را نشان میدهد، اما خود آن سقف هنوز دقیقاً مشخص نیست. هر بار که به نظر میرسد به یک محدودیت نزدیک شدهایم، معماری جدید، دادهٔ بیشتر یا روش محاسباتی تازهای مرز عملی سیستمها را جابهجا میکند.


دیدگاهتان را بنویسید