
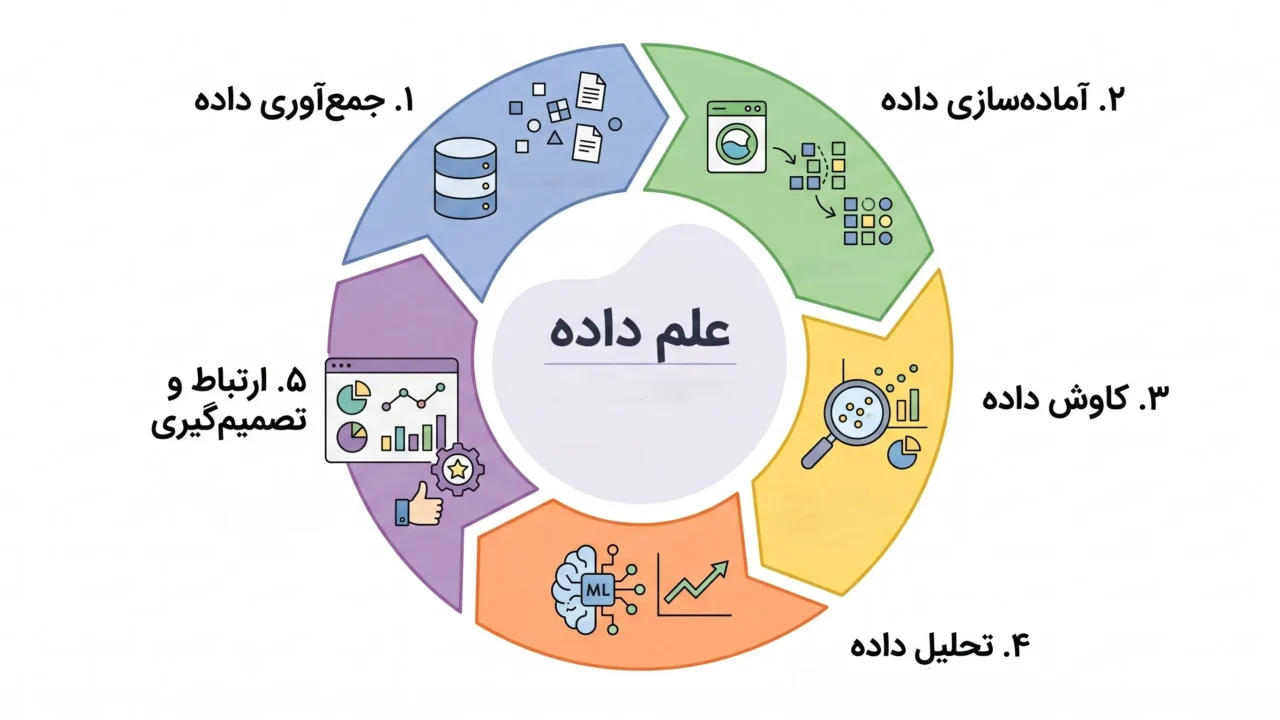
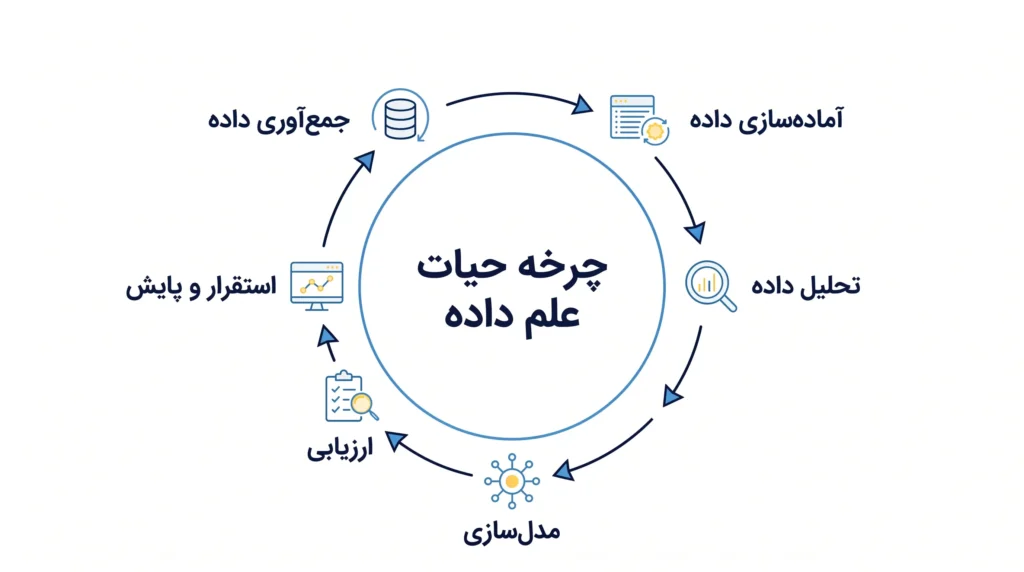
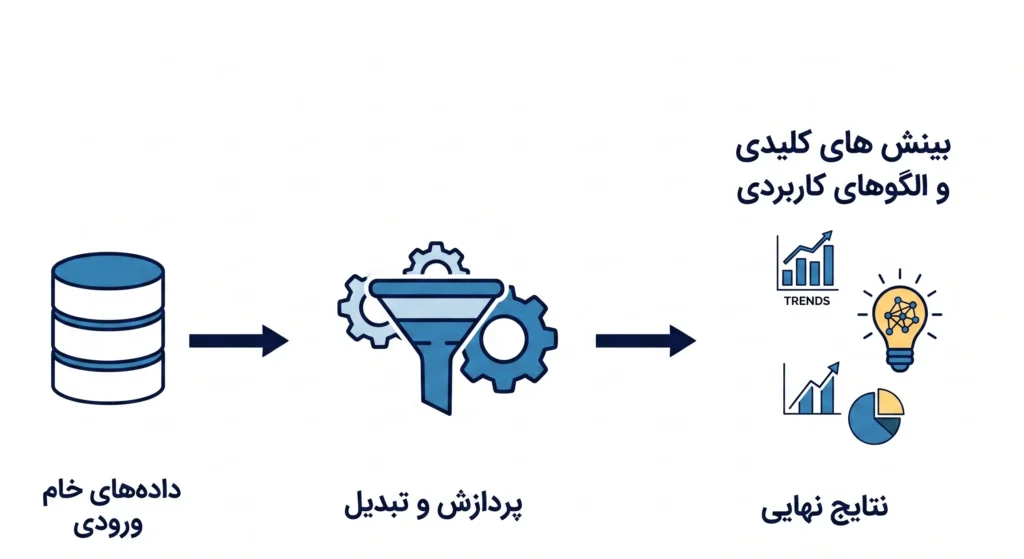
چرخه حیات علم داده(Data Science) برای ارائه یک راهحل، یافته یا محصول در پاسخ به یک مسئله یا فرضیه به کار میرود. هدف این چرخه، ایجاد چارچوبی استاندارد و تکرارپذیر (Repeatable Framework) به منظور تبدیل دادههای خام (Raw Data) به بینشهای کاربردی تجاری (Actionable Business Insights) است.
چرخه حیات علم داده از پنج مرحله اساسی زیر تشکیل شده است:
۱. جمعآوری داده
نخستین مرحله در چرخه حیات علم داده، مرحله «جمعآوری» (Capture) است که در واقع آغاز فرآیند گردآوری یا اکتساب دادهها (Data Collection/Acquisition) به شمار میرود. این مرحله شامل گردآوری دادههای خام (Raw Data) و دادههای ساختاریافته (Structured Data) از منابع گوناگون از جمله پایگاههای داده (Databases)، رابطهای برنامهنویسی کاربردی (APIs)، وب اسکرپینگ یا استخراج داده از وب (Web Scraping) و حسگرها (Sensors) است تا خط لوله علم داده (Data Science Pipeline) تغذیه شود.
فعالیتهای کلیدی در این مرحله:
- گردآوری یا اکتساب داده (Data collection/acquisition): تأمین داده از مجموعهدادههای خارجی (External Datasets)، لاگها (Logs) یا ارائهدهندگان شخص ثالث (Third-Party Providers).
- ورود داده (Data entry): وارد کردن دستی رکوردهای داده یا مشاهدات.
- دریافت سیگنال (Signal reception): جمعآوری دادههای بلادرنگ (Real-Time Data) یا جریانی (Streaming Data) از دستگاههای اینترنت اشیاء (IoT Devices) مانند آمازون اکو (Amazon Echo) و گوگل نست (Google Nest)، یا از طریق دورسنجی (Telemetry) نظیر دستگاههای بیسیم (Wireless Devices).
- استخراج داده (Data extraction): بیرون کشیدن دادهها بهطور مستقیم از سیستمهای سازمانی فعلی (Enterprise Systems)، رابطهای برنامهنویسی کاربردی (APIs) یا از طریق وب اسکرپینگ (Web Scraping).
۲. نگهداری و آمادهسازی داده
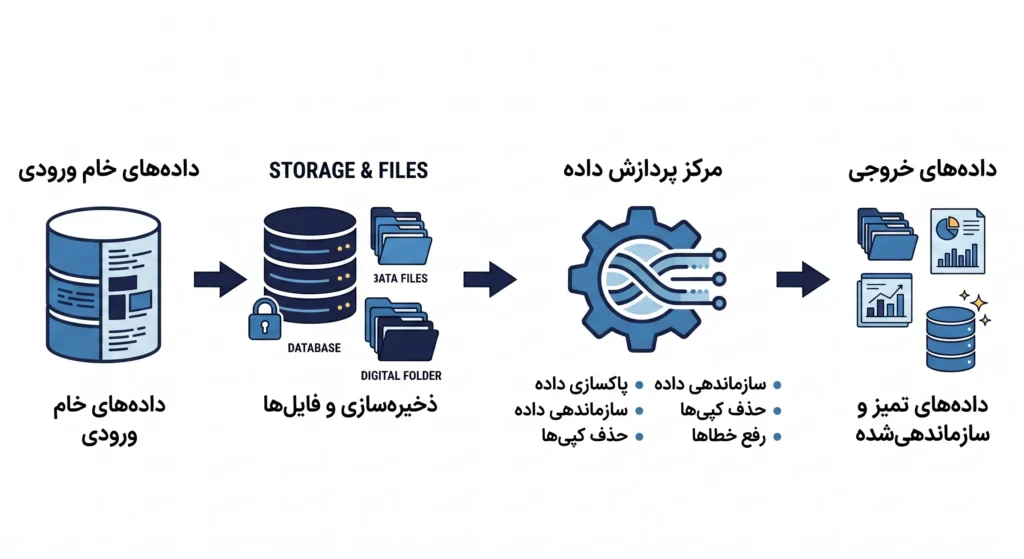
مرحله نگهداری (Maintain)، یعنی فرآیند تبدیل و آمادهسازی دادههای خام برای تحلیل، اغلب پرزحمتترین و زمانبرترین گام در چرخه حیات داده است؛ زیرا در این مرحله باید دادهها را برای سازگاری کامل با فرآیندهای تحلیلی دگرگون ساخت.
فعالیتهای کلیدی در این مرحله:
- انبارش داده (Data warehousing): گردآوری، ذخیرهسازی و مدیریت دادهها از منابع چندگانه در یک پایگاه داده مرکزی؛ مانند انبارهای داده ابری (Cloud Data Warehouses) نظیر آمازون ردشیفت (Amazon Redshift).
- پاکسازی داده (Data cleansing): شناسایی، اصلاح یا حذف دادههای نادرست، مخدوش یا تکراری از یک مجموعهداده (Dataset).
- ناحیه گذار داده (Data staging): آمادهسازی و قرار دادن دادههای خام در یک محیط ذخیرهسازی موقت یا پایگاه واسط (Staging Environment) پیش از انجام فرآیندهای پاکسازی، تبدیل و بارگذاری درون سیستم هدف.
- پردازش داده (Data processing): تمیزکاری، تبدیل و سازماندهی دادههای خام به شکلی که الگوریتمهای یادگیری ماشین (Machine Learning) و مدلهای آماری (Statistical Models) بتوانند آنها را به درستی تفسیر کنند.
- معماری داده (Data architecture): طراحی چارچوب گردآوری، ذخیرهسازی و ادغام دادهها، بهگونهای که دسترسی مدلهای یادگیری ماشین و ابزارهای تحلیل به دادههای پاک، قابلاتکا و مقیاسپذیر (Scalable) تضمین شود.
۳. پردازش و کاوش داده
هدف این مرحله، دستیابی به شناختی عمیق و تخصصی از دادهها از طریق کاوش الگوها (Patterns)، خوشهبندی نقاط داده برای مشاهده روندها و خلاصه کردن آنها در قالب آمارههای قابلفهم است. این گام نقشی حیاتی دارد تا دانشمندان داده به درکی بنیادین از دادههای خود دست یابند و بتوانند تحلیلهای بعدی را بهدرستی برنامهریزی کنند.
فعالیتهای کلیدی در این مرحله:
- دادهکاوی (Data mining): استخراج الگوهای پنهان، ناهنجاریها و روابط موجود در مجموعهدادههای عظیم، با هدف تبدیل دادههای خام به هوش تجاری کاربردی (Actionable Business Intelligence).
- خوشهبندی و طبقهبندی (Clustering/classification): با استفاده از رویکردهای یادگیری ماشین (Machine Learning)، خوشهبندی نقاط داده مشابه و بدون برچسب را گروهبندی میکند، در حالی که طبقهبندی، دادهها را به برچسبهای از پیشتعیینشده تخصیص میدهد.
- مدلسازی داده (Data modeling): ایجاد یک نمایش بصری از یک سیستم اطلاعاتی یا بخشهایی از آن برای نشان دادن ارتباطات میان نقاط و ساختارهای داده.
- خلاصهسازی داده (Data summarization): تبدیل مجموعهدادههای خام، پیچیده و حجیم به بینشهایی مدیریتپذیر که تفسیر آنها ساده باشد.
۴. تحلیل داده
هدف از مرحله تحلیل (Analyze) در چرخه حیات علم داده، استخراج بینشهای کاربردی، پردهبرداری از الگوهای پنهان و توسعه مدلهای پیشبینی (Predictive Models) است. این مرحله نقش پلی میان دادههای اولیه و تصمیمگیریهای آگاهانه را ایفا میکند و اطلاعات آمادهشده را به ارزشهای تجاری قابلاندازهگیری (Quantifiable Business Value) تبدیل مینماید.
فعالیتهای کلیدی در این مرحله:
- تحلیل اکتشافی و تاییدی (Exploratory/confirmatory): تولید فرضیهها از طریق بررسی دادهها به منظور یافتن الگوهای پنهان و در ادامه، اثبات یا رد آن فرضیهها.
- تحلیل پیشبینانه (Predictive analysis): بهرهگیری از دادههای تاریخی، یادگیری ماشین (Machine Learning) و الگوریتمهای آماری برای پیشبینی نتایج و روندهای آینده.
- رگرسیون (Regression): آموزش الگوریتمهای یادگیری ماشین جهت پیشبینی مقادیر عددی پیوسته (مانند میزان فروش، قیمتها و غیره) بر پایه دادههای پیشین.
- متنکاوی (Text mining): تبدیل متون بدون ساختار (نظیر ایمیلها، شبکههای اجتماعی و موارد مشابه) به فرمتهای ساختاریافته و ماشینخوان (Machine-Readable Formats) برای استخراج بینشهای عملیاتی یا آموزش مدلهای پیشبین.
- تحلیل کیفی (Qualitative analysis): استخراج بینشهای غیرعددی، رمزگشایی بافتار (Context) و درک حس و دیدگاه کاربران (User Sentiment).
۵. ارتباط و ارائه نتایج
واپسین مرحله از چرخه حیات علم داده، مرحله «ارتباط و ارائه» (Communicate) است؛ جایی که تمامی دادهها و یافتهها در برابر مخاطبان ارائه میشوند و خروجیهای فنی و پیچیده، به بینشهای تجاری قابلاجرا (Actionable Business Insights) ترجمه میگردند. در صورتی که خروجی پروژه شامل تحویل یک محصول باشد، این گام میتواند شامل ساخت یک پیشنمونه یا پروتوتایپ (Prototype) بر پایه تحلیل و مدلسازی دادهها نیز بشود.
فعالیتهای کلیدی در این مرحله:
- گزارشدهی داده (Data reporting): ترجمه یافتههای آماری به بینشهای ساده و قابلفهم، خلاصه گزارشهای مدیریتی (Executive Summaries) و مصورسازیهای تعاملی به منظور ارائه به ذینفعان (Stakeholders).
- مصورسازی داده (Data visualization): استفاده از عناصر دیداری نظیر نمودارها (Charts/Graphs) و نقشهها برای نمایش دادههای پیچیده؛ امکانی که به بینندگان اجازه میدهد الگوها، روندها و دادههای پرت (Outliers) را در یک نگاه شناسایی کنند.
- هوش تجاری (Business intelligence): ایجاد و اشتراکگذاری داشبوردهای هوش تجاری (BI Dashboards) برای پایش شاخصهای کلیدی عملکرد عملیاتی (Operational KPIs)، با هدف پردهبرداری از بینشها و کمک به تصمیمگیریهای مبتنی بر داده (Data-Driven Decisions).
- تصمیمگیری (Decision-making): تبدیل بینشهای تحلیلی به استراتژیهای عملیاتی کسبوکار، و همکاری با ذینفعان برای ارزیابی یافتهها و تعیین اقدامات و گامهای بعدی.
تکامل علم داده
اصطلاح «دانشمند داده» (Data Scientist) زمانی پدید آمد که شرکتها برای اولین بار نیاز به متخصصان دادهای را احساس کردند که در سازماندهی و تحلیل حجم عظیمی از دادهها مهارت داشته باشند. ده سال پس از پذیرش گسترده اینترنت در دنیای کسبوکار، هل آر. واریان (Hal R. Varian)، اقتصاددان ارشد گوگل، نخستین رئیس دانشکده اطلاعات دانشگاه برکلی کالیفرنیا (UC Berkeley School of Information) و استاد بازنشسته علوم اطلاعات، تجارت و اقتصاد در همین دانشگاه، اهمیت انطباقپذیری با اثرات فناوری و بازآرایی صنایع گوناگون را پیشبینی کرد.
دانشمند داده کیست و چه کاری انجام میدهد؟
دانشمندان داده، دادههای خام (Raw Data) را به ارزشهای ملموس در دنیای واقعی تبدیل میکنند. آنها دادههای پیچیده را مورد بررسی، پاکسازی و ساختاربندی قرار میدهند تا به سازمانها در اتخاذ تصمیمات بهینهتر و پیشبینی روندهای آینده یاری رسانند. برای تحقق این هدف، این متخصصان از زبانهای برنامهنویسی مانند پایتون (Python) و آر (R)، در کنار اسکیوال (SQL)، یادگیری ماشین (Machine Learning) و روشهای آماری بهره میبرند تا دادههای اولیه را به بینشهای کاربردی (Actionable Insights) تبدیل نمایند.
دانشمندان داده عموماً افرادی کنجکاو و نتیجهگرا هستند. آنها از دانش تخصصی و عمیق در صنایع مربوطه همراه با مهارتهای ارتباطی فوقالعاده برخوردارند؛ امری که به آنها امکان میدهد نتایج کاملاً فنی و پیچیده را برای همکاران غیرفنی خود تشریح کنند. این کارشناسان پیشینه کمیِ قدرتمندی در آمار کاربردی (Applied Statistics) و جبر خطی (Linear Algebra) دارند و با برخورداری از دانش برنامهنویسی با تمرکز بر انبارش داده (Data Warehousing)، دادهکاوی (Data Mining) و مدلسازی داده (Data Modeling)، به ساخت و تحلیل الگوریتمها میپردازند. از جمله ابزارهای فنی و کلیدی که توسط این متخصصان به طور مکرر مورد استفاده قرار میگیرد، میتوان به موارد زیر اشاره کرد:
| زبانهای برنامهنویسی (Coding Languages) |
دستکاری داده (Data Manipulation) |
یادگیری ماشین (Machine Learning) |
مصورسازی داده (Data Visualization) |
فناوریهای کلانداده (Big Data Technology) |
رایانش ابری (Cloud Computing) |
|---|---|---|---|---|---|
| آر (R) | پایگاههای داده نواسکیوال (NoSQL databases) | آپاچی پیگ (Apache Pig) | تبلو (Tableau) | آپاچی هادوپ (Apache Hadoop) | ایدبلیواِس (AWS) |
| پایتون (Python) | پانداس (Pandas) | سایکیت-لرن (Scikit-learn) | پاور بیآی (Power BI) | مپردیوس (MapReduce) | اَژور (Azure) |
| اسکیوال (SQL) | نامپای (NumPy) | نوتبوکهای آیپایتون (iPython notebooks) | پلاتلی (Plotly) | آپاچی اسپارک (Apache Spark) | جیسیپی (GCP) |
ارزش علم داده در کسبوکار
در عصر دیجیتال امروز، دانشمندان داده تقریباً در تمامی سازمانها حضور دارند. این متخصصان، افرادی چندبُعدی و تحلیلگر با مهارتهای فنی سطح بالا هستند که میتوانند الگوریتمهای کمیِ پیچیدهای را برای سازماندهی و تجمیع حجم عظیمی از اطلاعات ایجاد کنند؛ اطلاعاتی که برای پاسخ به پرسشها و پیشبرد استراتژی سازمانها به کار گرفته میشوند. آنها همچنین از تجربه ارتباطی و رهبری لازم برخوردارند تا نتایج ملموسی را به ذینفعان (Stakeholders) مختلف در سراسر یک سازمان یا کسبوکار تحویل دهند.
دانشمندان داده کارآمد، پرسشهای مرتبط را با مهارت شناسایی میکنند، دادهها را از منابع گوناگون گردآوری مینمایند، اطلاعات را سامان میبخشند، نتایج را به راهحلها ترجمه میکنند و یافتههای خود را به شیوهای انتقال میدهند که تصمیات کسبوکار را بهطور مثبت تحت تأثیر قرار دهد.
جمعبندی
چرخه حیات علم داده، چارچوبی مرحلهبهمرحله برای تبدیل دادههای خام به بینشهای کاربردی و قابل استفاده در تصمیمگیریهای کسبوکار است. این چرخه با جمعآوری داده آغاز میشود و پس از نگهداری و آمادهسازی، پردازش و کاوش و سپس تحلیل دادهها ادامه پیدا میکند. در نهایت، نتایج به کمک گزارشدهی، مصورسازی و ابزارهای هوش تجاری در اختیار ذینفعان قرار میگیرند تا بتوان از آنها برای تصمیمگیری بهتر استفاده کرد.
در این فرآیند، دانشمند داده نقش مهمی در تبدیل دادههای پیچیده به اطلاعات قابلفهم و ارزشمند دارد. ترکیبی از مهارتهای آماری، برنامهنویسی، یادگیری ماشین، تحلیل داده و توانایی انتقال مفاهیم پیچیده به افراد غیرفنی، به این متخصصان کمک میکند تا از دادهها برای شناسایی الگوها، پیشبینی روندها و حل مسائل کسبوکار استفاده کنند. به همین دلیل، علم داده امروزه یکی از ابزارهای مهم سازمانها برای دستیابی به تصمیمگیری دادهمحور و ایجاد ارزش تجاری محسوب میشود.


دیدگاهتان را بنویسید