
واژهنامه · فنی
Direct Preference Optimization (DPO) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
بهینهسازی مستقیم انتخابها (DPO) یک رویکرد نوین و پیشگامانه در حوزه همراستاسازی مدلهای زبانی (language model alignment) است که طراحی شده تا مدلهای زبانی بزرگ (LLMs) را با ترجیحات انسانی همراستا کند، بدون آنکه به چارچوب سنتی و از نظر محاسباتی پرهزینه یادگیری تقویتی (reinforcement learning – RL) متکی باشد.
روش بهینهسازی مستقیم انتخابها (DPO) یک روش تنظیم دقیق (fine-tuning) بسیار تأثیرگذار و شناختهشده است که نقشی کلیدی در پیشبرد همراستاسازی مدلهای زبانی (language model alignment) ایفا کرد. اگرچه روشهای جدیدتری مانند GRPO و GSPO مورد توجه قرار گرفتهاند و روزبهروز در حال شکلدادن به این صنعت هستند، اما DPO همچنان یک تکنیک بنیادین (foundational technique) به شمار میرود.
روش کار بهینهسازی مستقیم انتخابها (DPO) چگونه است؟
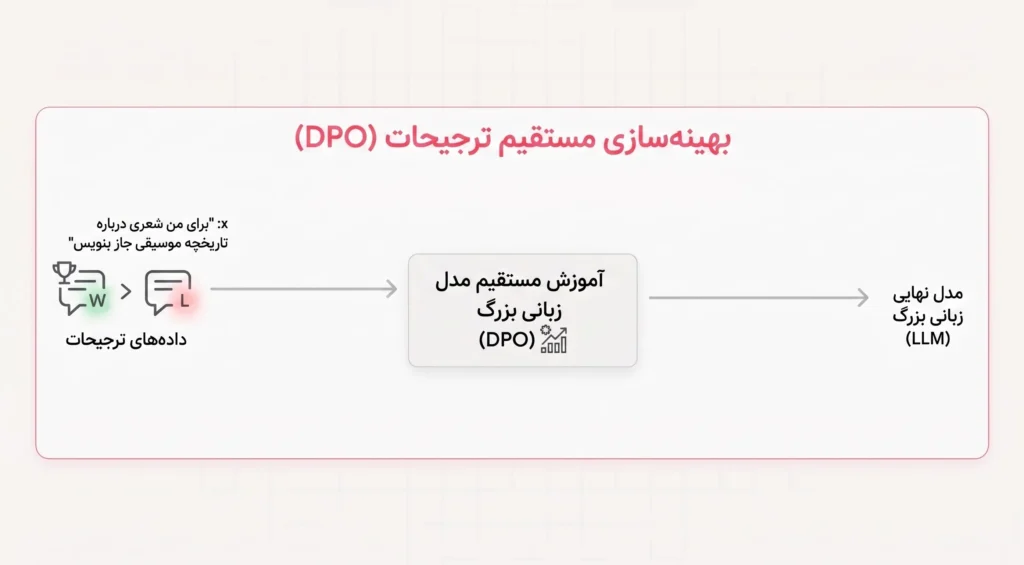
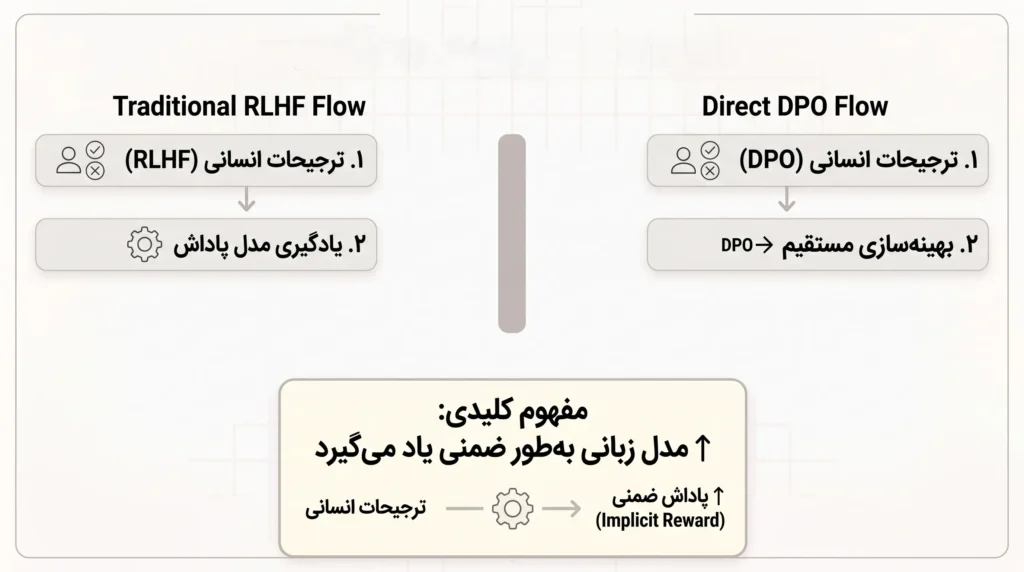
روش DPO با یک مدل زبانی آغاز میشود که پیشتر تحت تنظیم دقیق نظارتشده (supervised fine-tuned – SFT) قرار گرفته است. این روش بهجای آموزش یک مدل پاداش (reward model) مجزا و استفاده از یادگیری تقویتی (reinforcement learning) برای بهبود خروجیهای مدل، مستقیماً از جفتپاسخهای ترجیحدادهشده (preferred) و ردشده (rejected) توسط انسان یاد میگیرد.
در طول فرایند آموزش، DPO از یک تابع زیان (loss function) استفاده میکند که احتمال تولید پاسخ مطلوبتر را نسبت به پاسخ ردشده بالاتر میبرد، در حالی که همزمان هر دوی این پاسخها را با یک مدل مرجع ثابت (fixed reference model) مقایسه میکند. از آنجا که بهینهسازی در این روش مستقیماً از روی دادههای ترجیحات انسانی صورت میگیرد، DPO مرحله مدل پاداش و حلقه یادگیری تقویتی بهکاررفته در فرایند RLHF را حذف میکند.
در مقایسه، یک پایپلاین استاندارد RLHF (standard RLHF pipeline) پیش از استفاده از یادگیری تقویتی که معمولاً با الگوریتم بهینهسازی تقریبی خطمشی (Proximal Policy Optimization – PPO) انجام میشود. ابتدا یک مدل پاداش جداگانه را بر اساس دادههای ترجیحات انسانی آموزش میدهد تا سپس خطمشی مدل (policy) را بهروزرسانی کند.
مرحله ۱: ساخت مجموعه داده ترجیحات (preference dataset)
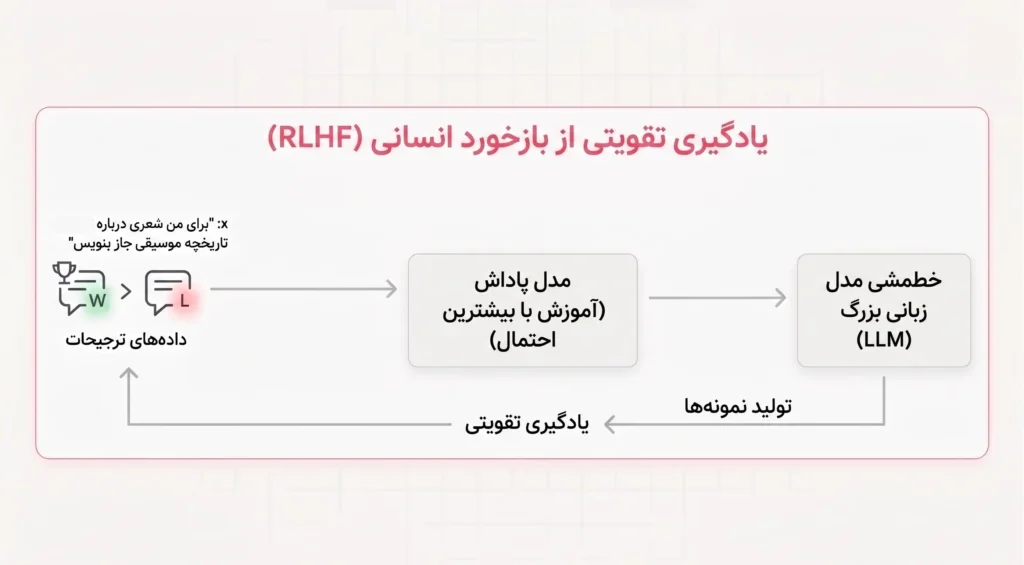
روش DPO بر روی سهگانهها (triplets) آموزش میبیند:
- یک پاسخ ردشده (rejected response)
- یک پرامپت (prompt)
- یک پاسخ ترجیحدادهشده (preferred response)
مثال
پرامپت: چگونه رمز عبور خود را بازنشانی کنم؟
پاسخ ترجیحدادهشده: «روی گزینه ‘Forgot Password’ در صفحه ورود کلیک کنید و دستورالعملهای ارسالشده به ایمیلتان را دنبال نمایید.»
پاسخ ردشده: «رمزهای عبور برای حفظ امنیت حساب کاربری مهم هستند.»
مرحله ۲: محاسبه احتمال پاسخها (Calculate response probabilities)
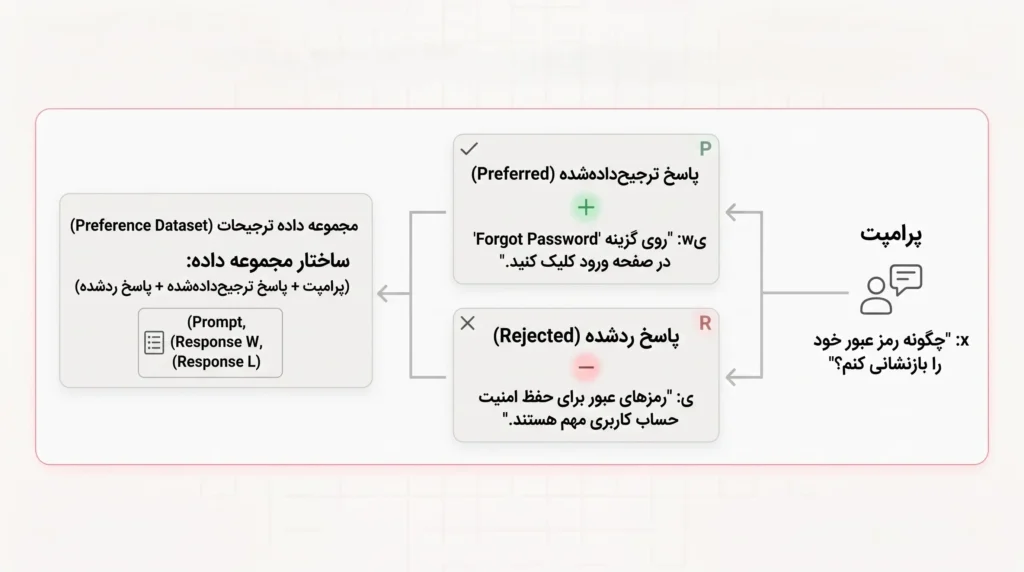
به ازای هر جفت ترجیح، مدل محاسبه میکند که احتمال تولید پاسخ ترجیحدادهشده و پاسخ ردشده چقدر است.
اگر احتمال تولید پاسخ ردشده توسط مدل در وضعیت فعلی بیشتر باشد، مدل یک خطا را شناسایی کرده است. چنانچه مدل از پیش پاسخ ترجیحدادهشده را ترجیح دهد، تنها به یک اصلاح کوچک نیاز خواهد بود.
مرحله ۳: مقایسه با یک مدل مرجع (Compare against a reference model)
روش DPO این احتمالها را بهصورت مجزا ارزیابی نمیکند؛ بلکه آنها را با یک مدل مرجع ثابت (frozen reference model) مقایسه مینماید که معمولاً همان مدلِ حاصل از تنظیم دقیق نظارتشده (SFT) پیش از آغاز آموزش DPO است.
این مدل مرجع به عنوان یک خط مبنا (baseline) عمل میکند و تضمین میدهد که مدل بیش از حد از توانمندیهای فراگرفتهشده در مرحله تنظیم دقیق نظارتشده فاصله نگیرد. یک ابرپارامتر به نام بتا این مصالحه (tradeoff) را کنترل میکند. مقدار بتای پایینتر به مدل اجازه میدهد برای همراستایی بهتر با ترجیحات انسانی، فاصله بیشتری از مدل مرجع بگیرد؛ در حالی که بتای بالاتر، مدل را نزدیکتر به مرجع حفظ میکند و ثبات را بر تغییرات رفتاری بزرگتر اولویت میدهد.
مرحله ۴: محاسبه تابع زیان (Compute the loss function)
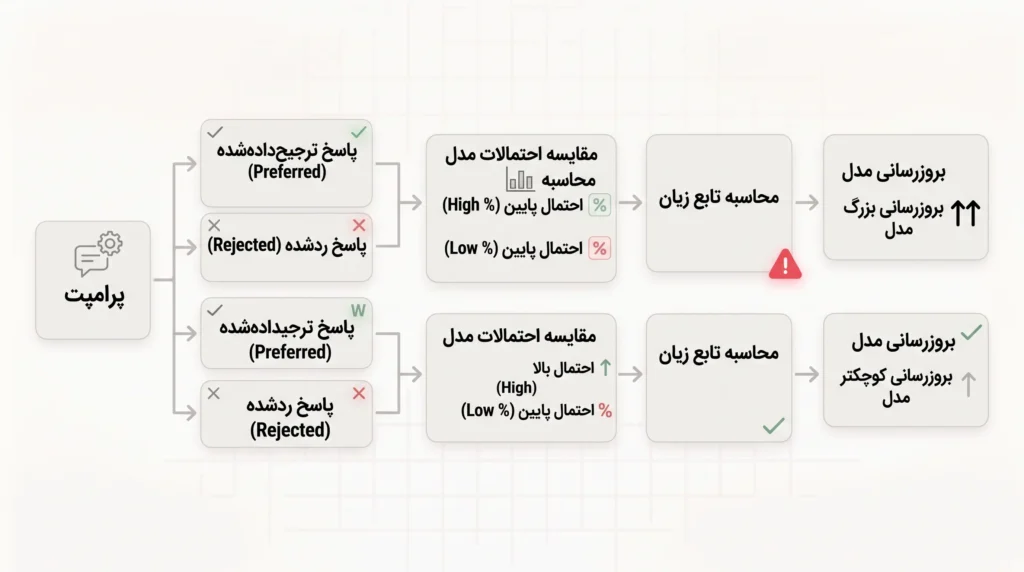
روش DPO از یک تابع زیان (loss function) استفاده میکند تا مشخص شود مدل به چه میزانی باید از هر جفت ترجیح بیاموزد.
زمانی که مدل احتمال بالاتری را به پاسخ ردشده نسبت به پاسخ ترجیحدادهشده اختصاص دهد، مقدار زیان بزرگتر میشود که این امر به یک بهروزرسانی (update) بزرگتر منجر خواهد شد. اگر مدل از پیش پاسخ ترجیحدادهشده را ترجیح دهد، مقدار زیان کوچکتر است؛ زیرا اصلاح کمتری نیاز خواهد بود.
تابع زیان بهجای بهینهسازی یک امتیاز پاداش (reward score)، مستقیماً مدل را سوق میدهد تا احتمال پاسخهای ترجیحدادهشده را افزایش دهد و در عین حال، احتمال پاسخهای ردشده را کاهش دهد.
مرحله ۵: تنظیم وزنهای مدل (Adjust the model’s weights)
روش DPO با استفاده از مقدار زیان (loss)، وزنهای مدل (model’s weights) یعنی همان میلیاردها پارامتری که چگونگی تولید متن را تعیین میکنند. را بهروزرسانی مینماید.
هر بهروزرسانی، احتمال تولید پاسخهای ترجیحدادهشده توسط انسان را افزایش و متقابلاً احتمال تولید پاسخهای ردشده را کاهش میدهد. تکرار این فرایند در میان میلیونها جفت ترجیح، بهتدریج رفتارهایی را به مدل میآموزد که همواره برای انسانها ارزشمند هستند؛ مانند مفیدتر بودن، دقیقتر بودن و ایمنتر بودن.
مرحله ۶: یادگیری یک تابع پاداش ضمنی (Learn an implicit reward function)
در روش RLHF، پیش از آنکه یادگیری تقویتی (reinforcement learning) مدل زبانی را بهروزرسانی کند، یک مدل پاداش (reward model) مجزا تکتک پاسخها را ارزیابی مینماید؛ اما روش DPO این مرحله واسط را بهطور کامل حذف میکند.
روش DPO بهجای یادگیری صریح یک مدل پاداش، یک تابع پاداش ضمنی (implicit reward function) را مستقیماً از طریق خودِ مدل زبانی فرا میگیرد. از آنجا که احتمال تولید پاسخهای ترجیحدادهشده بهطور فزایندهای نسبت به پاسخهای ردشده بیشتر میشود، مدل عملاً همان سیگنال ترجیحی (preference signal) را که یک مدل پاداش خارجی فراهم میساخت، درونیسازی (internalize) میکند.
نوآوری کلیدی DPO دقیقاً در همین نقطه نهفته است؛ این روش با بهینهسازی مستقیم بر اساس دادههای ترجیحات انسانی، به همان هدف همراستاسازی (alignment objective) در روش RLHF دست مییابد، در حالی که نیاز به یک مدل پاداش مجزا و پایپلاین یادگیری تقویتی (reinforcement learning pipeline) را از میان برمیدارد.
آیا روش(DPO) میتواند روی یک مجموعه داده ترجیهی واقعی مقیاسپذیر شود؟
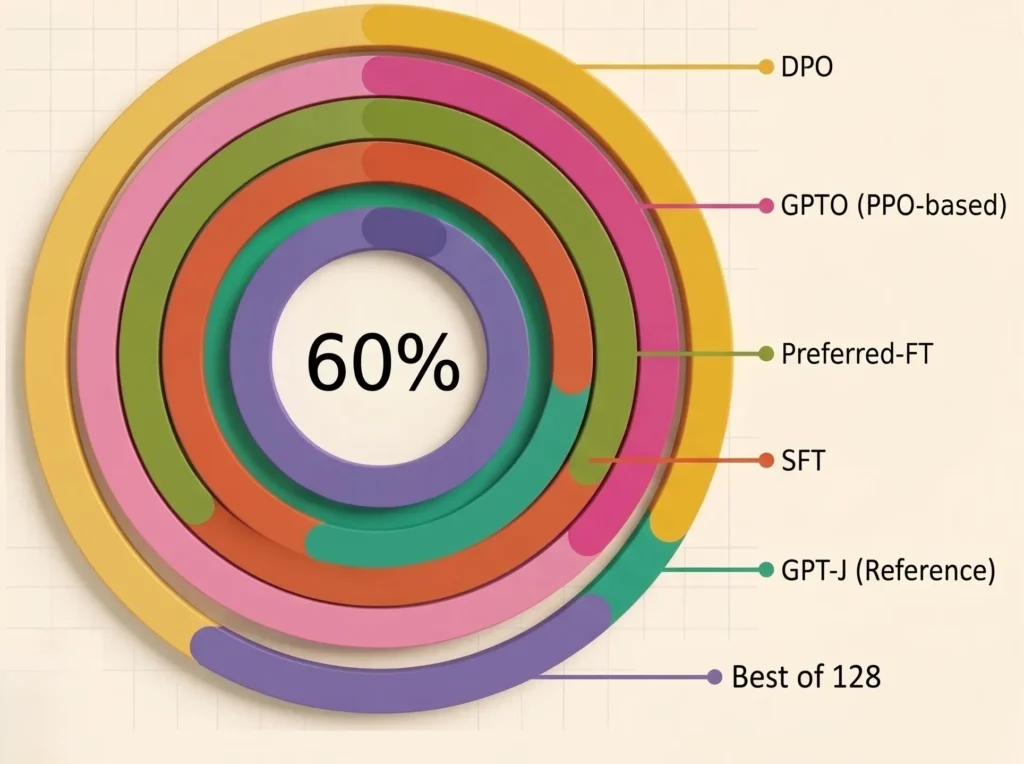
معیارهای ارزیابی خودکار مانند ROUGE اغلب در انطباق کامل با قضاوتهای انسانی در تسکهای خلاصهسازی ناموفق هستند. پژوهشها نشان داده است مدلهای زبانی که با استفاده از روشهایی مانند PPO بر روی ترجیحات انسانی تنظیم دقیق (fine-tuned) شدهاند، میتوانند خلاصههای مرتبطتری تولید کنند. برای مقایسه عملکرد DPO، این روش در کنار PPO و تنظیم دقیق بر اساس ترجیحات (Preferred-FT) با استفاده از مجموعه داده خلاصهسازی TL;DR مورد آزمایش قرار گرفت.
نتایج نشان داد که روش DPO در تنظیم دمای ۰.۰ (temperature setting of 0.0) به نرخ پیروزی (win rate) تقریبی ۶۱ درصد دست یافت که اندکی بالاتر از نرخ ۵۷ درصدی روش PPO در دمای بهینه خود بود. نکته قابل توجه اینکه DPO عملکرد یکپارچه و پایداری را در دماهای مختلف حفظ کرد و در مقایسه با PPO که نتایج آن با نوسان بیشتری همراه بود. ثبات عملکردی بالاتری را به نمایش گذاشت.
عملکرد روش بهینهسازی مستقیم انتخابها (DPO) در گفتوگوهای تکنوبتی (Single-turn dialogue)
فرایند ارزیابی به گفتوگوهای تکنوبتی گسترش یافت؛ در این ارزیابی، بخشی از مجموعه داده Anthropic HH که بر تعاملات اولیه تمرکز دارد، مورد استفاده قرار گرفت. در اینجا، روش DPO در برابر چندین رویکرد محک زده شد (benchmarked)، از جمله یک مدل مرجع که از طریق Preferred-FT آموزش دیده بود و نسخهای از مدل پایه Pythia-2.8B که با پرامپت دو-نمونهای (2-shot prompted) اجرا میشد. روش DPO همواره با عملکرد سایر روشها برابری کرد یا از آنها فراتر رفت؛ از جمله در مقایسه با خط مبنای Best of 128 که از نظر محاسباتی سنگین است و به عنوان یک تقریب تقریبی (rough proxy) برای عملکرد در سطح PPO عمل میکند.
روش DPO نهتنها با خروجیهای مطلوبِ موجود در مجموعه داده برابری کرد، بلکه تنها روشی بود که بهطور مداوم آنها را بهبود بخشید. همچنین این روش همگرایی سریعی (rapid convergence) به عملکرد بهینه از خود نشان داد که مهر تأییدی بر کارایی و اثربخشی آن است.
چرا DPO میتواند تنظیم دقیق LLM را تغییر دهد؟
اهمیت روش DPO در پتانسیل آن برای سریعتر، ارزانتر و پایدارتر کردن فرایند تنظیم دقیق مدلهای زبانی بزرگ (LLM fine-tuning) نهفته است. این روش با حذف نیاز به یک مدل پاداش (reward model) جداگانه و دور زدن پیچیدگیهای یادگیری تقویتی (reinforcement learning) سنتی، راهکاری تمیزتر و مستقیمتر برای بهبود مدلهای زبانی با استفاده از بازخورد واقعی انسان ارائه میدهد.
این روش نهتنها ساده و کارآمد است، بلکه دارایی ارزشمندی برای توسعهدهندگانی محسوب میشود که به دنبال ارتقای سریع مدلهای زبانی خود هستند. چه هدفْ ساخت رباتهای گفتوگوگر (chatbots) جذابتر باشد، چه ارتقای رابطهای خدمات مشتریان و چه توسعه برنامههای مبتنی بر هوش مصنوعی با پاسخدهی شهودیتر، DPO رویکردی کاربردی پیش روی پژوهشگران میگذارد. این شیوه تعامل و پاسخگویی چنین فناوریهایی را در شرایط واقعی بهطور چشمگیری بهبود میبخشد و مسیر را برای تجربیات کاربری روانتر و بهینهتر هموار میسازد.
جمعبندی
روش بهینهسازی مستقیم انتخابها (DPO) رویکردی سادهتر و مستقیمتر برای همراستاسازی مدلهای زبانی با ترجیحات انسانی ارائه میدهد. این روش با استفاده از جفتپاسخهای ترجیحدادهشده و ردشده، بدون نیاز به آموزش یک مدل پاداش مجزا و اجرای فرایند پیچیده یادگیری تقویتی، مستقیماً وزنهای مدل را بهگونهای بهروزرسانی میکند که احتمال تولید پاسخهای مطلوب افزایش یابد. مقایسه با روشهایی مانند PPO نیز نشان میدهد که DPO میتواند در کنار سادگی و هزینه محاسباتی کمتر، عملکردی رقابتی و پایدار ارائه دهد. به همین دلیل، DPO همچنان یکی از روشهای بنیادین در فرایند تنظیم دقیق و همراستاسازی مدلهای زبانی بزرگ به شمار میرود و پایهای مهم برای توسعه رویکردهای جدیدتر در این حوزه محسوب میشود.
منابع
What is DPO in AI? Everything you need to know