
واژهنامه · پایه
مدل زبانی بزرگ (LLM) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
مدلهای زبانی بزرگ (Large Language Models) نوعی سیستم هوش مصنوعی (AI) هستند که توانایی پردازش و تولید مستقل متن را دارند. این مدلها با تحلیل حجم بسیار زیادی از دادهها از منابع مختلف آموزش میبینند و در طول این فرایند، الگوهای زبانی، ارتباط میان بخشهای مختلف متن و ظرافتهای معنایی زبان را یاد میگیرند.
تعریف فنی مدل زبانی بزرگ (LLM)
مدل زبانی بزرگ (LLM) یک سیستم یادگیری عمیق مبتنی بر معماری ترنسفورمر (Transformer) است که دادههای متنی را بهصورت همزمان پردازش میکند. این مدل با استفاده از میلیاردها پارامتر و مکانیسم خودتوجهی (Self-Attention)، احتمال آماری رخدادن هر توکن بعدی را بر اساس توکنهای قبلی پیشبینی میکند.
چرا به آن مدل زبانی بزرگ (Large) می گویند؟
آنچه یک مدل زبانی را «بزرگ» (Large) میکند، تعداد پارامترهای آن است؛ پارامترهایی که در واقع وزنهای قابل تنظیم مدل هستند و مدل در طول فرایند آموزش آنها را یاد میگیرد. هرچه تعداد این پارامترها بیشتر باشد، مدل ظرفیت بیشتری برای یادگیری الگوهای پیچیدهتر زبانی و معنایی خواهد داشت.
به طوری که مدلهای زبانی بزرگ (LLMs) در حوزه پردازش زبان طبیعی (NLP) و تولید محتوا نقش حیاتی دارند و پایه بسیاری از چتباتهای هوشمند و دستیارهای هوش مصنوعی امروزی هستند.
جایگاه مدل زبانی بزرگ(LLM) در هوش مصنوعی

حوزه هوش مصنوعی (AI) اغلب به شکل مجموعهای از لایههای مختلف نمایش داده میشود:
- هوش مصنوعی (Artificial Intelligence یا AI) یک اصطلاح بسیار گسترده است، اما بهطور کلی به ساخت ماشینهایی میپردازد که بتوانند رفتارهای هوشمندانه از خود نشان دهند.
- یادگیری ماشین (Machine Learning یا ML) یکی از زیرشاخههای هوش مصنوعی است که بهطور مشخص بر شناسایی الگوها در دادهها تمرکز دارد. ایده اصلی این است که وقتی یک مدل بتواند الگویی را در دادهها تشخیص دهد، میتواند از همان الگو برای تحلیل و پیشبینی دادهها یا مشاهدات جدید استفاده کند.
- یادگیری عمیق (Deep Learning) حوزهای از یادگیری ماشین است که بیشتر بر پردازش دادههای بدون ساختار، مانند متن و تصاویر، تمرکز دارد. این حوزه بر پایه شبکههای عصبی مصنوعی (Artificial Neural Networks) ساخته شده است؛ روشی که تا حدی از نحوه عملکرد مغز انسان الهام گرفته است.
- مدلهای زبانی بزرگ (Large Language Models یا LLMs) بهطور خاص با دادههای متنی سروکار دارند و تمرکز اصلی این مقاله نیز بر همین مدلها خواهد بود.
مدل های زبانی بزرگ (LLMs) چه تفاوتی با هوش مصنوعی مولد(Generative AI) دارند؟
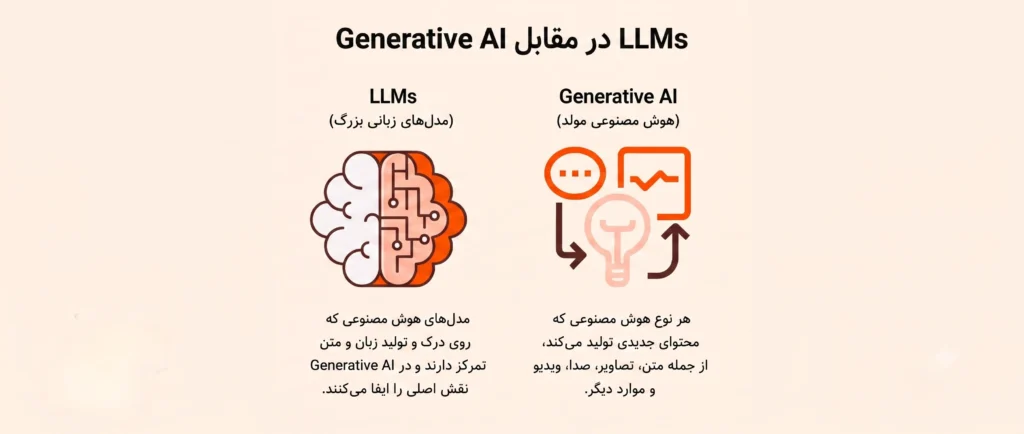
تفاوت اصلی میان هوش مصنوعی مولد (Generative AI) و مدلهای زبانی بزرگ (LLM) در دامنه کاربرد آنها است. هوش مصنوعی مولد یک دسته گسترده از سیستمهای هوش مصنوعی است که میتواند محتوای جدیدی مانند متن، تصویر، موسیقی و ویدیو تولید کند. در مقابل، مدل زبانی بزرگ (LLM) زیرمجموعهای از هوش مصنوعی مولد است که بهطور تخصصی بر درک و تولید زبان انسان و همچنین پردازش و تولید کد تمرکز دارد.
تاریخچه مختصر مدلهای زبانی بزرگ (LLM)
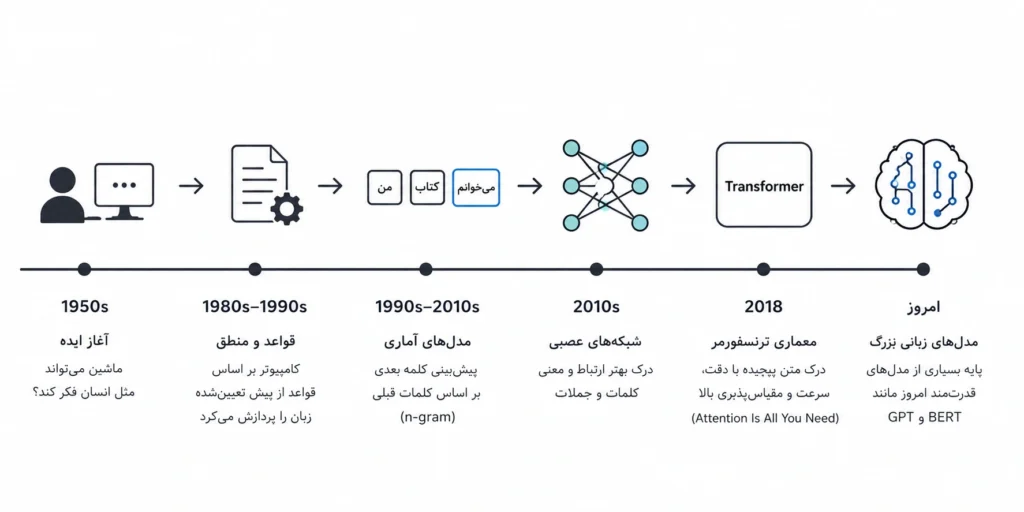
مدلهای زبانی بزرگ (LLM) فناوری نسبتاً جدیدی محسوب میشوند، اما پژوهش در زمینه پردازش زبان طبیعی (NLP) به سال ۱۹۵۰ بازمیگردد؛ زمانی که آلن تورینگ آزمون تورینگ را برای ارزیابی رفتار هوشمندانه ماشینها معرفی کرد. در این آزمون، یک داور انسانی از طریق مجموعهای از پرسشها با یک رایانه گفتگو میکند و باید تشخیص دهد که طرف مقابل او یک ماشین است یا یک انسان.
در دهههای ۱۹۸۰ و ۱۹۹۰، پردازش زبان طبیعی از رویکردهای مبتنی بر قواعد و آزمایشهای منطقی فاصله گرفت و به سمت رویکردهای دادهمحور حرکت کرد. مدلهای زبانی آماری مانند تولید زبان طبیعی (n-gram) با توانایی پیشبینی کلمه بعدی در یک جمله بر اساس کلمات قبلی، زمینه را برای نسل جدیدی از مدلهای زبانی فراهم کردند. در اوایل دهه ۲۰۱۰، شبکههای عصبی جدید قابلیتهای این مدلها را بیشتر گسترش دادند و به آنها اجازه دادند فراتر از پیشبینی ترتیب کلمات، به درک عمیقتری از نحوه نمایش، ارتباط و معنای کلمات دست پیدا کنند.
این پیشرفتها در سال ۲۰۱۸ به نقطه عطف مهمی رسید؛ زمانی که هشت پژوهشگر گوگل مقاله معروف Attention Is All You Need را منتشر کردند؛ مقالهای که تأثیر چشمگیری بر حوزه یادگیری ماشین گذاشت. مهمترین دستاورد این پژوهش، معرفی معماری ترنسفورمر (Transformer) بود؛ یک چارچوب نوآورانه مبتنی بر شبکههای عصبی که امکان پردازش و درک اطلاعات متنی پیچیده را با دقت، سرعت و مقیاسپذیری بیشتری فراهم کرد. امروزه معماری ترنسفورمر پایه اصلی بسیاری از قدرتمندترین مدلهای زبانی بزرگ، از جمله خانواده GPT و مدل BERT، محسوب میشود.
مدلهای زبانی بزرگ چگونه کار میکنند؟ (How LLMs Work)
مرحله ۱: توکنایز کردن (Tokenization)
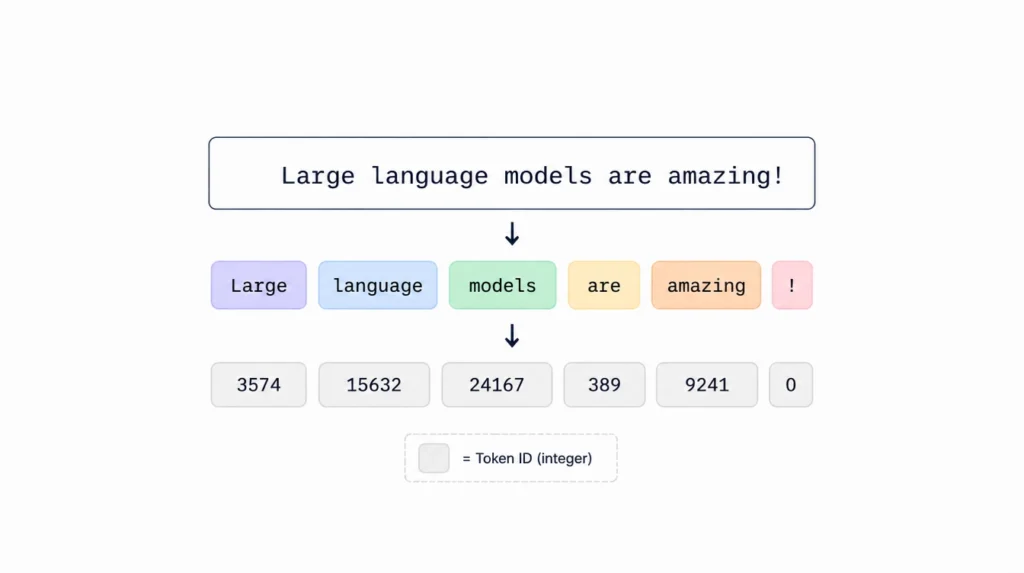
در اولین مرحله، متن ورودی توسط توکنایزر (Tokenizer) به واحدهای کوچکتری به نام توکن (Token) تقسیم میشود. توکنها لزوماً کلمات کامل نیستند و میتوانند بخشهایی از کلمات باشند.
توکنایزر با استفاده از فهرست واژگان (Vocabulary)، هر توکن را به یک شناسه عددی (ID) تبدیل میکند؛ زیرا مدلها متن را به صورت اعداد پردازش میکنند.
در نتیجه، متن خام به دنبالهای از توکنها و شناسههای عددی تبدیل میشود.
مرحله ۲: لایه امبدینگ (Embedding Layer)
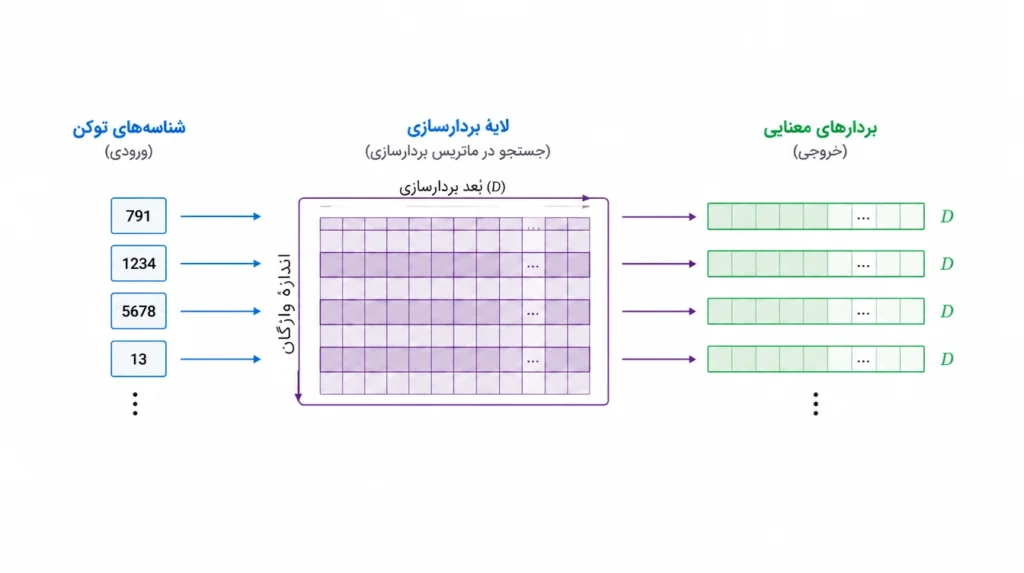
شناسههای توکن وارد لایه امبدینگ (Embedding Layer) میشوند. این لایه هر توکن را به یک بردار (Vector) تبدیل میکند.
این بردارها در طول فرایند آموزش مدل یاد گرفته شدهاند و اطلاعات معنایی توکنها را در خود دارند. همچنین اطلاعات مربوط به موقعیت توکنها (Positional Encoding) به این بازنماییها اضافه میشود تا ترتیب آنها در دنباله حفظ شود.
در پایان این مرحله، یک ماتریس از بردارهایی داریم که معنا و موقعیت توکنهای موجود در دنباله را در خود دارد.
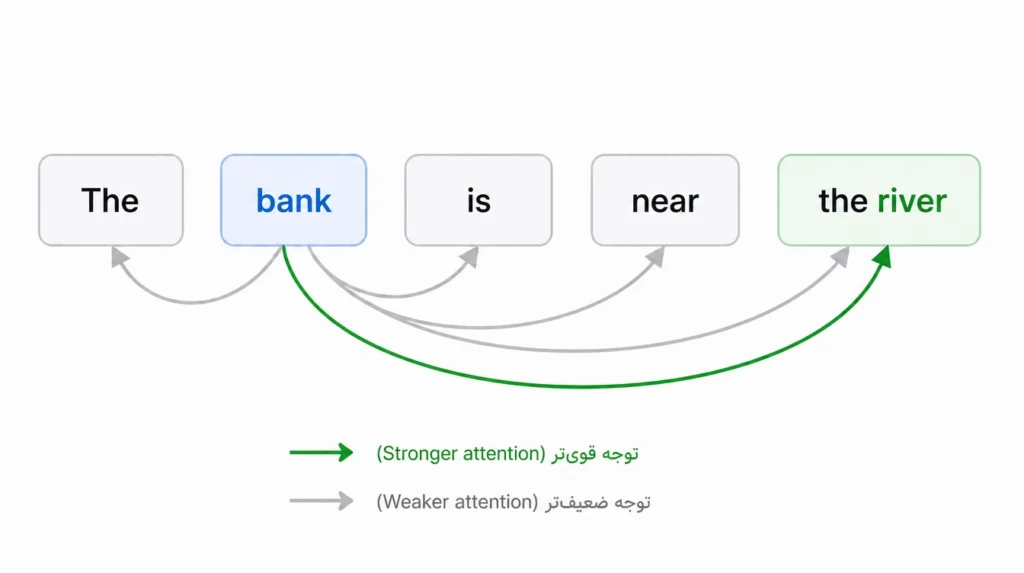
مرحله ۳: توجه به خود (Self-Attention)
در این مرحله، مدل ارتباط میان توکنهای مختلف را بررسی میکند تا مشخص شود کدام توکنها برای درک یکدیگر اهمیت بیشتری دارند.
در توجه به خود چندسری (Multi-Head Self-Attention)، امبدینگها به سه بخش Query، Key و Value تبدیل میشوند. مدل با مقایسه Query و Key، میزان ارتباط میان توکنها را محاسبه میکند و سپس با استفاده از این وزنها، Valueها را ترکیب میکند.
در نتیجه، برای هر توکن یک بردار زمینه (Context Vector) ایجاد میشود که اطلاعات مربوط به سایر توکنهای دنباله را نیز در خود دارد.
مرحله ۴: لاجیتها (Logits)
برای پیشبینی توکن بعدی، بردار زمینه مربوط به آخرین توکن از یک لایه خطی (Linear Layer) عبور میکند.
این لایه برای تمام توکنهای موجود در واژگان، امتیازهای خامی به نام Logits تولید میکند. این امتیازها نشان میدهند مدل هر توکن احتمالی بعدی را چگونه ارزیابی میکند.

مرحله ۵: سافتمکس و دما (Softmax & Temperature)
تابع Softmax لاجیتها(Logits) را به احتمالات تبدیل میکند؛ بهگونهای که مجموع احتمال تمام توکنهای ممکن برابر با ۱ باشد.
پارامتر دما (Temperature) بر توزیع این احتمالات تأثیر میگذارد. دمای بالاتر باعث پراکندگی بیشتر احتمالات و دمای پایینتر باعث تمرکز بیشتر احتمالات روی گزینههای محتمل میشود.

مرحله ۶: نمونهبرداری (Sampling)
در این مرحله، مدل بر اساس توزیع احتمال، توکن بعدی را انتخاب میکند.
در روش Greedy Sampling، توکنی که بالاترین احتمال را دارد انتخاب میشود. در روشهای نمونهبرداری تصادفی، انتخاب توکن بر اساس احتمال آن انجام میشود.

حلقه خودرگرسیو (Autoregressive Loop) و دیتوکنایز کردن (Detokenization)
پس از انتخاب توکن بعدی، آن توکن به دنباله اضافه میشود و فرایند دوباره تکرار میشود. مدل مراحل Embedding، Self-Attention، Logits، Softmax و Sampling را برای پیشبینی توکن بعدی تکرار میکند.
این فرایند تا رسیدن به شرط توقف، مانند رسیدن به حداکثر تعداد توکنها یا تولید توکن پایان توالی (End-of-Sequence Token)، ادامه پیدا میکند.
در نهایت، با انجام دیتوکنایز کردن (Detokenization)، شناسههای توکن به متن قابل خواندن برای انسان تبدیل میشوند.

مزایا و کاربردهای مدل زبانی بزرگ (LLM)
بهبود تولید زبان و ترجمه
LLMها میتوانند روابط ظریف میان کلمات را درک و ثبت کنند و به همین دلیل، در تولید متن طبیعی و انسانگونه عملکرد خوبی دارند. آنها میتوانند پاسخهایی روان، پیوسته، خلاقانه و متناسب با زمینه تولید کنند.
LLMهایی که بر روی دادههای چندزبانه آموزش دیدهاند نیز میتوانند ترجمههای دقیقی انجام دهند و اصطلاحات، عبارات و سایر ویژگیهای پیچیده زبانی را بهتر مدیریت کنند.
کاربردها در زمینههای مختلف
LLMها ابزارهای همهکارهای هستند که در زمینههای مختلفی از جمله مراقبتهای بهداشتی، مالی و خدمات مشتریان کاربرد دارند:
| مراقبتهای بهداشتی | میتوانند گزارشهای بیمار را تحلیل کنند، یادداشتهای بیمار و خلاصههای ترخیص را تولید کنند و برنامههای درمانی شخصیسازیشده پیشنهاد دهند. |
| بخش مالی | میتوانند فعالیتهای غیرمعمول را شناسایی کنند، خطرات مالی را ارزیابی کنند و توصیههای شخصیسازیشده ارائه دهند. |
| خدمات مشتریان | میتوانند پشتیبانی خودکار ارائه دهند و به ایجاد و بهروزرسانی مستندات کمک کنند. |
چالشها در مدل زبانی بزرگ (LLM)
الزامات محاسباتی و انرژی
LLMها برای کار کردن به مقادیر قابلتوجهی از منابع محاسباتی، فضای ذخیرهسازی و انرژی نیاز دارند. هرچه متن طولانیتر باشد، به حافظه بیشتری نیاز است.
این نیازها نهتنها پرهزینه هستند، بلکه میتوانند پیامدهای زیستمحیطی نیز داشته باشند و نشاندهنده نیاز به مدلها و تکنیکهای کارآمدتر از نظر مصرف انرژی هستند.
نگرانیهای اخلاقی؛ عدم بی طرفی و اطلاعات نادرست
اگر در دادههای آموزشی LLMها جهتگیریهای تبعیضآمیزی و عدم بی طرفی وجود داشته باشد، مدل ممکن است این الگوها را در خروجیهای خود بازتولید کند. شناسایی و کاهش این جهتگیریها به نظارت مستمر انسانی نیاز دارد.
LLMها همچنین میتوانند اطلاعاتی متقاعدکننده اما از نظر واقعی گمراهکننده تولید کنند که ممکن است به انتشار اطلاعات نادرست، اخبار جعلی، ایمیلهای فیشینگ(Phishing) و سایر اشکال محتوای مضر منجر شود.
محدودیتها در درک زمینه و ظرافت
اگرچه LLMها در شناسایی الگوهای زبانی عملکرد خوبی دارند، ممکن است در مواجهه با زمینههای جدید یا ناشناختهای که به درک ظریفتری نیاز دارند، دچار مشکل شوند.

چشم انداز آینده
با ادامه تلاش محققان برای بهبود درک، کارایی و مقیاسپذیری، انتظار میرود LLMها در انجام وظایف پیچیده زبانی توانمندتر شوند. با گسترش استفاده از LLMها، سازمانهای بیشتری میتوانند از اتوماسیون سادهتر، شخصیسازی بیشتر و فرایندهای تصمیمگیری بهتر بهرهمند شوند.