
واژهنامه · فنی
(PPO)Proximal Policy Optimization چیست و چه کاربردی دارد؟
تعریف به زبان ساده
بهینهسازی سیاست نزدیک (Proximal Policy Optimization یا PPO) یک الگوریتم عمیق در حوزه یادگیری تقویتی است که عملکرد مدلها را بهبود میدهد. در PPO، «سیاست» نشان میدهد که یک عامل چگونه یاد گرفته است در جهان عمل کند.
بهینهسازی سیاست نزدیک (Proximal Policy Optimization یا PPO) یک الگوریتم یادگیری تقویتی است که در یادگیری ماشین(Machine Learning) برای آموزش عاملها (Agents) به کار میرود تا بتوانند در یک محیط، وظایف مختلف را انجام دهند. «سیاستها» (Policies) راهبردها یا قوانینی هستند که مدل با استفاده از آنها، در موقعیتهای مختلف تصمیم میگیرد چه اقدامی انجام دهد. این سیاستها معمولاً بهصورت شبکههای عصبی عمیق نمایش داده میشوند.
دادههای آموزشی در یادگیری تقویتی که عامل هنگام تعامل با محیط تولید میکند، به سیاست فعلی آن وابسته است. این فرایند مانند یادگیری نظارتشده بر یک مجموعهداده ازپیشجمعآوریشده تکیه نمیکند. در جریان آموزش، مشاهدات عامل دائماً تغییر میکنند؛ زیرا عامل پس از هر اقدام، چیز جدیدی یاد میگیرد. در نتیجه، دادهها و پاداشها نیز تغییر میکنند و این موضوع یکی از دلایل اصلی ناپایداری فرایند آموزش است.
علاوه بر این، الگوریتمهای یادگیری تقویتی نسبت به تنظیم ابرپارامترها حساسیت زیادی دارند؛ برای مثال، تغییر تعداد دورههای آموزش (Training Epochs) میتواند تأثیر قابلتوجهی داشته باشد. مقداردهی اولیه، از جمله تعیین مقادیر وزنهای شبکه عصبی، نیز بر روند آموزش اثر میگذارد. به همین دلایل، فرایند آموزش در یادگیری تقویتی ناپایدار تلقی میشود.
بهینهسازی سیاست نزدیک بهعنوان یک روش گرادیان سیاست(Policy Gradient Method)
بهینهسازی سیاست نزدیک بر پایه روشهای گرادیان سیاست بنا شده است؛ روشهایی که سیاست را بهصورت مستقیم بهینه میکنند. الگوریتم PPO بر اساس مشاهدات فعلی عامل در یک لحظه مشخص، بهترین اقدام را انتخاب میکند. عامل با محیط تعامل دارد و مطابق با راهبرد یا سیاست خود اقدام میکند. در نتیجه، انتقال از یک وضعیت به وضعیت دیگر انجام میشود.
عامل برای هر یک از اقدامات خود از محیط پاداش دریافت میکند و از این طریق میتواند میزان اثربخشی اقدام انجامشده را ارزیابی کند. روشهای گرادیان سیاست بهطور خاص به توسعه راهبردهای رفتاری و سیاستهای عامل کمک میکنند تا عملکرد و کارایی آن افزایش یابد.
تاریخچه (PPO)
پیش از ظهور PPO، پژوهشگران الگوریتمهای دیگری را برای آموزش ماشینها بهمنظور تصمیمگیری در محیطهای ناشناخته طراحی کرده بودند. آنها روشهای مختلفی مانند یادگیری عمیق مبتنی بر Q (Deep Q-Learning)، روشهای گرادیان سیاست ساده (Vanilla Policy Gradient) و بهینهسازی سیاست در ناحیه اعتماد (Trust Region Policy Optimization یا TRPO) را پیشنهاد کردند. بااینحال، عواملی مانند مقیاسپذیری محدود، هدررفت دادهها و پیچیدگیهای پیادهسازی، مانع از بهکارگیری گسترده آنها میشد.
PPO چگونه کار میکند؟
در PPO از رویکرد بازیگر ـ منتقد (Actor-Critic) استفاده میشود. در این رویکرد، بازیگر یا همان سیاست (Policy) بهروزرسانی میشود تا انتخاب اقدامات بهبود پیدا کند. منتقد یا ارزیاب (Critic) نیز بررسی میکند که اقدامات عامل تا چه اندازه با پاداشهای مورد انتظار مطابقت دارند.
هدف PPO بیشینهکردن پاداش تجمعی مورد انتظار در طول زمان است. این کار با تنظیم سیاست انجام میشود؛ بهگونهای که احتمال انتخاب اقدامهایی که به پاداشهای بیشتر منجر میشوند، افزایش یابد.
انواع اصلی PPO
PPO دو گونه اصلی دارد:
- PPO-Penalty
- PPO-Clip
تفاوت این دو گونه در روشی است که با استفاده از آن اطمینان حاصل میکنند سیاست جدید بهطور چشمگیری با سیاست قبلی تفاوت نداشته باشد.
سازوکار برشدادن(Clipping)
PPO با استفاده از یک سازوکار برشدادن (Clipping)، پایداری آموزش عامل را افزایش میدهد. در این روش، ضریبی در تابع هدف PPO که در تابع هدف جانشین برشخورده (Clipped Surrogate Objective Function) به کار میرود، در یک بازه مشخص محدود میشود.
تابع هدف به عامل اجازه میدهد بر اساس یک دسته داده (Batch) که جمعآوری کرده است، چندین دوره آموزش یا چندین مرحله بهبود را اجرا کند. میتوان این فرایند را مانند تمرین چندباره یک مهارت در نظر گرفت که با هر بار تمرین، عملکرد بهتر میشود.
ضریب موجود در تابع هدف برشخورده، تفاوت میان سیاست فعلی و سیاست قدیمی را نشان میدهد. این سازوکار میزان تغییر سیاست در هر مرحله را محدود میکند. جلوگیری از بهروزرسانیهای بیشازحد سیاست باعث میشود فرایند یادگیری پایدارتر شود.
تفاوت PPO با TRPO
همین محدودیت است که PPO را از الگوریتمهای دیگری مانند بهینهسازی سیاست در ناحیه اعتماد (TRPO) متمایز میکند. TRPO برای محدودکردن بهروزرسانی سیاست از قیود مبتنی بر واگرایی KL استفاده میکند.
واگرایی KL که مخفف واگرایی کولبک ـ لایبلر (Kullback–Leibler Divergence) است، معیاری برای سنجش میزان تفاوت یا فاصله یک توزیع داده با یک توزیع داده مرجع یا مورد انتظار به شمار میرود. قید واگرایی KL تضمین میکند که سیاست جدید پس از بهروزرسانی، بیشازحد از سیاست قبلی فاصله نگیرد. این کار به حفظ پایداری فرایند یادگیری کمک میکند.
تابع هدف PPO
در بهینهسازی سیاست نزدیک (PPO)، تابع هدف یکی از عناصر اصلی است که با اندازهگیری تفاوت میان اقدامات پیشبینیشده توسط سیاست فعلی و اقداماتی که واقعاً در محیط انجام شدهاند، فرایند آموزش را هدایت میکند.
تابع هدف برشخورده LCLIP(θ)
تابع هدف PPO عامل را تشویق میکند اقدامهایی را انتخاب کند که با پاداشهای بیشتری همراه هستند. تابع هدف PPO بهصورت زیر تعریف میشود:
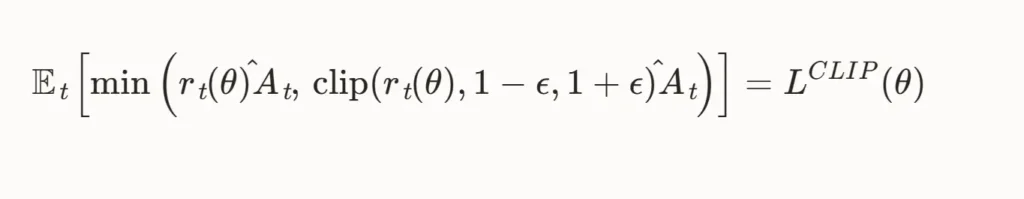
- عملگر امید ریاضی Et\mathbb{E}_tEt نشان میدهد که تابع هدف روی دستههایی از مسیرها یا دنبالههای حرکتی (Trajectories) محاسبه میشود.
- عملگر min(…)\min(…)min(…) کوچکترین مقدار را میان عبارت دارای تابع برش و عبارت بدون تابع برش انتخاب میکند.
- rt(θ)r_t(\theta)rt(θ) تفاوت میان سیاست جدید و سیاست قدیمی را محاسبه میکند. این تابع برای هر اقدام، نسبت احتمال انتخاب آن اقدام تحت سیاست جدید را با احتمال انتخاب همان اقدام تحت سیاست قدیمی مقایسه میکند. این نسبت نشان میدهد احتمال انتخاب یک اقدام مشخص توسط عامل، تحت سیاست جدید، در مقایسه با سیاست قدیمی چقدر است. سپس این مقدار در تابع مزیت A^t ضرب میشود.
- A^t\hat{A}_tA^t تابع مزیت (Advantage Function) است که کیفیت یک اقدام را در مقایسه با اقدام میانگین در یک وضعیت مشخص ارزیابی میکند. مقدار بالاتر این تابع نشان میدهد که انتظار میرود آن اقدام به نتیجه مطلوبتری منجر شود.
- clip(rt(θ),1−ϵ,1+ϵ)\operatorname{clip}(r_t(\theta),1-\epsilon,1+\epsilon)clip(rt(θ),1−ϵ,1+ϵ) مقدار rt(θ) را در بازه [1−ϵ,1+ϵ] محدود میکند. در اینجا، ϵ یا اپسیلون یک ثابت مثبت کوچک است.
این سازوکار تضمین میکند که الگوریتم PPO میان بهبود سیاست و حفظ پایداری آن تعادل برقرار کند. تابع هدف PPO عامل را بهگونهای هدایت میکند که هنگام تصمیمگیری، علاوه بر احتمال انتخاب اقدامات تحت سیاست جدید، میزان مزیت آن اقدامات را نیز در نظر بگیرد.
مزایای رویکرد PPO
پایداری
همانطور که پیشتر اشاره شد، PPO بهگونهای طراحی شده است که بهروزرسانیهایی پایدار و قابلاعتماد برای سیاست ایجاد کند. تابع هدف جانشین برشخورده به پایدارسازی فرایند آموزش کمک میکند. PPO با محدودکردن میزان بهروزرسانی سیاست، از تغییرات بزرگ و بالقوه ناپایدار در سیاست جلوگیری میکند؛ در نتیجه، فرایند یادگیری روانتر و باثباتتر خواهد بود.
سهولت پیادهسازی
در مقایسه با الگوریتمهای پیشرفته دیگری مانند بهینهسازی سیاست در ناحیه اعتماد (TRPO)، پیادهسازی PPO نسبتاً ساده است. این الگوریتم به تکنیکهای بهینهسازی مرتبه دوم نیاز ندارد و به همین دلیل، برای متخصصان تازهکار دسترسپذیرتر است.
بهرهوری نمونهای
PPO با استفاده از تابع هدف جانشین برشخورده، به بهرهوری مناسب از دادهها دست پیدا میکند. افزودن تابع برش، به تنظیم بیشتر بهروزرسانیهای سیاست کمک میکند، پایداری فرایند را افزایش میدهد و امکان استفاده مؤثرتر از دادههای آموزشی را فراهم میسازد.
در نتیجه، PPO در مقایسه با برخی دیگر از الگوریتمهای یادگیری تقویتی، معمولاً از نظر بهرهوری نمونهای عملکرد بهتری دارد. این الگوریتم میتواند با تعداد نمونههای کمتر به عملکرد مطلوب برسد و به همین دلیل، برای وظایفی مناسب است که جمعآوری داده در آنها پرهزینه یا زمانبر است.
نتیجهگیری
بهینهسازی سیاست نزدیک (PPO) یک الگوریتم یادگیری تقویتی است که در خانواده روشهای گرادیان سیاست قرار میگیرد؛ روشهایی که معمولاً به بهرهوری نمونهای بالای خود شناخته نمیشوند. بااینحال، استفاده از تابع هدف برشخورده باعث میشود PPO بهرهوری بیشتری از دادهها داشته باشد و با جلوگیری از بهروزرسانیهای بزرگ در سیاست، به پایداری فرایند آموزش کمک کند. در نتیجه، PPO میتواند با محیطهای گوناگون سازگار شود و وظایف متنوع دنیای واقعی را انجام دهد.
PPO در آزمایشهای مختلف، در وظایفی مانند کنترل رباتها و بازیکردن، کارایی و اثربخشی خود را نشان داده است. این الگوریتم از نظر سادگی و سرعت یادگیری، در برخی موارد عملکرد بهتری نسبت به روشهای مشابه داشته است.
با پیشرفت پژوهشها در زمینه یادگیری تقویتی، نتایج حاصل از بهکارگیری PPO در حوزههای مختلف و نقش آن در توسعه الگوریتمهای قابلاعتماد و مؤثر، اهمیت این روش را در ارتقای قابلیتهای سیستمهای هوشمند برجسته میکند و زمینه را برای پیشرفتهای بیشتر در حوزه هوش مصنوعی فراهم میسازد.
منابع