
واژهنامه
یادگیری تقویتی (Reinforcement Learning) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
یادگیری تقویتی (Reinforcement Learning) نوعی یادگیری ماشین است که در آن یک عامل هوش مصنوعی با آزمونوخطا و انجام اقدامات مختلف در یک محیط مشخص، عملکرد خود را بهبود میدهد. هرگاه عامل کاری را درست انجام دهد، بازخورد مثبت یا پاداش دریافت میکند و در صورت اشتباه، با بازخورد منفی یا جریمه مواجه میشود. به این ترتیب، بهمرور یاد میگیرد که برای رسیدن به بهترین نتیجه، چه روشی را انتخاب کند.
یک عامل خودمختار (Autonomous Agent) به هر سیستمی گفته میشود که بتواند بدون دریافت دستور مستقیم از انسان، در واکنش به محیط خود تصمیم بگیرد و اقدام کند. رباتها و خودروهای خودران نمونههایی از عاملهای خودمختار هستند.
در یادگیری تقویتی (Reinforcement Learning)، عاملهای خودمختار بدون دریافت راهنمایی از کاربر انسانی و از طریق آزمونوخطا یاد میگیرند که یک وظیفه را انجام دهند. این روش بهطور ویژه برای مسائل تصمیمگیری ترتیبی (Sequential Decision-Making) در محیطهای نامطمئن کاربرد دارد و میتواند نقش مهمی در توسعه هوش مصنوعی ایفا کند.
فرایند یادگیری تقویتی
یادگیری تقویتی اساساً بر رابطه میان عامل (Agent)، محیط (Environment) و هدف (Goal) استوار است. در منابع علمی، این رابطه معمولاً در قالب فرایند تصمیمگیری مارکوف (Markov Decision Process یا MDP صورتبندی میشود.
فرایند تصمیمگیری مارکوف
عامل در یادگیری تقویتی، با تعامل با محیط درباره یک مسئله یاد میگیرد. محیط اطلاعاتی درباره وضعیت فعلی (State) در اختیار عامل قرار میدهد. عامل نیز با استفاده از این اطلاعات تعیین میکند که چه اقدام یا اقداماتی (Action) انجام دهد.
اگر آن اقدام از محیط اطراف پاداش (Reward) دریافت کند، عامل تشویق میشود که در صورت قرار گرفتن در وضعیت مشابه در آینده، همان اقدام را دوباره انجام دهد. این فرایند برای هر وضعیت جدید تکرار میشود.
عامل بهمرور و با یادگیری از پاداشها و تنبیهها یاد میگیرد در محیط اقداماتی را انتخاب کند که او را به سمت هدف تعیینشده هدایت میکنند.
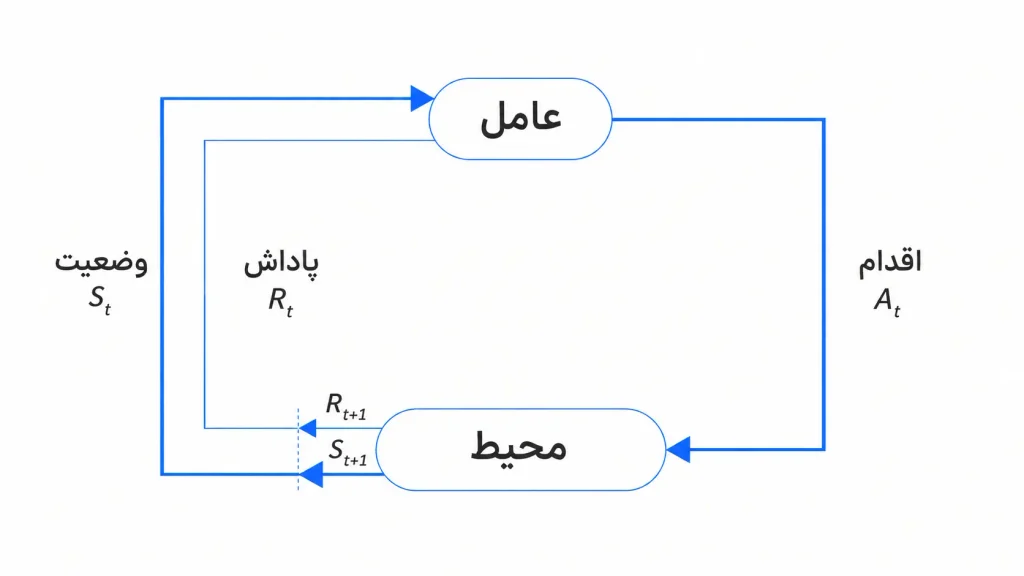
در فرایندهای تصمیمگیری مارکوف، فضای حالت (State Space) به تمام اطلاعاتی گفته میشود که وضعیت محیط را توصیف میکنند. فضای عمل (Action Space) نیز مجموعه تمام اقداماتی است که عامل میتواند در یک وضعیت انجام دهد.
موازنه اکتشاف و بهرهبرداری
از آنجا که یک عامل یادگیری تقویتی دادههای ورودیِ برچسبگذاریشدهای در اختیار ندارد که رفتار آن را بهصورت دستی هدایت کنند، باید محیط خود را اکتشاف کند و با امتحان کردن اقدامات جدید، اقداماتی را بیابد که پاداش دریافت میکنند. عامل با استفاده از این سیگنالهای پاداش یاد میگیرد اقداماتی را ترجیح دهد که پیشتر برای آنها پاداش گرفته است تا مجموع پاداش خود را به حداکثر برساند.
بااینحال، عامل باید همچنان به اکتشاف وضعیتها و اقدامات جدید ادامه دهد. به این ترتیب، میتواند از تجربههای جدید خود برای بهبود تصمیمگیریهایش استفاده کند.
بنابراین، الگوریتمهای یادگیری تقویتی از عامل میخواهند همزمان دو کار را انجام دهد: از دانشی که درباره وضعیتها و اقداماتی که قبلاً پاداش دریافت کردهاند بهرهبرداری کند و وضعیتها و اقدامات دیگری را نیز اکتشاف کند. عامل نمیتواند صرفاً به اکتشاف یا صرفاً به بهرهبرداری متکی باشد. بلکه باید بهطور مداوم اقدامات جدید را امتحان کند و در عین حال، اقدام یا زنجیرهای از اقداماتی را که بیشترین پاداش تجمعی را ایجاد میکنند، ترجیح دهد.
مؤلفههای یادگیری تقویتی
فراتر از سه عنصر اصلی عامل، محیط و هدف، چهار مؤلفه اصلی دیگر نیز مسائل یادگیری تقویتی را شکل میدهند:
سیاست (Policy):
سیاست، رفتار عامل یادگیری تقویتی را مشخص میکند و وضعیتهای مشاهدهشده محیط را به اقداماتی که عامل باید در آن وضعیتها انجام دهد، نگاشت میکند. سیاست میتواند یک تابع ساده یا یک فرایند محاسباتی پیچیدهتر باشد. برای مثال، در یک خودروی خودران، سیاست میتواند تشخیص یک عابر پیاده را به انجام عمل «توقف» مرتبط کند.
سیگنال پاداش (Reward Signal):
سیگنال پاداش، هدف مسئله یادگیری تقویتی را مشخص میکند. هر یک از اقدامات عامل یا از محیط پاداش دریافت میکند یا پاداشی دریافت نمیکند. هدف عامل، بیشینه کردن مجموع پاداشهایی است که در طول تعامل با محیط به دست میآورد.
برای خودروهای خودران، سیگنال پاداش میتواند شامل کاهش زمان سفر، کاهش تصادفها، باقی ماندن در جاده و در خط مناسب، جلوگیری از شتابگیری یا کاهش سرعت شدید و موارد مشابه باشد. این مثال نشان میدهد که یک سیستم یادگیری تقویتی میتواند برای هدایت رفتار عامل، از چندین سیگنال پاداش استفاده کند.
تابع ارزش (Value Function):
سیگنال پاداش با تابع ارزش تفاوت دارد؛ سیگنال پاداش نشاندهنده فایده فوری یک اقدام است، در حالی که تابع ارزش فایده بلندمدت آن را مشخص میکند. ارزش یک وضعیت، میزان مطلوبیت آن را با توجه به تمام وضعیتهای بعدی و پاداشهایی که احتمالاً در ادامه دریافت میشوند، نشان میدهد.
برای مثال، یک خودروی خودران شاید بتواند با خارج شدن از خط خود، حرکت روی پیادهرو و شتابگیری سریع، زمان سفر را کاهش دهد؛ اما این سه اقدام میتوانند ارزش کلی وضعیت را کاهش دهند. بنابراین، خودرو بهعنوان یک عامل یادگیری تقویتی ممکن است زمان سفر کمی طولانیتر را بپذیرد تا در عوض، پاداش بیشتری در سایر جنبهها به دست آورد و ارزش بلندمدت خود را افزایش دهد.
مدل (Model):
مدل یک مؤلفه اختیاری در سیستمهای یادگیری تقویتی است. مدل به عامل کمک میکند رفتار محیط را در صورت انجام اقدامات مختلف پیشبینی کند. عامل سپس از این پیشبینیها برای تعیین مسیرهای احتمالی اقدام، بر اساس پیامدهای مورد انتظار هر یک، استفاده میکند.
برای مثال، در یک خودروی خودران، مدل میتواند به پیشبینی بهترین مسیر، رفتار مورد انتظار خودروهای اطراف با توجه به موقعیت و سرعت آنها و موارد مشابه کمک کند. برخی از رویکردهای مبتنی بر مدل نیز در مراحل اولیه یادگیری از بازخورد مستقیم انسان استفاده میکنند و سپس فرایند یادگیری را بهصورت خودکار ادامه میدهند.
در فرایندهای تصمیمگیری مارکوف، فضای حالت (State Space) به تمام اطلاعاتی گفته میشود که وضعیت محیط را توصیف میکنند. فضای عمل (Action Space) نیز مجموعه تمام اقداماتی است که عامل میتواند در یک وضعیت انجام دهد.
انواع الگوریتمهای یادگیری تقویتی چیست؟
الگوریتمهای مختلفی در یادگیری تقویتی (RL) استفاده میشوند؛ از جمله Q-learning، روشهای گرادیان سیاست (Policy Gradient)، روشهای مونتکارلو (Monte Carlo) و یادگیری تفاضل زمانی (Temporal Difference Learning).
یادگیری تقویتی عمیق (Deep RL) نیز به استفاده از شبکههای عصبی عمیق در یادگیری تقویتی گفته میشود. یکی از نمونههای الگوریتمهای یادگیری تقویتی عمیق، بهینهسازی سیاست در ناحیه اعتماد (Trust Region Policy Optimization یا TRPO) است.
تمام این الگوریتمها را میتوان بهطور کلی در دو دسته اصلی قرار داد:
یادگیری تقویتی مبتنی بر مدل (Model-based RL)
یادگیری تقویتی مبتنی بر مدل معمولاً زمانی استفاده میشود که محیط بهخوبی تعریف شده و بتوان رفتار آن را یاد گرفت و مدلسازی کرد. در این روش، عامل میتواند یک مدل از سیستم ایجاد کند و سپس پیامدهای اقدامات مختلف را پیشبینی کند.
عامل ابتدا یک نمایش درونی یا مدل از محیط ایجاد میکند. برای ساخت این مدل، فرایند زیر را طی میکند:
- در محیط اقداماتی انجام میدهد و وضعیت جدید و مقدار پاداش را ثبت میکند.
- ارتباط میان انتقال از یک وضعیت به وضعیت دیگر در اثر یک اقدام را با مقدار پاداش مرتبط میکند.
سپس عامل از این مدل برای شبیهسازی دنبالههای مختلف اقدامات استفاده میکند تا با بیشینه کردن پاداش تجمعی، به نتیجه مطلوب برسد. به این ترتیب، عامل میتواند سیاستی را یاد بگیرد که در محیط، آن را به سمت هدف نهایی هدایت کند.
مثال
فرض کنید رباتی در حال یادگیری مسیریابی در یک ساختمان جدید است تا به اتاق مشخصی برسد. ربات در ابتدا آزادانه در ساختمان حرکت میکند و یک مدل درونی از محیط میسازد.
برای مثال، ممکن است یاد بگیرد که پس از ۱۰ متر حرکت از ورودی اصلی، به یک آسانسور میرسد. همچنین متوجه شود که انتظار برای این آسانسور طولانیتر از آسانسوری است که در فاصله ۴۰۰ متری ورودی قرار دارد.
پس از ساخت مدل، ربات میتواند بین مکانهایی که مرتباً به آنها مراجعه میکند، مسیرهایی را بر اساس کوتاهترین مسافت، کمترین زمان یا کمترین میزان مانع انتخاب کند.
یادگیری تقویتی بدون مدل (Model-free RL)
یادگیری تقویتی بدون مدل زمانی مناسبتر است که محیط بزرگ، پیچیده و بهسختی قابل توصیف یا مدلسازی باشد. این روش همچنین برای محیطهایی مناسب است که ناشناخته و در حال تغییر هستند و انجام آزمایشهای مختلف در محیط هزینه زیادی ندارد.
در این روش، عامل یک مدل درونی از محیط پویا ایجاد نمیکند. در عوض، با استفاده از آزمونوخطا مستقیماً در محیط یاد میگیرد. عامل وضعیت-عملها و همچنین دنبالههایی از وضعیت-عملها را ارزیابی و ثبت میکند و از این تجربهها برای ایجاد یک سیاست استفاده میکند.
در مقایسه با روشهای مبتنی بر مدل، این روش به تعامل بسیار بیشتری با همان محیط نیاز دارد.
مثال
دوباره رباتی را در نظر بگیرید که باید در ساختمان مسیریابی کند. این بار ربات بهجای اینکه مدلی درونی از ساختمان، زمانهای شلوغی و رفتار آسانسورها ایجاد کند، روشهای مختلف مسیریابی را امتحان میکند و بر اساس کوتاهترین زمان رسیدن به مقصد، برای هر مسیر پاداش دریافت میکند.
هر بار تلاش، به ربات کمک میکند تا سیاستی برای رفتار بهینه ایجاد کند که زمان رسیدن به مقصد را کاهش دهد.
البته این روش به آزمایشهای بسیار بیشتری در دنیای واقعی نیاز دارد، اما در عوض، از خطاهایی که ممکن است در اثر مدلسازی نادرست محیط ایجاد شوند، جلوگیری میکند.
روشهای مونتکارلو (Monte Carlo Methods)
روشهای مونتکارلو مجموعهای از الگوریتمهای یادگیری تقویتی بدون مدل هستند که عمدتاً برای تخمین بازده بلندمدت (Long-term Return) استفاده میشوند.
این الگوریتمها دنبالههای طولانی از اقدامات و پاداشها را مشاهده میکنند و سپس نتایج حاصل از این دنبالهها یا اپیزودها را با یکدیگر میانگینگیری میکنند. این رویکرد با روش یادگیری تفاضل زمانی (TD) که بر بهروزرسانیهای گامبهگام تکیه دارد، تفاوت دارد.
روشهای مونتکارلو زمانی مفید هستند که بتوان یک اپیزود کامل را از ابتدا تا انتها مشاهده کرد.
مزایای یادگیری تقویتی چیست؟
استفاده از یادگیری تقویتی (RL) مزایای متعددی دارد که کسبوکارها میتوانند از آنها بهره ببرند.
عملکرد مؤثر در محیطهای پیچیده
میتوان از الگوریتمهای یادگیری تقویتی در محیطهای پیچیدهای استفاده کرد که قوانین و وابستگیهای متعددی دارند. حتی انسانها نیز ممکن است با وجود دانش گسترده درباره یک محیط، نتوانند بهترین مسیر را برای رسیدن به هدف تعیین کنند. در مقابل، الگوریتمهای RL میتوانند خود را با محیطهایی که بهطور مداوم تغییر میکنند، سازگار کنند و راهبردهای جدیدی برای بهینهسازی نتایج بیابند.
این مدلها با استفاده از چارچوب ریاضی فرایند تصمیمگیری مارکوف (MDP) میتوانند مسیری را پیدا کنند که تقریباً بهترین مسیر ممکن برای رسیدن به هدف موردنظر باشد.
نیاز کمتر به تعامل انسانی
در الگوریتمهای سنتی یادگیری ماشین، انسانها باید دادهها را برچسبگذاری کنند تا مسیر یادگیری الگوریتم را مشخص کنند. این رویکرد را یادگیری نظارتشده (Supervised Learning) مینامند. در یادگیری تقویتی، چنین فرایندی ضروری نیست و مدل میتواند بر اساس سیگنالهای پاداشی که انسانها طراحی کردهاند، بهصورت مستقل یاد بگیرد.
در عین حال، یادگیری تقویتی سازوکارهایی برای ادغام بازخورد انسانی نیز در اختیار میگذارد. به این ترتیب، میتوان سیستمهایی ساخت که خود را با ترجیحات، تخصص و اصلاحات انسانها تطبیق دهند.
بهینهسازی برای اهداف بلندمدت
یادگیری تقویتی ذاتاً بر بیشینهسازی پاداش در بلندمدت تمرکز دارد و به همین دلیل، برای موقعیتهایی مناسب است که اقدامات در کوتاهمدت نتیجه خود را نشان نمیدهند و پیامدهای آنها با تأخیر ظاهر میشود. این ویژگی بهویژه در موقعیتهای دنیای واقعی اهمیت دارد؛ جایی که برای هر مرحله نمیتوان یک پاداش فوری در نظر گرفت و عامل باید بتواند از پاداشهای تأخیری نیز یاد بگیرد.
برای مثال، تصمیمگیری درباره میزان مصرف یا ذخیرهسازی انرژی میتواند پیامدهایی بلندمدت داشته باشد. در چنین شرایطی، میتوان از یادگیری تقویتی برای بهینهسازی بهرهوری انرژی و کاهش هزینهها در بلندمدت استفاده کرد.
کشف سیاست تقریباً بهینه
یادگیری تقویتی میتواند از طریق تجربه، یک سیاست تقریباً بهینه را کشف کند، بدون اینکه این سیاست مستقیماً به عامل آموزش داده شود. عامل با کسب تجربه یاد میگیرد کدام اقدامات در بلندمدت بهترین نتایج را به دنبال دارند.
عامل بهجای تکیه بر قوانین از پیش تعیینشده، بازخورد حاصل از تابع پاداش را ارزیابی میکند تا در طول زمان به اقداماتی برسد که بیشترین پاداش تجمعی را ایجاد میکنند.
بسیاری از الگوریتمهای یادگیری تقویتی با استفاده از اصول فرایند تصمیمگیری مارکوف و یک تابع ارزش، پیامدهای آینده را تخمین میزنند. روشهایی مانند Q-learning نیز از همین فرایند تکرارشونده پشتیبانی میکنند و به عامل اجازه میدهند سیاستهایی را یاد بگیرد که میتوانند مسیرهای تقریباً بهینه را پیدا کنند.
سازگاری از طریق تعامل با محیط
بخش قابلتوجهی از مزایای یادگیری تقویتی به توانایی آن در بهبود عملکرد از طریق تعامل مداوم با محیط بازمیگردد. عامل با آزمونوخطا یاد میگیرد و بر اساس سیگنال پاداش، رفتار خود را بهتدریج اصلاح میکند. این چرخه سازگاری به سیستم اجازه میدهد خود را با شرایط در حال تغییر وفق دهد.
یادگیری تقویتی میتواند با آموزش عاملها روی دادههای زنده، بهصورت بلادرنگ با شرایط جدید سازگار شود. بااینحال، در برخی سناریوها میتوان از یادگیری تقویتی آفلاین (Offline Reinforcement Learning) نیز استفاده کرد و بدون تعامل زنده با محیط، سیاستهای عامل را بهبود داد. البته یادگیری آفلاین معمولاً عملکرد پایینتری دارد.
کاربردهای یادگیری تقویتی چیست؟
یادگیری تقویتی (RL) را میتوان در طیف گستردهای از مسائل و کاربردهای دنیای واقعی به کار گرفت. در ادامه، چند نمونه از این کاربردها را بررسی میکنیم.
شخصیسازی در بازاریابی
در کاربردهایی مانند سیستمهای پیشنهاددهنده (Recommendation Systems)، یادگیری تقویتی میتواند بر اساس تعاملات هر کاربر، پیشنهادها را شخصیسازی کند و تجربهای متناسبتر با نیازها و علایق او ارائه دهد.
برای مثال، یک برنامه میتواند در ابتدا بر اساس برخی اطلاعات جمعیتشناختی، محصولات خاصی را به کاربر نمایش دهد. با هر بار تعامل کاربر با یک محصول، برنامه یاد میگیرد چه محصولاتی را بهتر است به او پیشنهاد دهد تا فروش را بهینه کند. در این فرایند، سیستم هم راهبردهایی را که از قبل میشناسد به کار میگیرد و هم راهبردهای جدید را امتحان میکند تا اثربخشی آنها را با یکدیگر مقایسه کند.
مسائل بهینهسازی
روشهای سنتی بهینهسازی معمولاً با ارزیابی و مقایسه راهحلهای مختلف بر اساس معیارهای مشخص، بهترین راهحل را پیدا میکنند. در مقابل، یادگیری تقویتی با تکیه بر یادگیری از طریق تعامل، بهتدریج راهحلهایی را پیدا میکند که تقریباً بهینه هستند.
برای مثال، ممکن است یک سیستم بهینهسازی هزینههای رایانش ابری آنقدر پیچیده باشد که نتوان آن را بهسادگی با روشهای سنتی بهینهسازی مدل کرد. در چنین شرایطی، یادگیری تقویتی میتواند خود را با تغییرات نیازهای منابع تطبیق دهد و نوع، تعداد و پیکربندی بهینه نمونههای محاسباتی را انتخاب کند.
این سیستم هنگام تصمیمگیری عواملی مانند زیرساخت ابری موجود و در دسترس، هزینهها، عملکرد و میزان استفاده از منابع را در نظر میگیرد.
پیشبینیهای مالی
پویایی بازارهای مالی پیچیده است و ویژگیهای آماری آنها نیز در طول زمان تغییر میکند. الگوریتمهای یادگیری تقویتی میتوانند با در نظر گرفتن هزینههای معاملات و سازگار شدن با تغییرات بازار، به دنبال بهینهسازی بازدهی در بلندمدت باشند.
برای مثال، یک الگوریتم میتواند وضعیتها و الگوهای بازار سهام را مشاهده کند، سپس اقدامات مختلف را امتحان کرده و پاداش مرتبط با هر اقدام را ثبت کند. الگوریتم بهتدریج یک تابع ارزش ایجاد میکند و بر اساس آن، یک راهبرد معاملاتی توسعه میدهد.
البته استفاده از یادگیری تقویتی در بازارهای مالی چالشبرانگیز و پیچیده است، زیرا تعداد عواملی که میتوانند بر بازار تأثیر بگذارند، تقریباً بینهایت است.