
واژهنامه
رگرسیون (Regression) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
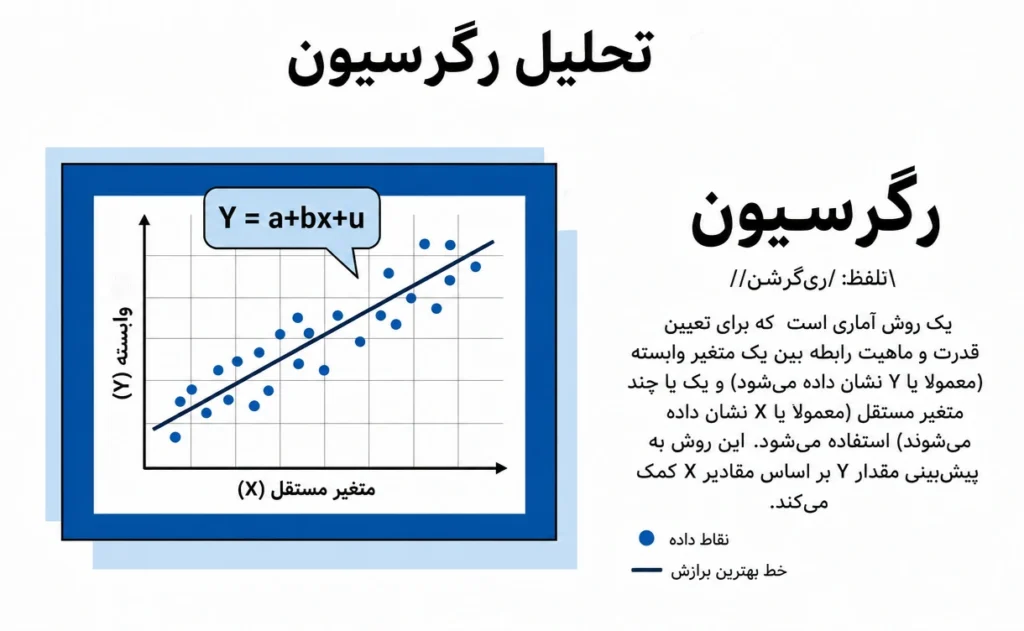
تحلیل رگرسیون یک روش آماری است که به بررسی رابطه بین یک متغیر وابسته و یک یا چند متغیر مستقل میپردازد. معمولاً متغیر وابسته با حرف (Y) و متغیر مستقل با (X) نشان داده میشود.
به زبان سادهتر، میتوانید رگرسیون را راهی برای پیشبینی یک نتیجه در آینده بر اساس رویدادهای مشابه در گذشته (یعنی بر اساس مجموعهدادههای موجود) بدانید. ما میتوانیم از این مدل ریاضی برای پیشبینی خروجی (متغیر وابسته) بر اساس ورودی یا تغییرات سایر متغیرها (متغیرهای مستقل) استفاده کنیم. در مدل «رگرسیون خطی»، خروجی پیوسته است و با ایجاد معادله خط، مقادیر آینده پیشبینی میشوند. در مدل «رگرسیون لجستیک»، خروجی یک رویداد دستهای مشخص (مانند بله/خیر یا قبول/مردود) است و احتمال وقوع خروجی در یک دسته خاص پیشبینی میشود.
پژوهشگران از تحلیل رگرسیون برای تعیین این موضوع نیز استفاده میکنند که کدام متغیرهای مستقل بر متغیر وابسته اثر میگذارند. اگر فکر میکنید مجموعهای از متغیرها روی نتیجه اثرگذارند، میتوانید با این تحلیل مشخص کنید کدام متغیرها بیشترین اهمیت و اثر را روی خروجی مدل دارند.
مفاهیم پایهای
در تحلیل رگرسیون با مجموعهای از مفاهیم کلیدی کار میکنید که درک آنها به طراحی و کاربرد مدل کمک میکند: متغیرهای مستقل، متغیرهای وابسته، همبستگی و علیت.
- متغیرهای مستقل (Independent variables): در مدل رگرسیون، متغیرهای مستقل یا توضیحی عواملی هستند که فکر میکنید روی متغیر هدف اثر میگذارند. همانطور که از نامشان پیداست، این متغیرها مستقل هستند و پژوهشگر میتواند با تغییر آنها، تغییرات متغیر وابسته را بررسی کند. (مثال: برای پیشبینی احتمال ابتلای فرد به بیماری، متغیرهای مستقل میتوانند سن، وضعیت سلامت، سطح فعالیت و شاخصهای زیستی باشند.)
- متغیرهای وابسته (Dependent variables): متغیر وابسته یا متغیر پاسخ، همان خروجی مدل است؛ متغیری که هدف شما درک، پیشبینی یا توضیح آن است و مقدارش به تغییر متغیرهای مستقل بستگی دارد. (مثال: در یک سناریوی تجاری، متغیر وابسته میتواند «میزان فروش» باشد که به بودجه بازاریابی، قیمتگذاری و رقبا بستگی دارد.)
- همبستگی (Correlation): معیاری آماری است که شدت رابطه بین چند متغیر را نشان میدهد و با ضریب همبستگی بین ۱- تا ۱+ بیان میشود. مقدار مثبت یعنی هر دو متغیر با هم افزایش یا کاهش مییابند؛ مقدار منفی یعنی با افزایش یکی، دیگری کاهش مییابد؛ و مقدار صفر به معنی عدم وجود همبستگی است.
نکته مهم
همبستگی به معنای علیت نیست.
- علیت (Causation): همبستگی صرفاً نشاندهنده رابطه و تغییر همزمان دو متغیر است، اما علیت یعنی تغییر در یک متغیر مستقیماً باعث تغییر در متغیر دیگر میشود. اثبات علیت نیازمند فرضیات و تحلیلهای بسیار دقیقتری نسبت به همبستگی است.
تحلیل رگرسیون چگونه کار میکند؟
این تحلیل با دادهها آغاز میشود. با استفاده از دادهها، مدلی ریاضی (معمولاً یک خط یا منحنی) ساخته میشود که بهترین نمایشدهنده رابطه میان متغیرها است.
پس از دریافت پیشبینی، با بررسی «خطای استاندارد» (Standard Error) میتوان دقت و اعتبار مدل را سنجید و فاصله اطمینان مناسبی برای ضرایب تعیین کرد. همچنین میتوان با بررسی معیارهای آماری مشخص کرد که هر متغیر مستقل چقدر در پیشبینی دقیق متغیر پاسخ نقش دارد.
تحلیل رگرسیون
واژه «رگرسیون» (بازگشت/پسرفت) به قرن نوزدهم بازمیگردد. سر فرانسیس گالتون، دانشمند بریتانیایی، در مطالعات وراثت متوجه شد که ویژگیهای افراطی والدین تمایل دارد در فرزندان به سمت میانگین جامعه «پسرفت» کند؛ از این رو نام رگرسیون را بر آن نهاد شد.
کاربردهای تحلیل رگرسیون
- اقتصاد: پیشبینی الگوی مخارج خانوار بر اساس موقعیت مکانی، تعداد فرزندان و درآمد.
- علوم سیاسی: تعیین بودجه مورد نیاز یک برنامه دولتی بر اساس نیازهای سالهای گذشته.
- جامعهشناسی: بررسی ارتباط جایگاه اجتماعی دانشگاهها با الگوی درخواستهای پذیرش.
- روانشناسی: سنجش رابطه میزان پذیرش فرد با پیشینه فرهنگی او.
- کسبوکار: درک چگونگی اثرگذاری شیوههای مدیریتی بر فروش یا ماندگاری کارکنان.
- آموزش: پیشبینی معدل دانشآموز بر اساس فعالیتهای فوقبرنامه.
- بهداشت و درمان: پیشبینی احتمال بهبودی بیمار بر اساس سن، فشار خون، وزن و سابقه پزشکی.
مزایا و معایب تحلیل رگرسیون
مزایا:
- قابلیت کمیسازی، مدلسازی و پیشبینی روابط میان متغیرها.
- انعطافپذیری بالا و توانایی تحلیل همزمان چندین متغیر مستقل در سناریوهای پیچیده.
معایب و چالشها:
- عدم اثبات قطعی علیت در شرایط عادی.
- بیشبرازش (Overfitting): انطباق بیش از حد روی دادههای آموزشی و ناتوانی در تعمیم به دادههای جدید.
- ناهمسانی واریانس (Heteroskedasticity): غیرثابت بودن واریانس جملات خطا که دقت فواصل پیشبینی را کاهش میدهد.
- همخطی چندگانه (Multicollinearity): همبستگی شدید بین متغیرهای مستقل که نتایج را مخدوش میکند.
- دادههای گمشده (Missing data): کاهش حجم نمونه موثر و افت توان آماری.
- حجم نمونه کوچک: ایجاد نتایج اریب و غیرقابل اتکا.
- توان آماری پایین (Low power): کاهش احتمال دستیابی به یافتههای معنادار