
ما از مدلهای زبانی بزرگ LLM مانند چکش برای هر مسئله هوش مصنوعی، حتی تصمیمات ساده، استفاده کردهایم. Jev این تصمیمات را در عرض چند میلیثانیه و با کسری از هزینه انجام میدهد. بیایید بفهمیم که چگونه کار میکند و کجا مناسب است.
شرکت TypeSafe AI، Jev را در ۱۵ سپتامبر ۲۰۲۶ منتشر کرد و واکنشها برای مدلی که نمیتواند مکالمهای را مدیریت کند، کد بنویسد یا حتی یک پاراگراف مفید تولید کند، به طور غیرمعمولی قوی بود.
خب، نکته همین محدودیت است.
اکثر نرمافزارها به چتبات دیگری نیاز ندارند. بلکه باید هزاران قضاوت کوچک انجام دهند، برای مثال: آیا این تیکت فوری است؟ کدام مدل باید این درخواست را مدیریت کند؟ آیا این دستور shell خطرناک است؟ آیا این متن بازیابی شده به سوال پاسخ میدهد؟
تیمها اغلب هر قضاوت را به یک LLM عمومی ارسال میکنند. مدل، پاسخ را به صورت توکن به توکن تولید میکند، برنامه آن را تجزیه و تحلیل میکند، اعتبارسنجی میکند و در صورت اشتباه بودن شکل، دوباره تلاش میکند. این روش جواب میدهد، اما برای تصمیمگیری با پنج پاسخ ممکن، کند و پرهزینه است.
Jev به طور خاص برای این تصمیمات ساخته شده است. TypeSafe آن را یک مدل سیستم یک مینامد: حالت بدون ساختار وارد میشود، پاسخهای تایپ شده و احتمالات بیرون میآیند.
بیایید توضیح دهیم که این به چه معناست، کجا کاربرد دارد و بازاریابی در کجا به کمی محدودیت نیاز دارد.
مشکلی که Jev حل میکند
اتصال LLMها به نرمافزارها با ظهور فراخوانی ابزار و خروجیهای ساختاریافته بسیار آسانتر شد.
فراخوانی ابزار به مدل اجازه میدهد تا تابعی را به شکلی قابل پیشبینی درخواست کند. خروجیهای ساختاریافته به آن اجازه میدهند JSON را که از یک طرحواره پیروی میکند، برگرداند. هر دو مقدار زیادی از تجزیه و تحلیل شکننده را حذف کردند.
اما مدل زیربنایی هنوز مولد است. حتی وقتی جواب فقط یک کلمه «billing» باشد، توکنها را به صورت متوالی تولید میکند. شما برای ورودی هزینه پرداخت میکنید، منتظر تولید آن هستید و اغلب برای خروجی هزینه بیشتری پرداخت میکنید.
حالا آن را درون یک حلقه عامل قرار دهید.
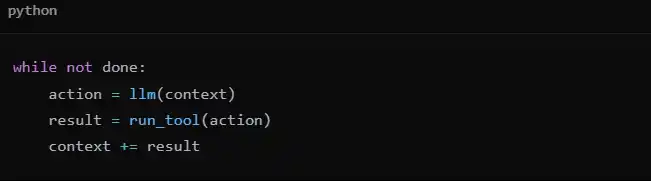
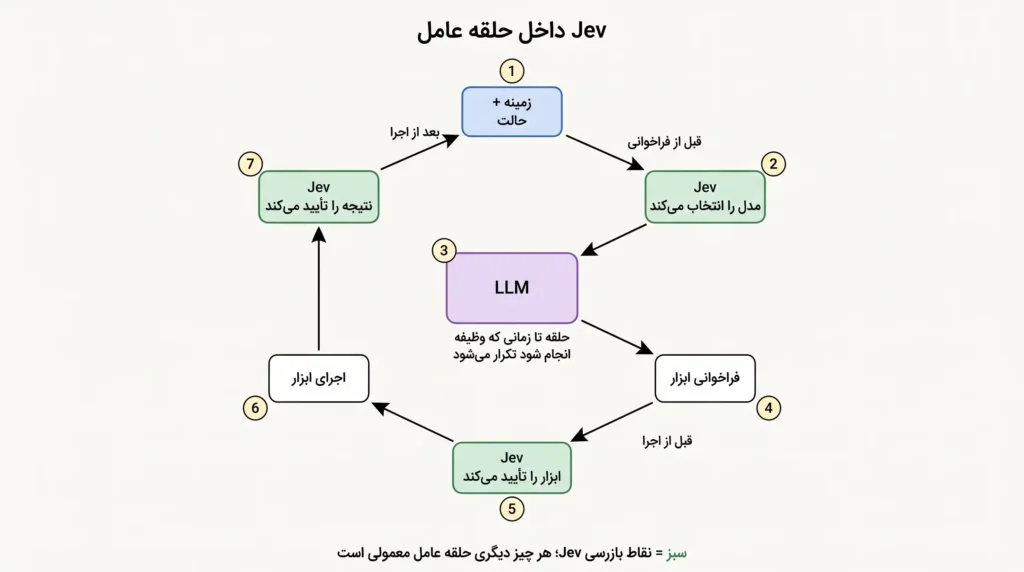
این مدل ممکن است دوباره برای انتخاب یک ابزار، قضاوت در مورد نتیجه، تشخیص ریسک، تصمیمگیری در مورد تکمیل وظیفه و انتخاب مدل بعدی فراخوانی شود. اجرای یک عامل واحد ممکن است شامل فراخوانیهای بسیاری باشد که نیاز به قضاوت دارند اما هیچ نثر تولید شدهای ندارند. jev آن تماسها را هدف قرار میدهد.
شرطش ساده است: تولید زبان، رابط کاربری اشتباهی است وقتی کد از قبل پاسخهای ممکن را میداند.
جو واقعاً چیست؟
کوتاهترین توصیف دقیق، یک موتور تصمیمگیری معنایی است.
تو دو چیز برای jev میفرستی:
- وضعیت: متن یا JSON که وضعیت فعلی را توصیف میکند.
- سوالات: تصمیماتی که میخواهید در مورد آن ایالت بگیرید.
هر سوال از قبل شکل پاسخ خود را اعلام میکند. Jev از سه نوع داده اولیه پشتیبانی میکند:
- تابع Choice یک گزینه را از لیستی که شما تعریف میکنید انتخاب میکند و برای هر گزینه یک احتمال برمیگرداند.
- امتیاز، ورودی را در مقیاس مرتبی که شما تعریف میکنید، مانند کم، متوسط و زیاد، قرار میدهد.
- نول با برگرداندن احتمال درست بودن یک سوال بله یا خیر، به آن پاسخ میدهد.
Noul نامی است که TypeSafe برای نوع دادهی اولیهی Boolean-style انتخاب کرده است. این نام غیرمعمول اهمیت کمتری نسبت به خروجی (عددی بین ۰ و ۱ که کد شما میتواند روی آن عمل کند) دارد.
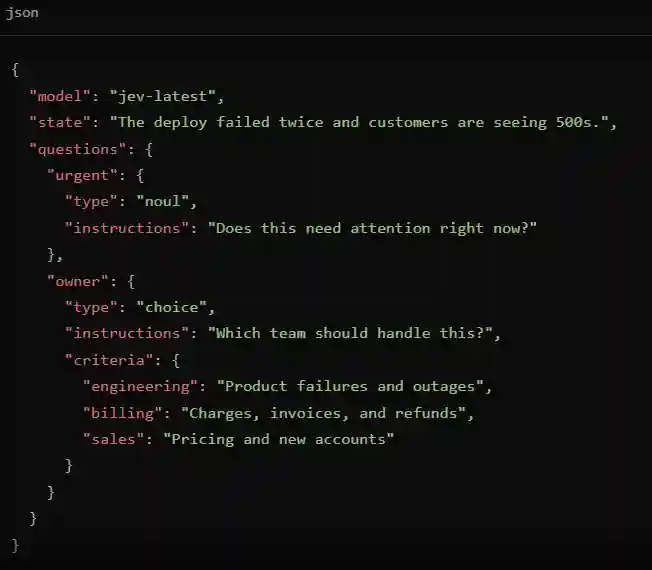
این پاسخ شامل احتمال فوریت و توزیع احتمال بین سه تیم است. هیچ پاراگرافی برای تفسیر و هیچ تیم چهارمی برای ابداع مدل وجود ندارد.
برنامه شما کنترل را در دست دارد:
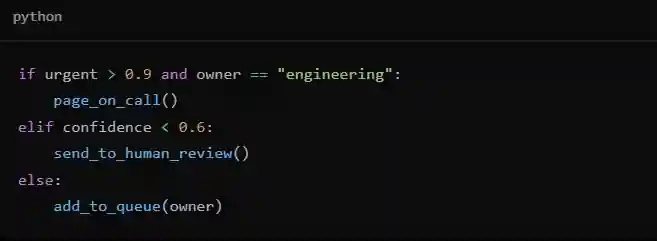
به همین دلیل است که مردم مدام Jev را یک عبارت سوئیچ هوشمند مینامند. این عبارت تحقیرآمیز به نظر میرسد، اما بخش مفید طراحی را در بر میگیرد. کد معمولی مالک شاخهها است. این مدل این قضاوت مبهم را ارائه میدهد که کد معمولی نمیتواند به طور قابل اعتمادی محاسبه کند.
تفاوت مهم Jev با LLM
یک LLM معمولی و Jev هر دو میتوانند یک تیکت پشتیبانی را دستهبندی کنند، اما روش رسیدن آنها به پاسخ متفاوت است و هرکدام در بخش متفاوتی از یک سیستم کاربرد دارند.
TypeSafe میگوید Jev همه سوالهای یک درخواست را بهصورت موازی بررسی میکند. این موضوع نحوه طراحی گردش کار را تغییر میدهد.
بهجای اینکه یک سوال بپرسید، منتظر بمانید و بعد تصمیم بگیرید سوال بعدی چه باشد، همه سوالهای مستقلی را که درباره یک وضعیت دارید، در یک درخواست مطرح کنید و اجازه دهید کد از پاسخهای موردنیاز استفاده کند.
این شرکت زمان تأخیر سرتاسری Jev را بین ۷۰ تا ۵۰۰ میلیثانیه و قیمت آن را ۰٫۰۴۲ دلار به ازای هر یک میلیون توکن ورودی اعلام کرده است؛ خروجی نیز رایگان است.
ادعاهای اصلی شرکت میگویند Jev در برخی مقایسهها تقریباً ۲۰۰ برابر سریعتر و ۴۰۰ برابر ارزانتر از گردشکارهای مشابه مبتنی بر LLM است.
این ضرایب بزرگ بر اساس ارزیابیهای گردشکار خود TypeSafe به دست آمدهاند و در بهترین شرایط مقایسه قرار دارند. بنابراین بهتر است آنها را سقف عملکرد بدانیم، نه وعدهای برای هر برنامه.
بااینحال، مزیت اصلی همچنان قابلاعتماد به نظر میرسد: Jev برای تصمیمهای محدود ساخته شده و از زنجیرههای طولانی استدلال و تولید خروجی متنی اجتناب میکند.
چرا احتمالها اهمیت دارند؟
یک پاسخ نوعدار فقط نیمی از مشکل را حل میکند.
فرض کنید Jev یک تیکت را به بخش مالی ارسال کند. برچسب انتخابشده نشان میدهد کدام گزینه برنده شده است، اما توزیع احتمال نشان میدهد رقابت بین گزینهها چقدر نزدیک بوده است.
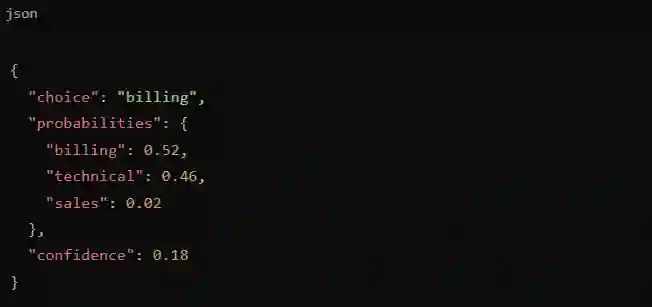
ارسال خودکار آن تیکت بیاحتیاطی خواهد بود. بیلینگ برنده شد، اما به سختی. یک پاسخ با اطمینان پایین باید باعث ایجاد یک شاخه متفاوت شود.
این به توسعهدهندگان یک الگوی عملی میدهد:
- اعتماد به نفس بالا: وقتی پیامد کوچک است، به طور خودکار عمل کنید.
- اعتماد به نفس متوسط: درخواست تایید کنید یا با یک مدل قویتر تماس بگیرید.
- اطمینان کم: پرونده را برای یک شخص بفرستید یا اطلاعات بیشتری جمعآوری کنید.
آستانهها به کد تعلق دارند، جایی که میتوان آنها را بررسی و تغییر داد. برچسب داشبورد ممکن است پیشبینی ضعیفی را تحمل کند. دستوری که دادهها را حذف میکند باید به نوار بسیار بالاتری نیاز داشته باشد.
TypeSafe با استفاده از یادگیری تقویتی برای تصمیمات کالیبره شده یا RLCD، Jev را آموزش میدهد. هدف این است که اطمینان، دقت را در پیشبینیهای متعدد منعکس کند. اگر یک مدل مجموعهای از پاسخها را با احتمال ۹۰ درصد ارائه دهد، تقریباً ۹۰ درصد از آن پاسخها باید صحیح باشند.
ادعای توهم نیاز به دقت دارد
TypeSafe میگوید Jev نمیتواند توهم داشته باشد. این گفته فقط تحت یک تعریف محدود درست است.
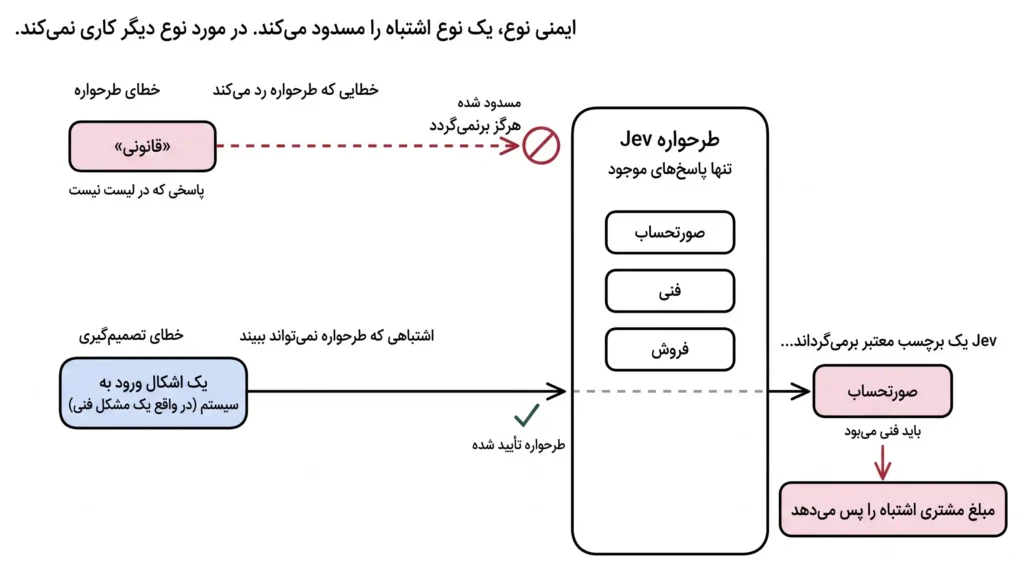
Jev نمیتواند گزینهای خارج از طرحواره را برگرداند. اگر شما صورتحساب، فنی و فروش را تعریف کنید، پاسخ نمیتواند قانونی را اختراع کند. همچنین نمیتواند نثر ناقصی را در جایی که کد شما انتظار یک برچسب را داشت، تولید کند.
اما میتواند با اطمینان گزینهی معتبر اشتباه را انتخاب کند.
ایمنی نوع از اشکال نامعتبر جلوگیری میکند. این امر قضاوت صحیح را تضمین نمیکند. این تمایز مهم است زیرا یک اشتباه معتبر در طرحواره همچنان میتواند مشتری اشتباه را بازپرداخت کند، یک حادثه را به اشتباه مسیریابی کند یا یک دستور خطرناک را تأیید کند.
جملهی امنتر این است: «Jev نمیتواند طرح خروجی اعلامشده را بشکند، اما همچنان میتواند اشتباه باشد».
Jev در کجای یک عامل هوش مصنوعی قرار میگیرد؟
Jev زمانی بهترین عملکرد را دارد که در کنار یک LLM استفاده شود، نه بهجای آن.
LLM کارهایی را انجام میدهد که به زبان یا استدلال عمیقتر نیاز دارند. این کارها شامل برنامهریزی، نوشتن، توضیحدادن و استفاده از ابزارهاست.
Jev تصمیمهای پرتکراری را که اطراف این کارها وجود دارند، انجام میدهد.
سه جایگاه برای استفاده از Jev، جذابتر از بقیه هستند.
۱. مسیریابی مدل
یک جستوجوی ساده به همان مدلی نیاز ندارد که برای بررسی معماری نرمافزار استفاده میشود.
Jev میتواند درخواست را امتیازدهی کند و ارزانترین مدلی را انتخاب کند که احتمالاً قادر است کار را انجام دهد.
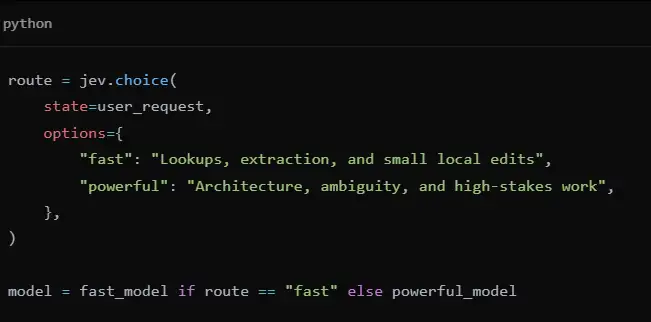
روتر به درخواست پاسخ نمیدهد. فقط تصمیم میگیرد کدام مدل باید پاسخ را تولید کند.
۲. کنترل خطر ابزارها
قبل از اینکه یک عامل یک دستور shell را اجرا کند، Jev میتواند آن را به عنوان فقط خواندنی، برگشتپذیر یا مخرب طبقهبندی کند. سوالات جداگانه میتوانند بررسی کنند که آیا فایلها را حذف میکند، تاریخچه Git را تغییر میدهد، به تولید دست میزند یا مخزن را ترک میکند.
اقدامات فقط خواندنی با اطمینان بالا میتوانند ادامه یابند. اقدامات مخرب یا نامشخص میتوانند برای تأیید انسان متوقف شوند. ادغام Jev در LangChain این الگو را از طریق میانافزاری اعمال میکند که فراخوانی ابزار را قبل از اجرا بررسی میکند.
۳. راستیآزمایی و نظارت
یک عامل میتواند ادعا کند که یک وظیفه به پایان رسیده است در حالی که آزمایشها هنوز با شکست مواجه میشوند. Jev میتواند وضعیت را بررسی کند و به سوالات محدود پاسخ دهد: آیا آزمایشها با موفقیت انجام شدند؟ آیا عامل همان عمل را تکرار میکند؟ آیا خروجی از سیاست پیروی میکند؟ آیا این نتیجه باید بررسی شود؟
این جایگزین یک آزمون سخت، در صورت وجود، نخواهد شد. بلکه یک بررسی معنایی اضافه میکند که در آن، قاعده به معنا بستگی دارد.
مشکلاتی که Jev امروز میتواند حل کند
بهترین موارد استفاده سه ویژگی مشترک دارند. میتوانید پاسخهای ممکن را نام ببرید، یک انسان دقیق میتواند ورودی را به سرعت قضاوت کند، و تصمیمگیری به اندازه کافی اتفاق میافتد که تأخیر یا هزینه اهمیت پیدا کند.
پشتیبانی و عملیات
- قصد، فوریت، بخش، هرزنامه و ناامیدی مشتری را طبقهبندی کنید.
- بازپرداخت وجه و استثنائات بیمهنامه از طریق چندین چک کوچک.
- قبل از اینکه شخصی آنها را بخواند، گزارشها و حوادث را بر اساس شدت معنایی رتبهبندی کنید.
یک درخواست واحد میتواند تمام این سوالات را در مورد یک تیکت بپرسد. سپس کد، پاسخها را در سیاست مسیریابی واقعی شرکت ترکیب میکند.
جستجو و بازیابی
- متنهای بازیابی شده را بر اساس اینکه آیا به پرسش پاسخ میدهند یا خیر، مجدداً رتبهبندی کنید.
- بررسی کنید که آیا یک استناد از یک ادعا پشتیبانی میکند یا خیر.
- قبل از ارسال متن به یک LLM گرانقیمت، بخشهای نامربوط را فیلتر کنید.
جاسازیها در یافتن متنهای مرتبط از نظر معنایی عالی هستند. Jev میتواند تصمیم دقیقتری در مورد اینکه آیا یک متن خاص برای این سوال مفید است یا خیر، بگیرد.
کیفیت و ایمنی
- صفحه نمایش درخواستهایی برای جیلبریک یا تزریق سریع میدهد.
- محتوای تولید شده را با یک سیاست یا دستورالعمل خاص بررسی کنید.
- تغییرات کد یا فراخوانیهای ابزار پرخطر را قبل از اجرا، علامتگذاری کنید.
این بررسیها باید در کنار کنترلهای قطعی قرار گیرند. یک طبقهبندیکننده معنایی برای ریسک فازی مفید است، در حالی که مجوزها، جعبههای شنی و آزمایشها قوانینی را اعمال میکنند که نرمافزار میتواند دقیقاً آنها را تأیید کند.
طبقه بندی حجم بالا
- اسناد، مقالات تحقیقاتی، فهرست محصولات یا پیامهای مشتریان را برچسبگذاری کنید.
- متنهای رایگان را به ویژگیهایی برای یک مدل یادگیری ماشینی سنتی تبدیل کنید.
- به هر مورد در یک مجموعه بزرگ، در برابر یک معیار نمره بدهید.
اینجاست که هزینه پایین به ازای هر تماس، چیزی بیش از یک عدد معیار میشود. قضاوتی که برای اجرا در هر سطر بسیار پرهزینه بود، میتواند به خط داده معمولی منتقل شود.
رابطهای بلادرنگ
- اقدام بعدی مرورگر را از بین عناصر شناخته شده صفحه انتخاب کنید.
- هنگام نوشتن، به لحن یا وضوح نوشته امتیاز دهید.
- یک عمل را از حالت بازی یا شبیهساز ساختاریافته انتخاب کنید.
Jev امروزه فقط متن است، بنابراین این سیستمها ابتدا باید محیط را به متن یا JSON تبدیل کنند. این به صفحه نمایش نگاه نمیکند یا از پیکسلها بازی نمیکند.
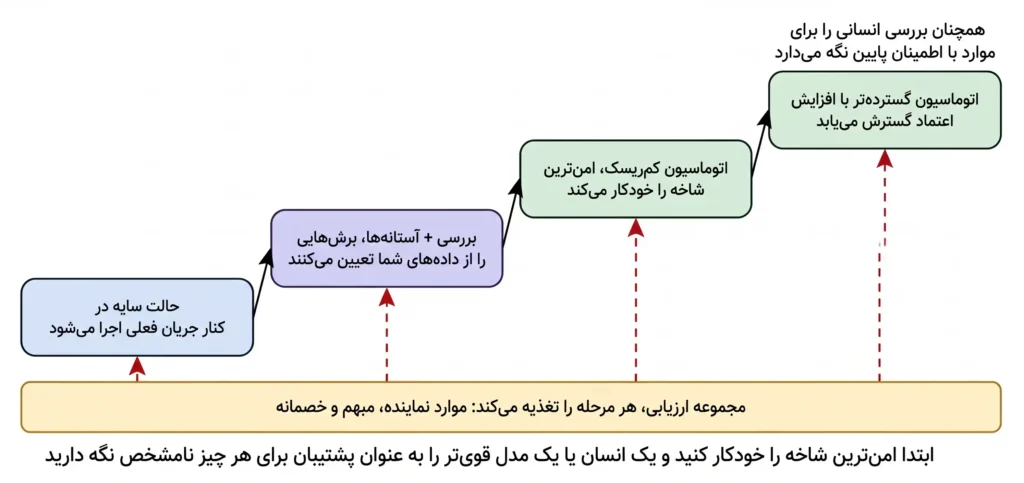
نحوه استفاده از Jev بدون ایجاد حالت خرابی جدید
یک مدل ارزان قیمت اگر اشتباهاتش باعث تکرار، بررسی دستی یا حوادث تولید شود، همچنان میتواند گران باشد. کل گردش کار را بسنجید، نه قیمت توکن را.
یک انتشار معقول به این شکل است:
- یک تصمیم محدود و کمخطر با پاسخهای احتمالی واضح انتخاب کنید.
- قبل از فراخوانی مدل، روبریک را بنویسید. مشخص کنید که هر گزینه به چه چیزی تعلق دارد.
- نمونههای معرف را با پاسخهای مورد انتظار، از جمله موارد مبهم و متضاد، جمعآوری کنید.
- Jev را در حالت سایه در کنار گردش کار فعلی اجرا کنید، بدون اینکه اجازه دهید رفتار آن تغییر کند.
- دقت را در مقابل اطمینان رسم کنید و آستانهها را از دادههای خود تعیین کنید.
- ابتدا امنترین شاخه را خودکار کنید و برای موارد نامشخص، یک مدل انسانی یا قویتر را نگه دارید.
- نسخه مدل، سوالات، معیارها و آستانهها را پین یا ثبت کنید تا تغییرات بتوانند در همان مجموعه ارزیابی تکرار شوند.
سوالات بخشی از برنامه هستند. با آنها مانند کد رفتار کنید: آنها را نسخهبندی کنید، بررسی کنید و هر زمان که مدل یا روبریک تغییر کرد، آنها را آزمایش کنید.
مورد استفاده که اکنون با Jev ساخته شده است
من jev را وادار به صحبت کردم و مقالهای در مورد آن نوشتم. برای انتشار آن در arXiv، به یک تأییدکننده برای csCL از کسی نیاز دارم که بیش از ۳ مقاله arXiv در هر دسته از علوم کامپیوتر داشته باشد و بین ۳ ماه تا ۵ سال پیش ارسال شده باشد. با یک کلیک، کد و مقاله را برای شما ارسال میکنم. یا شاید کسی که میشناسید.
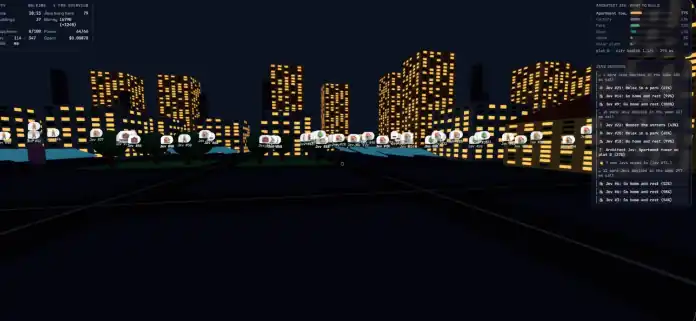
شهری با jev، برای jev ساختم. یک جِو معمار است. هر خانهای که در آن قرار میگیرد، جِوهایی را به وجود میآورد که در آنجا زندگی میکنند. هر کدام از آنها از مدل جِو واقعی میپرسند که در مرحله بعد چه کاری انجام دهد: بخوابد، کار کند، غذا بخورد، پرسه بزند. ۷۹ جِو، یک فراخوانی API در هر تیک، حدود ۳۵۰ میلیثانیه، مجموعاً ۰.۰۰۹ دلار تا الان. رضایت ۰ از ۱۰۰، همه ساعت ۲۰:۲۳ به خانه میروند. قابل درک است. جِوها در حال تکامل هستند.
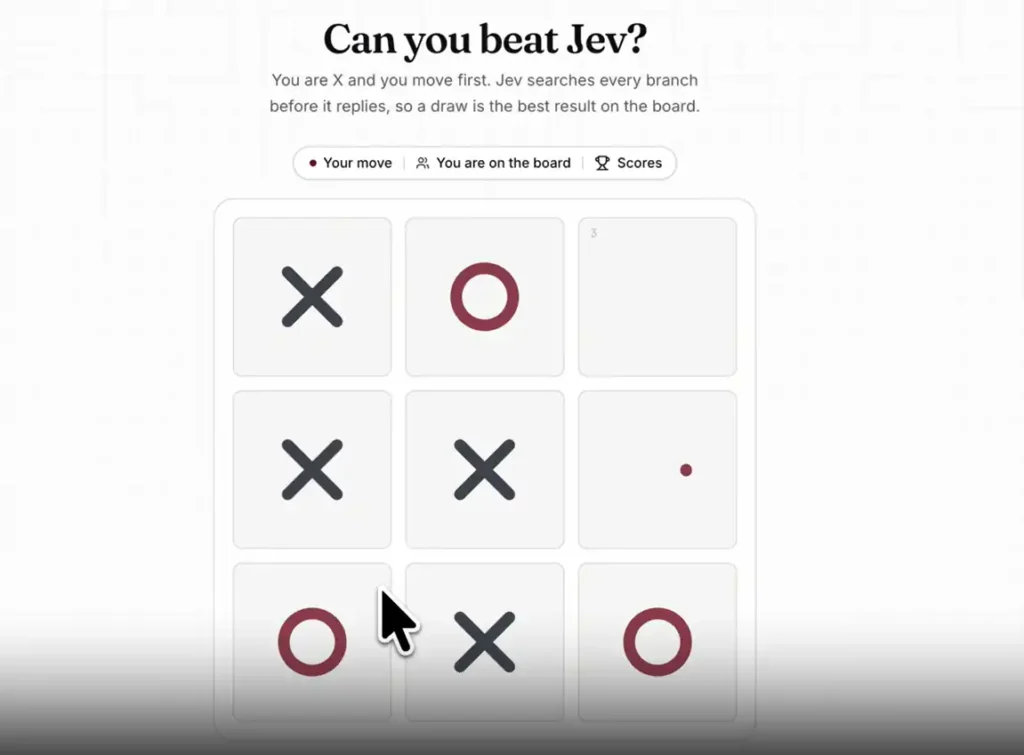
من یک بازی تیک-تاک-تو ساختم که در آن میتوانید تک به تک با حریف خود رقابت کنید، اما هرگز نمیتوانید آن را شکست دهید زیرا همیشه تصمیمات درست را میگیرد. به علاوه، با اجازه دادن به شما برای شروع بازی، به شما یک امتیاز میدهد.
برای دیدن تجربه دیگران، اینجا کلیک کنید.


دیدگاهتان را بنویسید