
واژهنامه · فنی
شبکه عصبی کانولوشن (CNN) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
شبکه عصبی کانولوشنی (CNN)، نوعی الگوریتم یادگیری عمیق (Deep Learning) است که برای تحلیل دادههایی مانند تصاویر و ویدئوها استفاده میشود.
تعریف تخصصی شبکه عصبی کانولوشن (CNN)
شبکه عصبی زیرمجموعهای از یادگیری ماشین هستند و هسته اصلی الگوریتمهای یادگیری عمیق را تشکیل میدهند. این شبکهها از چندین لایه از گرهها (Nodes) تشکیل شدهاند که شامل یک لایه ورودی، یک یا چند لایه پنهان و یک لایه خروجی هستند. هر گره به گرههای دیگر متصل است و وزن (Weight) و آستانه (Threshold) مختص به خود را دارد. اگر خروجی هر گره از مقدار آستانه تعیینشده بیشتر باشد، آن گره فعال میشود و دادهها را به لایه بعدی شبکه ارسال میکند. در غیر این صورت، هیچ دادهای به لایه بعدی شبکه منتقل نمیشود.
شبکه عصبی کانولوشن چگونه کار میکنند؟
شبکه عصبی کانولوشن (CNN) تصاویر ورودی را با عبور دادن آنها از چندین لایه پردازش میکنند. لایههای اولیه ویژگیهای سادهای مانند لبهها و خطوط را شناسایی میکنند، در حالی که لایههای عمیقتر الگوهای پیچیدهتر و شکلها را تشخیص میدهند و در نهایت به شناسایی کل اشیاء میرسند. این روشِ استخراج سلسلهمراتبی (Hierarchical) ویژگیها، یکی از دلایلی است که شبکه عصبی کانولوشن (CNN) را برای تشخیص تصاویر و سایر وظایف بینایی ماشین (Computer Vision) بسیار مؤثر میکند.
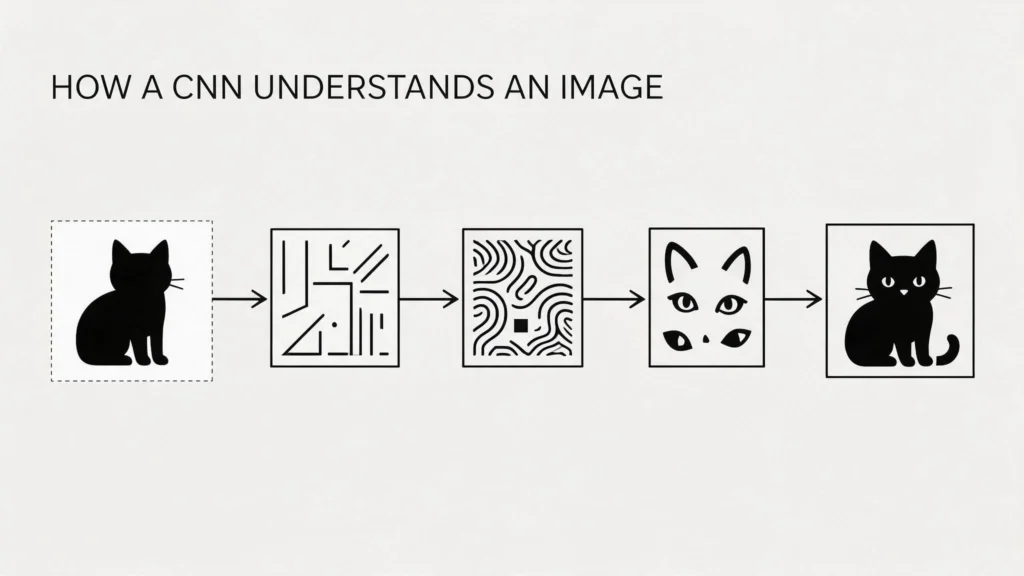
لایههای شبکه CNN
یک شبکه CNN را مانند تیمی از متخصصان در نظر بگیرید که یک عکس را برای شناسایی یک شیء تحلیل میکنند. هر لایه وظیفه خاصی در این فرایند تشخیص بر عهده دارد:
۱. لایه کانولوشن (Convolutional layer) : اسکنرهای ویژگی
این لایه مانند اولین گروه از متخصصان عمل میکند. هر یک از آنها به دنبال یک ویژگی ساده و مشخص، مانند یک لبه صاف، یک منحنی یا یک رنگ خاص، میگردد. آنها یک ذرهبین کوچک که همان «فیلتر» است را روی بخشهای مختلف تصویر حرکت میدهند و هر بار که ویژگی موردنظر خود را پیدا میکنند، آن را ثبت میکنند. نتیجه این فرایند مجموعهای از نقشههای ویژگی (Feature maps) است که محل قرارگیری این ویژگیهای اساسی را نشان میدهند.
۲. لایه فعالسازی (ReLU) : فیلتر اهمیت
پس از اسکن اولیه، یک مدیر، یعنی تابع ReLU، نقشههای ویژگی را بررسی میکند. وظیفه آن ساده است: سیگنالهای قوی را حفظ و سیگنالهای ضعیف را حذف کند. این لایه خاصیت غیرخطی (Non-linearity) را به سیستم اضافه میکند و باعث میشود ویژگیهای مهم و بهوضوح شناساییشده برای تحلیل بیشتر به مراحل بعد منتقل شوند. این کار از ایجاد اختلال توسط نویزها (Noise) در فرایند جلوگیری میکند.
۳. لایه ادغام/پولینگ (Pooling layer) : خلاصهکنندهها
لایه پولینگ مانند یک مدیر منطقهای عمل میکند. این لایه بهجای بررسی تکتک جزئیات، اطلاعات موجود در بخشهای کوچک نقشه ویژگی را خلاصه میکند. برای مثال، یک لایه مکس پولینگ (Max pooling) یک ناحیه ۲ در ۲ از نقشه ویژگی را بررسی میکند و تنها قویترین سیگنال را گزارش میدهد. این کار اندازه کلی دادهها را کاهش میدهد، شبکه را کارآمدتر میکند و به آن کمک میکند تا یک شیء را بدون توجه به محل قرارگیری آن در کادر تشخیص دهد؛ مفهومی که تغییرناپذیری انتقالی (Translational invariance) نام دارد.
۴. لایه کاملاً متصل (Fully connected layer) : کارآگاه ارشد
پس از چندین مرحله اسکن و خلاصهسازی، گزارشهای نهایی ویژگیها به کارآگاه ارشد تحویل داده میشوند. این لایه ویژگیهای سطح بالا، مانند «سبیل دارد»، «گوشهای نوکتیز دارد» و «بافت خز دارد» را با یکدیگر ترکیب میکند و تصمیم نهایی را میگیرد. در واقع، تمام یافتههای خلاصهشده را به هم مرتبط میکند تا به یک نتیجه برسد؛ برای مثال: «بر اساس تمام شواهد، شیء موجود در این تصویر یک گربه است.» سپس نتیجه به یک لایه خروجی نهایی، مانند تابع Softmax، منتقل میشود که برای هر دستهبندی ممکن، یک میزان احتمال (Probability) ارائه میدهد.
انواع مختلف مدلهای شبکه عصبی کانولوشن (CNN)
- LeNet: شبکه LeNet که توسط یان لکان (Yann LeCun) و همکارانش در اواخر دهه ۱۹۹۰ توسعه یافت، یکی از نخستین شبکه عصبی کانولوشن (CNN) موفق بود که برای تشخیص ارقام دستنویس طراحی شد. این مدل پایهای برای CNNهای مدرن به شمار میرود و در مجموعهداده MNIST، که شامل ۷۰,۰۰۰ تصویر از ارقام دستنویس ۰ تا ۹ است، به دقت بالایی دست یافت.
- AlexNet: شبکه AlexNet یک معماری CNN است که توسط الکس کرایژفسکی، ایلیا سوتسکیور و جفری هینتون در سال ۲۰۱۲ توسعه یافت. این شبکه نخستین CNN بود که در چالش تشخیص بصری مقیاس بزرگ ImageNet (ILSVRC)، یکی از رقابتهای مهم در زمینه تشخیص تصویر، به پیروزی رسید. این شبکه از چندین لایه کانولوشنی و ادغام (پولینگ) تشکیل شده است که پس از آنها لایههای کاملاً متصل قرار دارند. این معماری شامل پنج لایه کانولوشن، سه لایه پولینگ و سه لایه کاملاً متصل است.
- ResNet: شبکههای ResNet (شبکههای باقیمانده) برای وظایف تشخیص و پردازش تصویر طراحی شدهاند. این شبکهها به دلیل توانایی در آموزش شبکههای بسیار عمیق بدون دچار شدن به بیشبرازش (Overfitting) شناخته میشوند و به همین دلیل برای انجام وظایف پیچیده بسیار مؤثر هستند. این مدل با معرفی اتصالات میانبر (Skip connections) به شبکه اجازه میدهد توابع باقیمانده را یاد بگیرد و در نتیجه، آموزش معماریهای عمیق را آسانتر میکند.
- GoogleNet: شبکه GoogleNet که با نام InceptionNet نیز شناخته میشود، به دلیل دستیابی به دقت بالا در طبقهبندی تصاویر و در عین حال استفاده از پارامترها و منابع محاسباتی کمتر در مقایسه با سایر شبکههای پیشرفته (State-of-the-art)، شناخته شده است. جزء اصلی GoogleNet به شبکه اجازه میدهد ویژگیها را در مقیاسهای مختلف بهطور همزمان یاد بگیرد و عملکرد آن را بهبود دهد.
- VGG: شبکههای VGG توسط گروه هندسه بصری در دانشگاه آکسفورد توسعه یافتهاند. این مدل از فیلترهای کانولوشنی کوچک ۳ در ۳ استفاده میکند که در چندین لایه روی یکدیگر قرار گرفتهاند و ساختاری عمیق و یکنواخت ایجاد میکنند. نسخههای محبوبی مانند VGG-16 و VGG-19 در مجموعهداده ImageNet به عملکردی پیشرفته دست یافتند و اهمیت عمق در شبکه عصبی کانولوشن CNN را نشان دادند.
کاربردهای شبکه عصبی کانولوشن (CNN)
طبقهبندی تصویر: شبکههای عصبی کانولوشنی (CNN) از پیشرفتهترین مدلها برای طبقهبندی تصاویر هستند. از این شبکهها میتوان برای دستهبندی تصاویر در گروههای مختلف، مانند گربهها و سگها، استفاده کرد.
تشخیص شیء: از این شبکهها میتوان برای تشخیص اشیاء در تصاویر، مانند افراد، خودروها و ساختمانها، استفاده کرد. همچنین میتوانند موقعیت اشیاء را در تصاویر مشخص کنند؛ یعنی محل قرارگیری یک شیء را در تصویر شناسایی کنند.
قطعهبندی تصویر: از این شبکهها میتوان برای قطعهبندی تصاویر استفاده کرد؛ به این معنا که اشیاء مختلف موجود در یک تصویر را شناسایی و برچسبگذاری میکنند. این قابلیت در کاربردهایی مانند تصویربرداری پزشکی و رباتیک مفید است.
تحلیل ویدئو: از این شبکهها میتوان برای تحلیل ویدئوها، مانند ردیابی اشیاء یا تشخیص رویدادها در یک ویدئو، استفاده کرد. این قابلیت در کاربردهایی مانند نظارت ویدئویی و کنترل ترافیک مفید است.
مزایای شبکه عصبی کانولوشن (CNN)
دقت بالا: شبکه عصبی کانولوشن (CNN) میتوانند در وظایف مختلف تشخیص تصویر به دقت بالایی دست یابند.
کارایی: این شبکهها کارآمد هستند، بهویژه زمانی که روی پردازندههای گرافیکی (GPU) پیادهسازی شوند.
مقاومت: این شبکهها در برابر نویز و تغییرات در دادههای ورودی مقاوم هستند.
قابلیت انطباق: میتوان این شبکهها را با ایجاد تغییراتی در معماری، برای انجام وظایف مختلف تطبیق داد.
معایب شبکه عصبی کانولوشن (CNN)
پیچیدگی: این شبکهها میتوانند پیچیده باشند و آموزش آنها، بهویژه روی مجموعهدادههای بزرگ، دشوار است.
مصرف منابع بالا: این شبکهها برای آموزش و استقرار به منابع محاسباتی قابلتوجهی نیاز دارند.
الزامات داده: این شبکهها برای آموزش به مقادیر زیادی داده برچسبدار نیاز دارند.
تفسیرپذیری: تفسیر عملکرد این شبکهها میتواند دشوار باشد و درک پیشبینیهای آنها را چالشبرانگیز کند.
منابع: