
یادگیری ماشینی به یکی از نیروهای محرکه هوش مصنوعی مدرن تبدیل شده است و همه چیز را از موتورهای تشخیص تقلب و پیشنهاد گرفته تا تجزیه و تحلیل پیشبینیکننده و بینایی رایانهای، قدرتمند میکند. اما با وجود پذیرش سریع آن، برنامهنویسی سنتی همچنان پایه و اساس اکثر سیستمهای نرمافزاری است.
در این مقاله، ما توضیح خواهیم داد که این دو رویکرد چه تفاوتی با هم دارند، مدلهای یادگیری ماشین چگونه از دادهها یاد میگیرند و هر روش در کجا بهترین نتایج را ارائه میدهد.
الگوی برنامهنویسی سنتی در مقابل یادگیری ماشین (ML) چیست؟
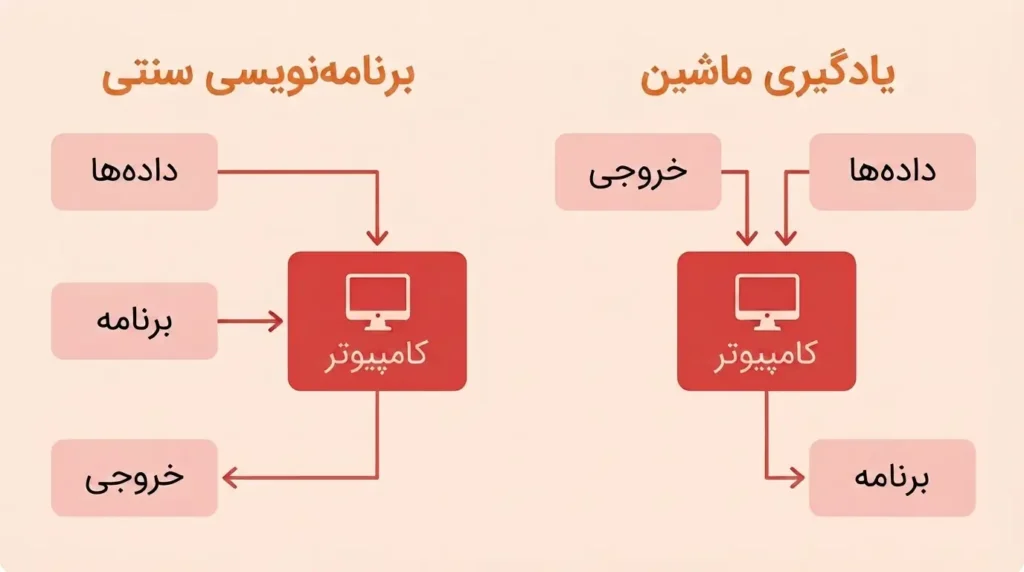
تفاوت اصلی بین برنامهنویسی سنتی و یادگیری ماشینی در نحوه حل مسئله توسط نرمافزار است. برنامهنویسی سنتی از قوانینی که صریحاً توسط توسعهدهندگان نوشته شده است پیروی میکند، در حالی که یادگیری ماشینی الگوها را از دادهها میآموزد تا پیشبینیها یا تصمیمگیریها را انجام دهد.
| پارامتر / ویژگی | برنامهنویسی سنتی (Traditional Programming) | یادگیری ماشین (Machine Learning) |
|---|---|---|
| تعریف منطق | قوانین بهصورت دستی توسط توسعهدهندگان تعریف میشوند. | مدلها الگوها و قوانین را مستقیماً از دادهها میآموزند. |
| رویکرد پیادهسازی | برای هر سناریو نیاز به کدنویسی و برنامهریزی صریح است. | بدون نیاز به کدنویسی صریح برای تکتک سناریوها، پیشبینی انجام میدهد. |
| کاربرد بهینه | مناسب برای وظایف قابل پیشبینی، قطعی و مبتنی بر قوانین مشخص. | مناسب برای مسائل پیچیده شامل الگوهای پنهان و مجموعهدادههای بزرگ. |
| نحوه تعیین خروجی | خروجی کاملاً وابسته به دستورالعملها و منطق از پیشتعیینشده است. | خروجی و دقت با آموزش مداوم و تحلیل دادههای جدید ارتقا مییابد. |
| نیاز به داده | برای عملکرد نیازی به حجم زیادی از داده ندارد. | برای رسیدن به دقت و کارایی بالا به دادههای آموزشی باکیفیت و حجیم نیاز دارد. |
برنامهنویسی سنتی شامل نوشتن دقیق مراحل مورد نیاز برای حل یک مسئله است. در مقابل، یادگیری ماشین (ML)، زیرمجموعهای از هوش مصنوعی (AI)، از نحوه یادگیری انسانها الهام گرفته شده است. به جای تعریف هر قانون، ما مثالهایی ارائه میدهیم و اجازه میدهیم مدل نحوه حل مسئله را به تنهایی تعیین کند.
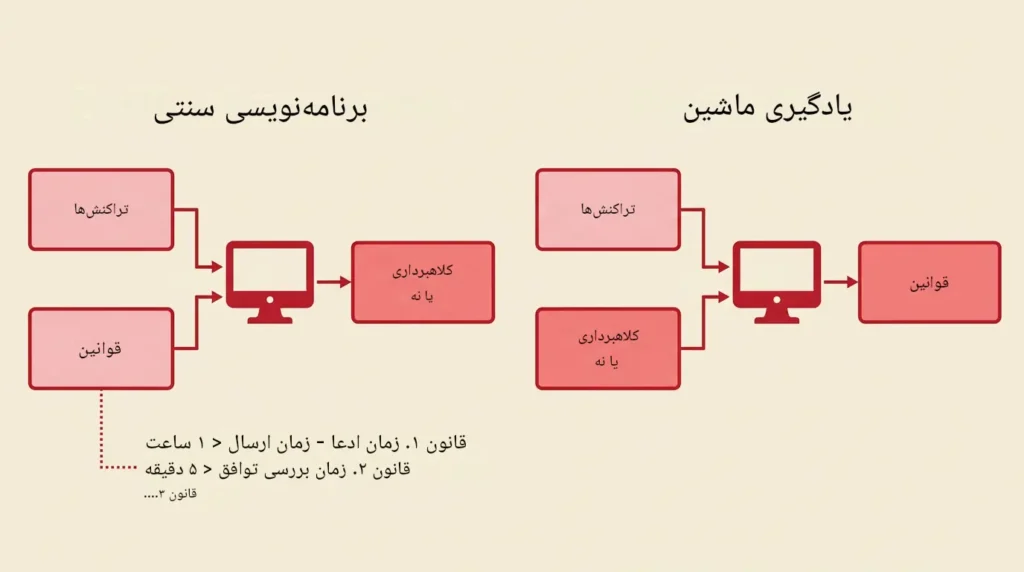
در ادامه یک مثال واقعی از تفاوت برنامهنویسی سنتی و یادگیری ماشینی ارائه شده است. یک شرکت بیمه فرضی را تصور کنید که در تلاش برای بهترین تجربه مشتری در محیط دیجیتال قرن بیست و یکم و همچنین حفظ داراییها و بازگشت سرمایه خود است. بنابراین، تشخیص خودکار ادعاهای جعلی بخشی از فرآیندهای تجاری آنها است.
در نتیجه، دو سناریوی احتمالی برای ورود فناوری وجود دارد:
برنامهنویسی سنتی (رویکرد مبتنی بر قانون). در این حالت، ما مجموعهای از قوانین را تعریف میکنیم که مشخص میکند آیا ادعا جعلی است یا واقعی، و سپس یک توسعهدهنده آنها را به کد تبدیل میکند. این روش زمانی عالی عمل میکند که چنین قوانینی وجود داشته باشند و ما از آنها مطلع باشیم.
متأسفانه، در زندگی واقعی همیشه اینطور نیست. ما همیشه دقیقاً نمیدانیم که یک برنامه باید از چه قوانینی پیروی کند. قانون نماینده بیمه که میگوید: «این مورد مشکوک به نظر میرسد: «ادعا را رد کن» ترجمهاش به کد دشوار است، اینطور نیست؟ چه برسد به مسئله طبقهبندی تصویر، که در آن تقریباً غیرممکن است قوانینی ارائه شود که به ما امکان تمایز بین گربهها و سگها را بدهد. و این دقیقاً جایی است که یادگیری ماشین وارد عمل میشود. ویژگی اصلی الگوریتمهای یادگیری ماشین، توانایی یافتن قوانین با استفاده از مثالهای موجود است.
حال ممکن است از خود بپرسید که الگوریتم واقعی پشت آموزش مدل یا «یادگیری» از مثالها چیست.
چرا شبکههای عصبی کلید یادگیری ماشینی هستند؟
شبکههای عصبی مصنوعی (ANN) یکی از فناوریهای اصلی پشت یادگیری ماشینی مدرن هستند. آنها مدلها را قادر میسازند تا الگوهای پیچیده را از دادهها بیاموزند و حل وظایفی مانند تشخیص تقلب، طبقهبندی تصویر و تشخیص گفتار را ممکن میسازند.
ما نحوهی کار این روش را با استفاده از یک شبکهی عصبی مصنوعی (ANN) به عنوان مثال توضیح خواهیم داد. ANNها مدلهای یادگیری ماشینی هستند که از شبکههای نورونهای بیولوژیکی موجود در مغز انسان الهام گرفته شدهاند.
شبکههای عصبی مصنوعی ابزارهای قدرتمند و مقیاسپذیری هستند که وظایف پیچیده یادگیری ماشینی، مانند تقویت سرویسهای تشخیص گفتار، طبقهبندی میلیاردها تصویر و خودکارسازی تشخیص تقلب را که تنها چند نمونه از آنها هستند، انجام میدهند.
شبکههای عصبی مصنوعی (ANNs) امروزه به شدت مورد استفاده قرار میگیرند، اگرچه اولین بار در سال ۱۹۴۳ معرفی شدند. از آن زمان، آنها شاهد چندین دوره افزایش دما و زمستان بودهاند. اما اکنون، با توجه به حجم عظیم دادههای موجود، افزایش چشمگیر قدرت محاسباتی و معماریهای بهبود یافته، به نظر میرسد که شبکههای عصبی مصنوعی احتمالاً تأثیر قابل توجهی بر زندگی ما خواهند داشت.
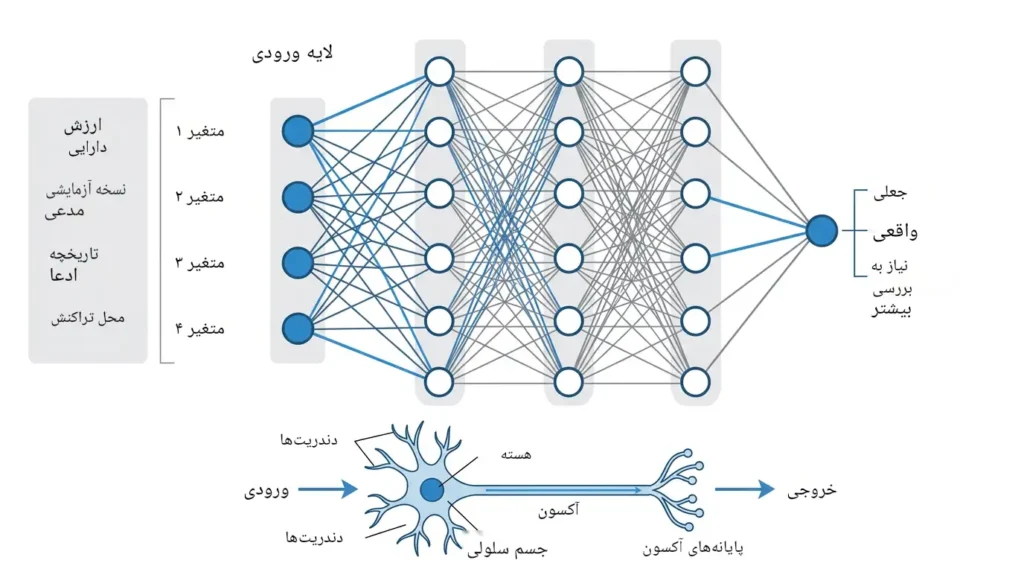
شبکههای عصبی از لایههایی تشکیل شدهاند که هر لایه از «نورونها» تشکیل شده است. جالبترین نکته این است که نورونها فقط اعداد اعشاری هستند. اولین لایه شبکه عصبی، ورودی نامیده میشود. در واقع، این دادههای شما هستند. در مورد تشخیص کلاهبرداری، اینها ویژگیهای یک ادعای بیمه هستند (ارزش دارایی ادعا شده، ویژگیهای نمایشی مدعی و غیره). بنابراین، در مورد یک مسئله تشخیص چهره، ورودی پیکسلهای خام در یک تصویر است.
آخرین لایه شبکه عصبی، لایه خروجی است. این در واقع یک پیشبینی شبکه بر اساس دادههایی است که شما وارد کردهاید. در مثال ما با تشخیص تقلب، این یک حکم است: جعلی یا واقعی است.
تمام لایهها به هم متصل هستند و هر اتصال با یک وزن مرتبط است. اینها نیز فقط اعداد اعشاری هستند. با دانستن مقادیر نورونهای لایه ورودی و وزنها، میتوانیم مقادیر تمام نورونهای دیگر در شبکه را محاسبه کنیم.
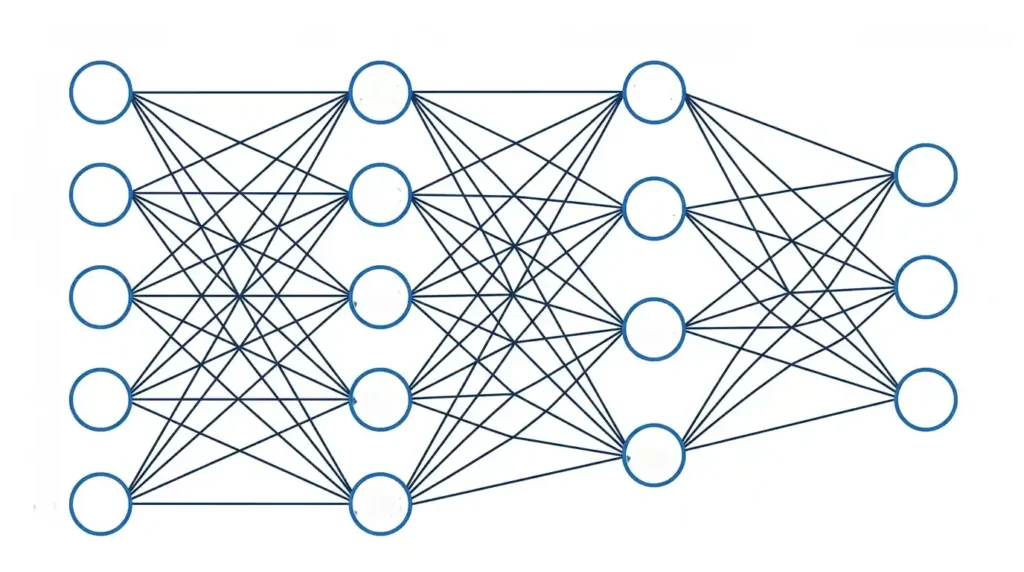
یعنی، مقادیر نورونهای لایه پنهان اول بر اساس مقادیر نورونهای لایه ورودی و وزنهای اتصال بین لایههای ورودی و پنهان اول محاسبه میشوند.
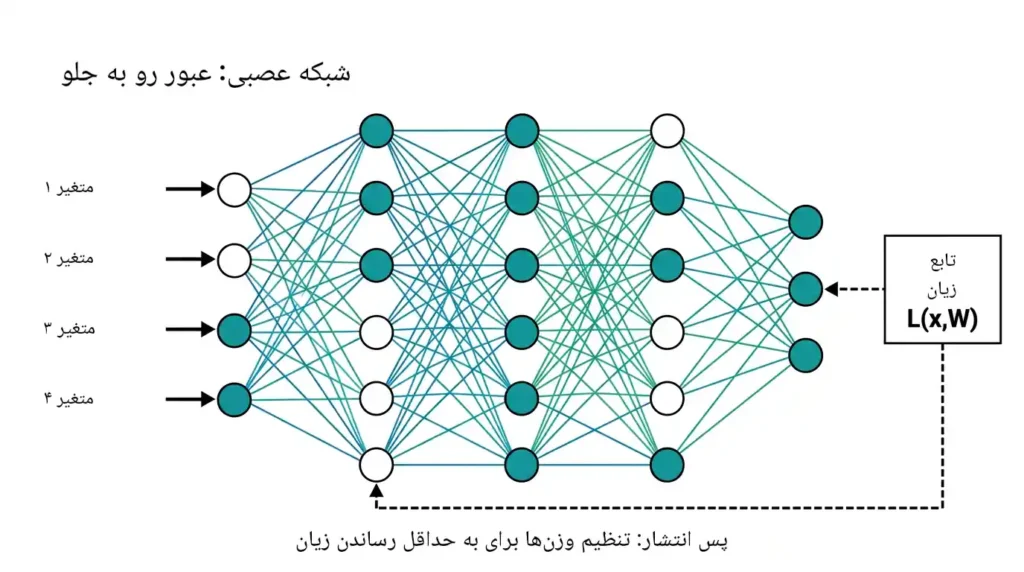
این فرآیند، انتشار رو به جلو نامیده میشود.
اما چگونه میتوانیم مقدار وزنها را بدانیم؟ اساساً، ما این کار را نمیکنیم. ما باید آنها را یاد بگیریم. و این در واقع زمانی است که یادگیری اتفاق میافتد. ما میتوانیم از الگوریتم آموزش پسانتشار برای این کار استفاده کنیم، که در سال ۱۹۸۶ اختراع شد، اما هنوز هم مورد استفاده قرار میگیرد.
برای هر نمونه آموزشی، الگوریتم پسانتشار ابتدا یک پیشبینی (حرکت رو به جلو) انجام میدهد و خطا را اندازهگیری میکند.
- این الگوریتم هر بار یک مینیبچ (مثلاً ۳۲ نمونه) را مدیریت میکند و کل مجموعه آموزشی را چندین بار مرور میکند. هر مرحله یک دوره (epoch) نامیده میشود.
- این الگوریتم از یک تابع زیان استفاده میکند که خروجی مطلوب و خروجی شبکه را مقایسه میکند و مقداری از خطا را برمیگرداند.
سپس به ترتیب معکوس از هر لایه عبور میکند و گرادیان تابع زیان را نسبت به تک تک پارامترهای مدل محاسبه میکند. به عبارت دیگر، سهم خطا را از هر اتصال اندازهگیری میکند (گذر معکوس). هنگامی که این گرادیانها را داشته باشیم، میدانیم که چگونه پارامترها را برای کاهش خطا تنظیم کنیم (این مرحله، مرحله نزول گرادیان نامیده میشود).
نکات کلیدی
با بررسی تمام موارد فوق، به چند نتیجه میرسیم:
- ما برای آموزش الگوریتم یادگیری ماشین به داده نیاز داریم. هر چه داده بیشتر، بهتر. طبق اثر معروف پیتر نورویگ با عنوان «اثربخشی نامعقول دادهها»: برای مسائل پیچیده، دادهها از خود الگوریتم مهمتر هستند.
- دادهها همه جا هستند و دائماً در دستگاههای پیشرفته افراد مانند تلفنهای همراه، دوربینها و میکروفونها و همچنین رسانههای اجتماعی و تاریخچه تراکنشها متولد میشوند.
- آموزش یک مدل یادگیری ماشین از نظر محاسباتی پرهزینه است.
در یک سیستم استاندارد یادگیری ماشین، دادهها معمولاً از یک یا چند کلاینت جمعآوری و در یک فضای ذخیرهسازی مرکزی ذخیره میشوند. یک دانشمند داده برای انجام یادگیری ماشین به دادههای موجود در فضای ذخیرهسازی دسترسی دارد.
یک دانشمند داده میخواهد با استفاده از یک الگوریتم یادگیری ماشین از پیش تعریفشده، یک مدل هوش مصنوعی را روی دادهها آموزش دهد. پس از آموزش مدل، آن را روی دادههای جدید یا دیده نشده ارزیابی میکند.
اگر عملکرد مدل رضایتبخش نباشد، یک دانشمند داده تغییراتی در الگوریتم ایجاد میکند، تنظیم فراپارامتر انجام میدهد یا دادههای بیشتری اضافه میکند. سپس مدل را دوباره آموزش داده و ارزیابی میکند. دانشمند داده این مراحل را تا زمانی که مدل به سطح قابل قبولی از کارایی برسد، ادامه میدهد.
هنگامی که دانشمند داده از مدل راضی باشد، آن را در دستگاههایی مستقر میکند که در آنجا از مدل برای استنتاج روی دادههای دستگاه استفاده خواهد شد.
محدودیتهای یادگیری ماشینی چیست؟
رویکردهای سنتی یادگیری ماشین اغلب به حجم زیادی از دادههای متمرکز و منابع محاسباتی قابل توجه نیاز دارند. این امر میتواند چالشهایی مربوط به حریم خصوصی، در دسترس بودن دادهها و هزینه مدلهای آموزشی در مقیاس بزرگ ایجاد کند.
برخی از محدودیتهای یادگیری ماشین استاندارد عبارتند از:
- این امر مستلزم آن است که دادهها روی یک دستگاه یا سرور واحد یا در یک مرکز داده متمرکز شوند.
- در نتیجه، با افشای اطلاعات حساس، حداقل برای توسعهدهنده و مالک متمرکز دستگاه، حریم خصوصی صاحبان دادهها را به خطر میاندازد.
- به دلیل نگرانیهای مربوط به حریم خصوصی، مالکان همیشه مایل به اشتراکگذاری دادههای حساس اما مفید خود نیستند، که این امر باعث کمبود دادهها میشود.
- علاوه بر این، آموزش الگوریتمهای بزرگ یادگیری ماشین روی میلیاردها داده در یک ماشین متمرکز یا خوشهای از ماشینها از نظر محاسباتی بسیار پرهزینه است.
یادگیری ماشین در مقابل برنامهنویسی سنتی: انتخاب رویکرد مناسب
برنامهنویسی سنتی و یادگیری ماشین انواع مختلفی از مسائل را حل میکنند. برنامهنویسی سنتی همچنان انتخاب مناسبی برای فرآیندهای قابل پیشبینی است که در آن توسعهدهندگان میتوانند قوانین واضح و نتایج مورد انتظار را تعریف کنند.
از سوی دیگر، یادگیری ماشینی، سیستمها را قادر میسازد تا الگوها را شناسایی کنند، از دادهها یاد بگیرند و پیشبینیهایی انجام دهند، زمانی که برنامهنویسی صریح برای هر سناریو عملی نیست.
در بسیاری از کاربردهای مدرن، موثرترین راهحلها، ترکیب برنامهنویسی سنتی با یادگیری ماشینی هستند. با درک نقاط قوت و محدودیتهای هر رویکرد، کسبوکارها میتوانند فناوری مناسب را برای اهداف خاص خود انتخاب کنند.
آیا به دنبال ایجاد یک راهکار مبتنی بر هوش مصنوعی هستید یا میخواهید بررسی کنید که چگونه یادگیری ماشین میتواند از کسب و کار شما پشتیبانی کند؟ متخصصان ما میتوانند به شما در طراحی و اجرای یک استراتژی متناسب با نیازهایتان کمک کنند.
دیدگاهتان را بنویسید