

- مدلهای ترکیبی گاوسی (GMM): برای ساخت خوشهها استفاده میشوند. GMM یک الگوریتم یادگیری ماشین بدون نظارت است که برای خوشهبندی دادههای بدون برچسب استفاده میشود. به طور خاص، GMM یک طبقهبندی نرم از نقاط داده انجام میدهد، بنابراین اطلاعاتی در مورد اینکه کدام نقطه داده به کدام خوشه تعلق دارد، علاوه بر احتمال تعلق نقطه داده داده شده به هر یک از خوشههای ممکن، ارائه میدهد.
- خودرمزگذارها (Autoencoders): رمزگذار خودکار یک شبکه عصبی با متغیرهای ورودی و خروجی یکسان است. وظیفه اصلی رمزگذارهای خودکار، یادگیری بازنمایی است: تنظیم یک رمزگذار و رمزگشا به عنوان شبکههای عصبی و یادگیری طرح رمزگذاری-رمزگشایی بهینه با استفاده از یک فرآیند بهینهسازی تکراری پس از هر تکرار، دادهها به خودرمزگذار داده میشود. سپس، ورودی تولید شده با دادههای اولیه مقایسه شده و شبکه عصبی برای محاسبه تابع خطا (زیان) بر اساس وزن شبکه عصبی استفاده میشود.
- هدف از استفاده از یک شبکه خودرمزگذار، ثبت همبستگی بین متغیرهای مختلف است. ابتدا، الگوریتم خودرمزگذار روی مجموعه دادهای که نقاط داده «عادی» را نشان میدهد، آموزش داده میشود. سپس، متغیرهای ورودی را فشرده و بازسازی میکند. مرحله بعدی کاهش ابعاد است که طی آن شبکه خودرمزگذار تعاملات بین متغیرهای مختلف و نقاط داده را یاد میگیرد و آنها را در مرحله خروجی به متغیرهای اصلی بازسازی میکند
- خودرمزگذار ترکیبی گوسی (VAEGMM): ترکیبی از VAE و GMM که عملکرد فوقالعادهای در برآورد چگالی و خوشهبندی ارائه میدهد.
- جنگل انزوا (Isolation Forest): الگوریتمی مبتنی بر درخت برای دادههای با ابعاد بالا که دادههای غیرعادی را با «ایزوله کردن» شناسایی میکند و نیازی به زمانپروفایلینگ ندارد.
- بردار پشتیبان تککلاسه (OneClassSVM): توسعهای از الگوریتم SVM که مرزی بین دادههای عادی و ناهنجار در غیاب دادههای تقلب ایجاد میکند.
- خوشهبندی فضایی مبتنی بر چگالی (DBSCAN): گروهبندی نقاط داده نزدیک به هم و شناسایی نقاط دورافتاده (Outliers) به عنوان ناهنجاری.
کشف کنید که چگونه تشخیص ناهنجاری مبتنی بر یادگیری ماشین (Machine Learning) به کسبوکارها کمک میکند تا از طریق کاربردهای دنیای واقعی و بینشهای تخصصی، تقلبها را بهصورت پیشگیرانه شناسایی کنند، خسارتها را کاهش دهند و امنیت عملیاتی را ارتقا بخشند.
کسبوکارها هر روز حجم عظیمی از دادهها را تولید میکنند که این امر شناسایی دستی فعالیتهای مشکوک، مشکلات عملیاتی و ریسکهای بالقوه را به طور فزایندهای دشوار میسازد. سیستمهای تشخیص ناهنجاری از الگوریتمهای یادگیری ماشین برای تحلیل این دادهها و کشف الگوهای غیرعادی که ممکن است نشاندهنده تقلب یا سایر رویدادهای حیاتی باشند، استفاده میکنند.
در این مقاله، یاد خواهید گرفت که تشخیص ناهنجاری چگونه کار میکند، انواع اصلی الگوریتمهای آن را بررسی میکنید و با مراحل کلیدی ساخت یک سیستم تشخیص ناهنجاری آشنا میشوید. همچنین به بررسی مطالعات موردی (Case Studies) واقعی خواهیم پرداخت که نشان میدهند چگونه یادگیری ماشین به کسبوکارها کمک کرده است تا تقلبها را زودتر شناسایی کنند، خسارتها را کاهش دهند و بهرهوری عملیاتی را بهبود ببخشند.
تشخیص ناهنجاری چگونه به کسبوکارها در پیشگیری از تقلب کمک میکند؟
تشخیص ناهنجاری به کسبوکارها کمک میکند تا با تحلیل حجم زیادی از دادهها، تشخیص الگوهای غیرعادی و شناسایی رفتارهای دور از انتظار (Outlier) که ممکن است نشاندهنده تقلب باشند، فعالیتهای تقلبآمیز را شناسایی کنند. با شناسایی زودهنگام فعالیتهای مشکوک، سیستمهای تشخیص ناهنجاری به سازمانها اجازه میدهند تا از خسارتهای بالقوه جلوگیری کرده و پیش از تشدید ریسکها، به آنها واکنش نشان دهند.
هر روز مقادیر عظیمی از دادهها تولید میشود. در سال ۲۰۲۵، حجم جهانی دادههای ایجاد و مصرفشده به حدود ۱۸۱ زابایت رسید که تقریباً معادل ۱۸۱ میلیارد ترابایت است. از آنجا که کسبوکارها به دیجیتالی کردن عملیات خود ادامه میدهند، باید حجم دادههای فزایندهتری را در سیستمها و پلتفرمهای مختلف پردازش و تحلیل کنند. در نتیجه، سازمانها باید رویکردهای پیشرفتهتری را برای مدیریت این دادهها، شناسایی ریسکها و همگام شدن با رقابت بازار اتخاذ کنند تحول دیجیتال در کنار مزایای خود، ریسکهایی نیز به همراه دارد؛ بهطوریکه مدیریت حجم انبوه دادهها در سرورهای شرکت با ابزارهای پیشرفته تشخیص ناهنجاری میتواند چالش بزرگی باشد. فعالیتهای تقلبآمیز این پتانسیل را دارند که کل سیستم را مختل کنند و این امر تنها زمانی قابل پیشگیری است که سیستمی برای تشخیص ناهنجاریها وجود داشته باشد. بنابراین، ضروری است که سیاستهای تشخیص تقلب در مرحله طراحی سیستم در نظر گرفته شوند تا پروفایل ریسک کلی کسبوکار تضعیف نشود.
خبر خوب این است که مکانیزمهای دقیق تشخیص ناهنجاری میتوانند برای محافظت از سازمانها در برابر خسارتها و آسیبهای ناشی از تقلب ساخته شوند. از آنجا که صدها روش برای انجام تقلب وجود دارد، جمعآوری اطلاعات درباره تمام ناهنجاریهای بالقوه در یک مجموعه داده از پیش کار بسیار دشواری است. با این حال، از آنجا که اکثریت اعمال کاربران عادی است، این اطلاعات قابل ثبت بوده و دادههای پرت (Outliers) در دادهها قابل شناسایی هستند.
مهمترین وظیفه سیستم تشخیص ناهنجاری، شناسایی فعالانهی فعالیتهای تقلبآمیز است تا بتوان بهسرعت به آنها واکنش نشان داد و از بروز خسارت برای شرکت جلوگیری کرد. در بخش بعدی این مقاله، نگاه عمیقتری به انواع الگوریتمهای تشخیص ناهنجاری خواهیم انداخت و بررسی میکنیم که هرکدام در چه مواردی کاربرد دارند.
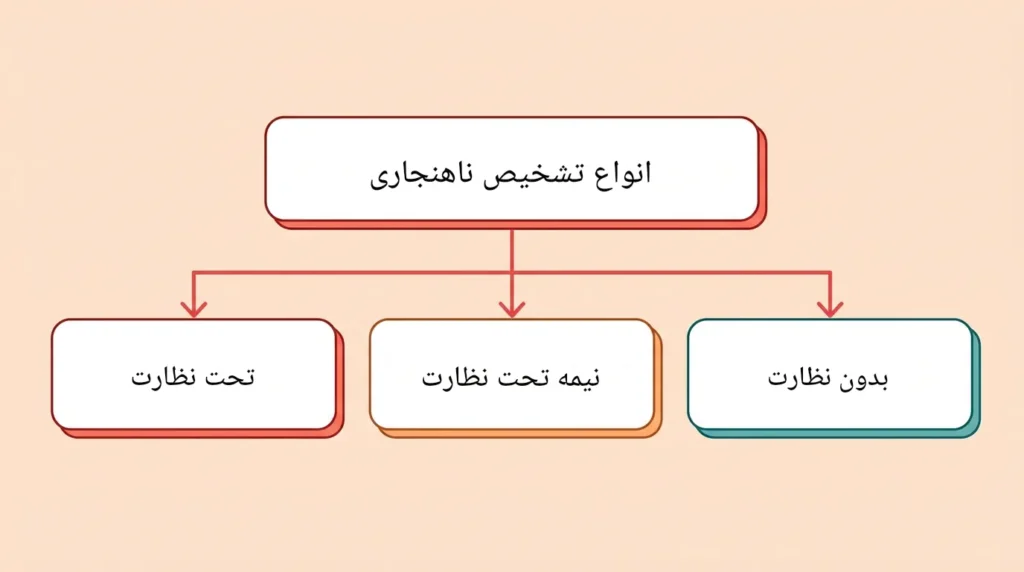
انواع تشخیص ناهنجاری
سه نوع الگوریتم تشخیص ناهنجاری وجود دارد: نظارتشده (Supervised)، نیمهنظارتشده (Semi-supervised) و نظارتنشده (Unsupervised). تمامی این الگوریتمها تکنیکهای یادگیری ماشینی هستند که در زمان نیاز به تشخیص تقلب در حجم عظیمی از دادهها (که احتمالاً برای انسان غیرممکن است) بسیار مؤثرند.
۱. تشخیص ناهنجاری نظارتشده (Supervised)
تکنیکهای تشخیص ناهنجاری نظارتشده شامل آموزش یک طبقهبند (Classifier) روی یک مجموعه داده برچسبگذاریشده است که در آن دادهها به دو دسته «غیرعادی» و «عادی» برچسبگذاری شدهاند. وقتی یک داده جدید ظاهر میشود، ابتدا باید طبقهبندی شود.
- مزیت: تولید نتایج بسیار دقیق.
- چالش: نیاز به جمعآوری مقادیر زیادی از نمونههای عادی و غیرعادی که به دلیل کمیاب بودن دادههای ناهنجار، کاری پیچیده و دشوار است.
۲. برخلاف روش نظارتشده، در تشخیص ناهنجاری نظارتنشده (Unsupervised)
هیچ برچسب یا طبقهبندی از دادهها برای آموزش وجود ندارد. اساساً، روش نظارتنشده یک داده را اگر به طور قابلتوجهی با بقیه دادهها متفاوت باشد، به عنوان ناهنجاری طبقهبندی میکند.
- مزیت: عدم نیاز متخصصان داده به برچسبگذاری دادهها.
- چالش: الگوریتم عملکرد خود را در طول زمان بهبود نمیدهد.
۳. تشخیص ناهنجاری نیمهنظارتشده (Semi-supervised)
از آنجا که برچسبگذاری دادهها معمولاً زمانبر و پرهزینه است، در بسیاری از موارد دادههای برچسبنشده زیاد و دادههای برچسبدار کمی وجود دارد. این روش ترکیبی از رویکردهای نظارتشده و نظارتنشده است؛ ابتدا به صورت نظارتنشده آموزش میبیند و سپس با تکنیکهای نظارتشده تنظیم (Tune) میشود.
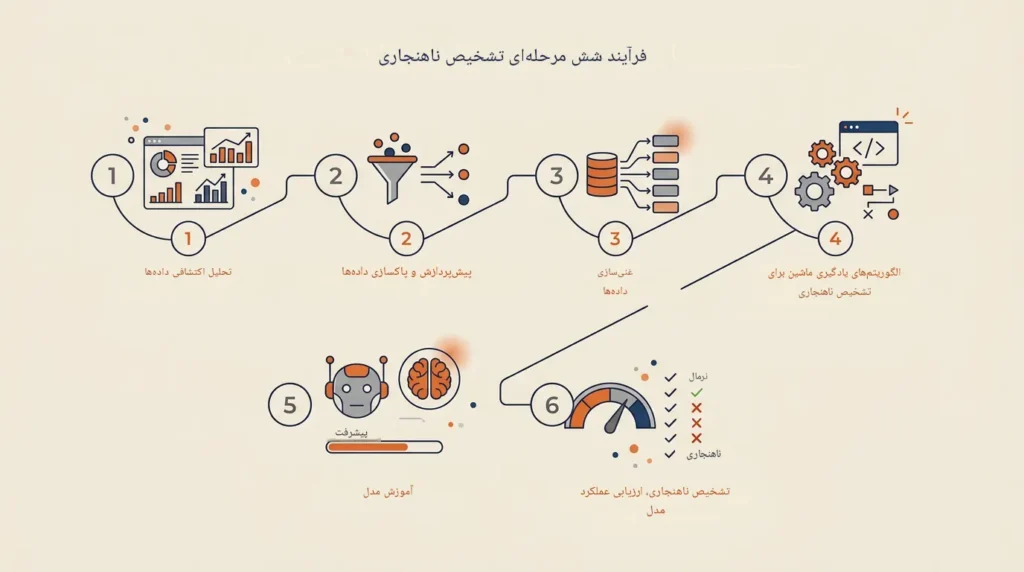
فرآیند تشخیص ناهنجاری
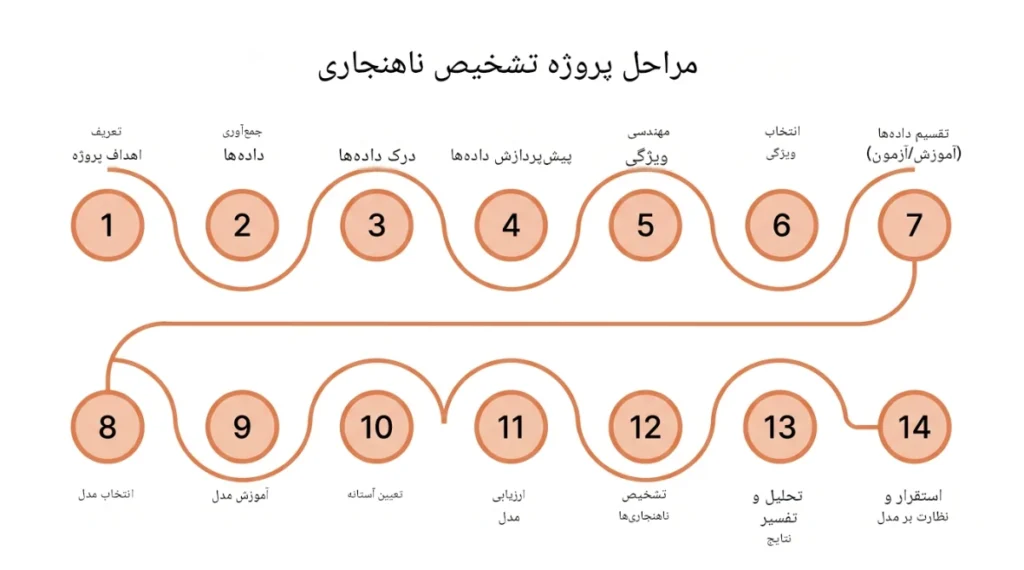
فرآیند تشخیص ناهنجاری شامل مراحل زیر است:
- تحلیل اکتشافی دادهها (EDA): تحقیق اولیه روی دادهها برای کشف الگوها و دادههای پرت و درک روابط میان آنها.
- پیشپردازش و پاکسازی دادهها: حذف ترکیبات غیرممکن، مقادیر خارج از محدوده و دادههای گمشده برای تضمین کیفیت دادهها.
- غنیسازی دادهها (Data Enrichment): تکمیل دادههای ناقص و الحاق اطلاعات مرتبط (مانند دادههای منابع شخص ثالث).
- انتخاب الگوریتمهای یادگیری ماشین: انتخاب مناسبترین الگوریتمها با توجه به پیچیدگی دادهها.
- آموزش مدل (Model Training): آموزش مدل بر اساس اهداف مشخصشده (با یا بدون برچسب).
- ارزیابی عملکرد مدل: بررسی دقت عملکرد مدل روی دادههای جدید با روشهایی مانند Holdout و K-fold Cross-Validation.
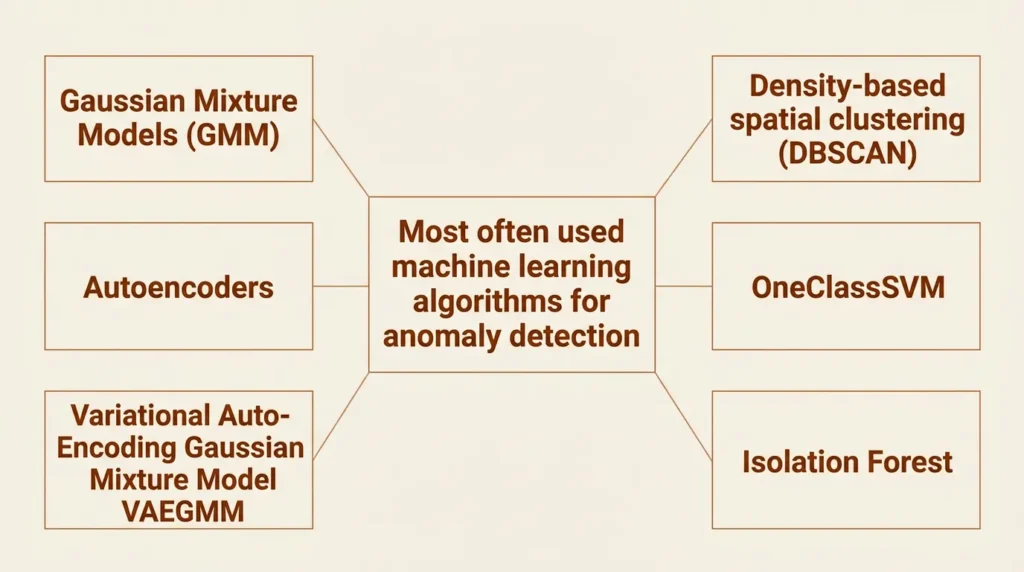
الگوریتمهای کلیدی در تشخیص ناهنجاری
مدلهای ترکیبی گاوسی (GMM)
مدلهای ترکیبی گاوسی (GMM) برای ساخت خوشهها استفاده میشوند. GMM یک الگوریتم یادگیری ماشین بدون نظارت است که برای خوشهبندی دادههای بدون برچسب به کار میرود. به طور خاص، GMM یک طبقهبندی نرم روی نقاط داده انجام میدهد؛ بدین ترتیب، علاوه بر مشخص کردن اینکه هر نقطه داده به کدام خوشه تعلق دارد، احتمالی را که آن نقطه داده ممکن است به هر یک از خوشههای احتمالی تعلق داشته باشد نیز ارائه میدهد.
اتوانکودرها (Autoencoders)
اتوانکودر یک شبکه عصبی است که متغیرهای ورودی و خروجی آن یکسان هستند. وظیفه اصلی اتوانکودرها، یادگیری بازنمایی (Representation Learning) است: تعیین یک انکودر (کدگذار) و دیکودر (کدگشا) به عنوان شبکههای عصبی، و یادگیری طرح بهینه کدگذاری و کدگشایی با استفاده از یک فرآیند بهینهسازی تکراری. پس از هر تکرار، دادهها به اتوانکودر تزریق میشوند. سپس، دادههای تولید شده با دادههای اولیه مقایسه شده و از شبکه عصبی برای محاسبه تابع خطا (Loss) بر اساس وزنهای شبکه عصبی استفاده میشود.
هدف از استفاده از شبکه اتوانکودر، ثبت همبستگی میان متغیرهای مختلف است. ابتدا، الگوریتم اتوانکودر روی مجموعهدادهای که نمایانگر نقاط داده «عادی» است، آموزش داده میشود. سپس، متغیرهای ورودی را فشرده و بازسازی میکند. فاز بعدی، کاهش ابعاد است که طی آن، شبکه اتوانکودر تعاملات میان متغیرها و نقاط داده مختلف را میآموزد و آنها را در مرحله خروجی به متغیرهای اصلی بازسازی میکند.
با انجام این فرآیند، میتوان خطای رو به رشدی را در بازسازی نقاط داده ورودی توسط شبکه اتوانکودر مشاهده کرد. با پایش این خطا، یک دانشمند داده میتواند نشانههایی از ناهنجاریها (Anomaly) را در مجموعهداده به دست آورد.
مدل ترکیبی گاوسی با اتوانکودر واریاسیونی (VAEGMM)
مدل تشخیص ناهنجاری «مدل ترکیبی گاوسی با اتوانکودر واریاسیونی» (VAEGMM) از یک اتوانکودر واریاسیونی (VAE) برای فراهم کردن توزیع احتمال برای هر ویژگی استفاده میکند. پیش از هر چیز، بیایید عمیقتر بررسی کنیم که یک اتوانکودر واریاسیونی چه کاری انجام میدهد.
اتوانکودرهای واریاسیونی به گونهای ساخته شدهاند که یک توزیع آماری (محدودهای از مقادیر ممکن) تولید کنند که بازنمایی دادهها را به شکلی پیوسته و دقیق تضمین کند. اتوانکودرهای واریاسیونی به جای ساخت یک انکودر معمولی که یک مقدار منفرد برای بازنمایی هر نقطه داده خروجی میدهد، یک توزیع احتمال برای هر نقطه داده نمایش میدهند. این روششناسی، بهترین گزینه برای تشخیص ناهنجاری است.
مدل VAEGMM از مزایای همزمانِ مدل ترکیبی گاوسی و اتوانکودرهای واریاسیونی بهره میبرد و برای بهبود عملکرد خوشهبندی بدون نظارت استفاده میشود.
بنابراین به زبان ساده: ابتدا اتوانکودر یک بازنمایی پنهان (Latent Representation) از دادهها تولید میکند؛ سپس، این بازنمایی برای انجام تخمین چگالی به GMM خورانده میشود.
الگوریتم VAEGMM به شکل قابلتوجهی از تکنیکهای متداول تشخیص ناهنجاری پیشی میگیرد.
جنگل ایزولهسازی (Isolation Forest)
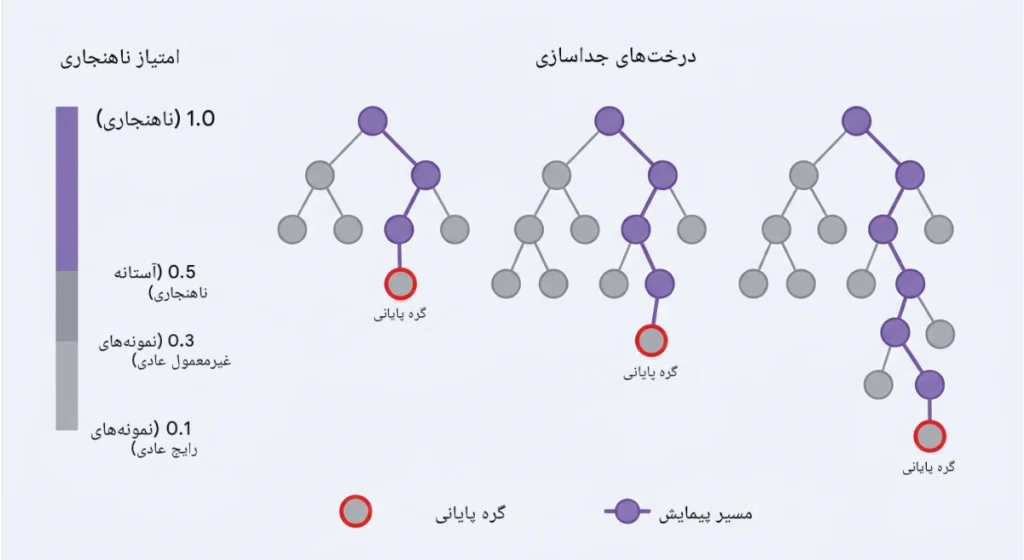
جنگل ایزولهسازی یک الگوریتم بدون نظارت و ناپارامتر مبتنی بر درخت است. جنگل ایزولهسازی شباهت بسیار زیادی به جنگلهای تصادفی (Random Forests) دارد و بر اساس مجموعهای (انسمبلی) از درختان تصمیم برای یک مجموعهداده مشخص ساخته میشود.
به طور خاص، این الگوریتم در انجام تشخیص ناهنجاری در مجموعهدادههای با ابعاد بالا بسیار مؤثر است. این الگوریتم با استفاده از روش ایزولهسازی، که در آن نقاط داده غیرعادی از مجموعهداده ایزوله میشوند، به شناسایی ناهنجاریها کمک میکند. الگوریتم جنگل ایزولهسازی به این دلیل بسیار کاربردی است که نیازی به طی کردن فرآیند زمانبر پروفایلسازی نقاط داده عادی، ساخت مدل یا خوشه ندارد.
جنگل ایزولهسازی به خوبی با مجموعهدادههایی که دارای تعداد قابلتوجهی ویژگی نامربوط هستند، و همچنین در موقعیتهایی که مجموعهداده آموزشی فاقد هرگونه ناهنجاری است، مقابله میکند.
One-Class SVM
آلوان کلاس اسویام (One-Class SVM) یکی دیگر از الگوریتمهای یادگیری ماشین بدون نظارت برای تشخیص ناهنجاری است. این الگوریتم، دادههای جدید را به عنوان دادههای مشابه یا متمایز از مجموعه دادههای آموزشی طبقهبندی میکند. One-Class SVM در واقع توسعهای از الگوریتم یادگیری SVM (ماشین بردار پشتیبان) است که امکان آموزش یک دستهبند را در صورت عدم وجود دادههای ناهنجار فراهم میکند. این الگوریتم خود را به گونهای آموزش میدهد که تعداد مشخصی از نقاط داده نرمال را به عنوان دادههای متعلق به ناهنجاریها در نظر بگیرد. این کار امکان تعیین یک مرز بین نقاط داده نرمال و ناهنجار را فراهم میکند.
در حالی که SVM استاندارد با استفاده از یک ابرصفحه (Hyperplane) با بیشترین حاشیه ممکن، دو کلاس را از یکدیگر جدا میکند، One-Class SVM از یک ابرکره (Hypersphere) برای دربرگرفتن تمامی نمونهها استفاده میکند. منظور از «حاشیه»، فضای بیرونی ابرکره است؛ بنابراین، منظور از «بیشترین حاشیه ممکن»، در واقع «کوچکترین ابرکره ممکن» است.
خوشهبندی فضایی مبتنی بر چگالی (DBSCAN)
تحلیل خوشهبندی برای گروهبندی دادهها در قالب خوشهها استفاده میشود. این روش یکی از محبوبترین تکنیکها در یادگیری ماشین بدون نظارت است. با این حال، تحلیل خوشهبندی یک وظیفه خودکار نیست، بلکه یک فرآیند تکرارپذیر از کشف دانش است که شامل تلاش و خطاست. در اینجا ما از یک مدل خوشهبندی چگالیمحور به نام «خوشهبندی فضایی مبتنی بر چگالی کاربردها همراه با نویز» (DBSCAN) استفاده کردیم.
این الگوریتم برای گروهبندی نقاط دادهای که به هم نزدیک هستند (دادههایی با همسایگان نزدیک زیاد) به کار میرود و نقاط دادهای را که به صورت تنها قرار گرفتهاند و نزدیکترین همسایگانشان فاصله زیادی دارند، به عنوان دادههای پرت (Outliers) رتبهبندی میکند. الگوریتم DBSCAN بهطور کاملاً مناسبی با پرونده مشتری ما سازگار بود، زیرا وظیفه ما شناسایی فعالیتهای تقلبآمیز توسط کارمندان شرکت بود که از کارتهای وفاداری خود به جای مشتریان برای جمعآوری پاداش استفاده میکردند (به مطالعه موردی در انتهای این مقاله مراجعه کنید). این روش یکی از رایجترین الگوریتمهای خوشهبندی است و به ویژه برای خوشهبندی طیفی و یافتن نقاط داده متصل روی گراف دسترسیپذیری نامتقارن، بسیار کارآمد میباشد.
آموزش مدل
هنگامی که الگوریتمهای تشخیص ناهنجاری انتخاب شدند، مدل تشخیص ناهنجاری به پیشبینی ناهنجاریهای جدید کمک میکند. مدل تشخیص ناهنجاری برای کار کردن، ابتدا نیاز به آموزش دارد. در رویکرد تشخیص ناهنجاری با نظارت (Supervised)، مدل با پاسخهای درستی که به آنها صفات هدف (Target Attributes) گفته میشود، آموزش میبیند. الگوریتم تشخیص ناهنجاری الگوهایی را پیدا میکند که دادههای ورودی را به صفات هدف مرتبط میسازند و سپس الگوریتمی را ارائه میدهد که این الگوها را به تصویر میکشد. در تنظیمات تشخیص ناهنجاری بدون نظارت (Unsupervised)، هیچ متغیر هدفی وجود ندارد.
در مطالعه موردی که در ادامه این مقاله شرح داده خواهد شد، وظیفه ما شناسایی کارتهای تقلبی و مکان کلاهبرداران بود. ما کار را با تحلیل خود دادهها (بدون برچسب) آغاز کردیم و سپس برای تنظیم دقیق الگوریتم، اطلاعاتی درباره مکان کلاهبرداران به خوشههای یادگرفتهشده اضافه نمودیم. استفاده از تکنیکهای تشخیص ناهنجاری با نظارت کاری نسبتاً زمانبر بود، زیرا هر مورد تقلب باید از طریق فایلهای ویدئویی تأیید میشد. بنابراین، تیم علم داده شرکت های هوش مصنوعی از الگوریتمهای تشخیص ناهنجاری بدون نظارت و نیمهنظارتی استفاده کرد، چرا که آنها مناسبترین گزینهها برای مورد استفاده (Use Case) این مشتری بودند.
۶. ارزیابی عملکرد مدل تشخیص ناهنجاری
پس از آموزش مدل تشخیص ناهنجاری، نتایج تولیدشده توسط آن باید ارزیابی شوند تا دقت عملکرد مدل برای آینده بر روی دادههای جدید و دیدهنشده تعیین گردد. دو رویکرد برای ارزیابی عملکرد مدل تشخیص ناهنجاری وجود دارد:
هولدآوت (Holdout)
رویکرد هولدآوت به دلیل سرعت، انعطافپذیری و سادگی، اغلب برای ارزیابی عملکرد مدل تشخیص ناهنجاری استفاده میشود. هدف تکنیک ارزیابی هولدآوت این است که مدل را با دادههای متفاوتی نسبت به دادههایی که با آنها آموزش دیده است، امتحان کند. این تکنیک برآورد منصفانهای از کیفیت مدل به دست میدهد. برای پیروی از رویکرد هولدآوت، مجموعه داده به سه زیرمجموعه تقسیم میشود:
- مجموعه آموزشی (Training Set): که برای ساخت پیشبینیها استفاده میشود.
- مجموعه اعتبارسنجی (Validation Set): که برای ارزیابی عملکرد مدل در مرحله آموزش استفاده میشود. مجموعه اعتبارسنجی برای تنظیم دقیق پارامترهای مدل و در نتیجه انتخاب بهترین مدلِ در حال اجرا به کار میرود.
- مجموعه آزمون (Test Set) یا مجموعه داده دیدهنشده: که برای ارزیابی عملکرد آتی مدل استفاده میشود. اگر مدل تمام نویزهای مجموعه آموزشی را حفظ کرده باشد و بیش از حد با آن انطباق پیدا کرده باشد، ممکن است دچار بیشبرازش (Overfitting) شود. بیشبرازش مفهومی در یادگیری ماشین است که در آن مدل نمیتواند به خوبی به دادههای جدید عمومیت ببخشد و عملکرد مدل مطابق انتظار نخواهد بود.
اعتبارسنجی متقابل کی-فولد (K-fold Cross-validation)
تکنیک ارزیابی اعتبارسنجی متقابل برای سنجش عملکرد مدل روی یک نمونه داده مستقل استفاده میشود. این تکنیک اغلب برای ارزیابی عملکرد مدل یادگیری ماشین روی دادههای دیدهنشده و برآورد میزان توانایی آن در پیشبینی دادههای جدید به کار می رود.
همیشه داشتن یک مجموعه داده بزرگتر برای آموزش مدل تشخیص ناهنجاری بهتر است. هنگامی که حجم یک مجموعه داده را کاهش میدهیم، خطر از دست دادن الگوهای ارزشمند وجود دارد. اعتبارسنجی متقابل K-fold روش رایج و مسلط است، زیرا درک آن ساده است و ارزیابی کمسوگیرانهتری (Less Biased) درباره میزان عملکرد مدل ارائه میدهد؛ به ویژه اگر با روشهای دیگر مانند تقسیم معمولی آموزش و آزمون (Train & Test Split) مقایسه شود.
فرآیند استاندارد اعتبارسنجی متقابل K-fold به شرح زیر است:
- تصادفیسازی مجموعه داده
- تقسیم مجموعه داده به $K$ گروه
- برای هر گروه:
- یک مجموعه داده هولدآوت و آزمون انتخاب میشود.
- گروههای باقیمانده یک مجموعه داده آموزشی را تشکیل میدهند.
- مدل روی مجموعه آموزشی فیت (Fitted) شده و روی مجموعه آزمون ارزیابی میشود.
- امتیاز ارزیابی ذخیره میشود.
- عملکرد مدل با استفاده از نمونهای از امتیازهای ارزیابی مدل بررسی میشود.
در بخشهای بعدی، دو مورد استفاده از تشخیص ناهنجاری را که تیمهای Avenga روی آنها کار کردهاند، معرفی خواهیم کرد.
مطالعه موردی ۱: چگونه یک سیستم تشخیص ناهنجاری توسعه دهیم که زمان حل خسارت را ۳۰ درصد کاهش میدهد؟
تیم علم داده شرکت های هوش مصنوعی یک سیستم جامع تشخیص ناهنجاری برای پلتفرم بیمه در لحظه پیشرو در جهان، یعنی Trōv، توسعه داد. این راهکار پیش از پرداخت خسارتهای بیمه، کلاهبرداران (مشتریان مشکوک) را شناسایی میکند و به شرکت کمک میکند تا از خسارتها و زیانهای ناشی از تقلب جلوگیری کند.
در طی قدم اول، تیم از تکنیکهای یادگیری ماشین بدون نظارت برای شناسایی گروههای مشکوک کاربران قبل از جمعآوری دادههای برچسبگذاریشده استفاده کرد.
در مرحله بعد، تیم به مهندسی ویژگی (Feature Engineering که در آن ویژگی نشانهای از تقلب است) پرداخت. ویژگیها شامل مواردی مانند فرکانس ادعای خسارت ثبتشده، ادعاهای رد شده و لغو شده، مبلغ خسارت و غیره بودند.
پس از آن، از تکنیکهای یادگیری ماشین با نظارت به همراه شبکههای عصبی برای یادگیری الگوهای مشکوک از نمونهها و تشخیص آنها در موارد جدید بر اساس مجموعه داده برچسبگذاریشده استفاده شد.
راهکار تشخیص ناهنجاری که توسعه داد به روش زیر کار میکند:
- مشتری یک خسارت ثبت میکند.
- مدل یادگیری ماشین ویژگیهایی (سیگنالهایی) را تولید میکند که ممکن است نشاندهنده تقلب باشند. چنین سیگنالهایی شامل موارد زیر هستند (اما به آنها محدود نمیشوند):
- سیگنالهای هویت: معیارهای تهدید، امتیاز کارت اعتباری، بررسیهای شناختی، ریسک ایمیل/موبایل، اخطارهای تحریم و فوتشده، تعداد دستگاههایی که مشتری روی آنها دیده شده است، نرخ تقلب IP مشتری و غیره.
- سیگنالهای سنتی: تعداد پوششهایی که در هفته اول خود ایجاد کردهاند، تعداد تراکنشهای ناموفق، سطوح مازاد (Excess Levels).
- سیگنالهای روش پرداخت: میزان شباهت بین نام مشتری و نام صورتحساب.
- سیگنالهای رفتاری: زمان صرف شده در صفحه، یا مدت زمان بین قیمتگذاری و خرید یک بیمهنامه (مانند اینکه آیا یک کلاهبردار از یک اسکریپت برای اسکرپ کردن یک صفحه وب استفاده میکند یا فعالیت مرور عادی دارد).
- مدل تشخیص ناهنجاری امتیازهایی را برای هر سیگنال (ویژگی) پیشبینی میکند و به هر ادعا یک امتیاز ریسک در مقیاس ۰ تا ۱ میدهد.
- مدل تشخیص ناهنجاری آستانههایی را برای چه درصدی از ادعاها باید پذیرفته، رد یا به صورت دستی بررسی شوند، تعیین میکند.
مزایای این راهکار به شرح زیر بود:
- کوتاه کردن زمان حل خسارت تا ۳۰ درصد، به لطف سیستم تشخیص تقلب.
- کاهش نسبت زیان (Loss Ratio) با تشخیص رفتارهای مشکوک پیش از اینکه آسیبی وارد کنند؛ در صنعت بیمه، نسبت زیان به معنای نسبت زیانها به حق بیمههای کسبشده است.
- دستیابی به بهرهوری عملیاتی بهتر به دلیل غربالگری خودکار.
- بهینهسازی هزینهها به دلیل حداقل زمان بررسی و پردازش تقلب.
- تسریع پرداختها در تراکنشها/ادعاهای واقعی.
- بهبود تجربه مشتری.
مطالعه موردی ۲: چگونه یک سیستم تشخیص ناهنجاری توسعه دهیم که ۹۴ درصد از تقلبها را شناسایی میکند؟
تیم شرکت های هوش مصنوعی یک مدل تشخیص ناهنجاری برای مشتریای توسعه داد که چندین صد شعبه در سراسر کشور خود دارد. این شرکت کارتهای برنامه وفاداری را پیادهسازی کرده بود که به مشتریان شرکت اجازه میداد هنگام خرید کالا از مجموعهای از فروشگاهها، امتیاز جمعآوری کنند.
این شرکت با برخی موارد تقلب در برنامه وفاداری مواجه شد که مشتری را در ایجاد یک پیوند پایدار و سودآور با مشتریان محدود کرده و حفظ مشتری را تهدید میکرد.
هدف پروژه این بود که بررسی شود افراد چگونه از کارتهای وفاداری استفاده میکنند تا الگوهای رفتار کلاهبردار زودتر کشف شود، و همچنین انواع کلاهبرداران بر اساس ویژگیهای احتمالی تقلب (تعداد تراکنشها، الگوهای زمانی رفتاری، الگوهای جمعآوری امتیاز و غیره) شناسایی گردند.
پروژه تشخیص ناهنجاری شامل مراحل زیر بود:
- تحلیل اکتشافی مجموعه داده (Exploratory dataset analysis)
- پیشپردازش مجموعه داده
- شناسایی فعالیتهای ناهنجار
- ساخت فرضیه در مورد انواع کلاهبرداران
- طبقهبندی کلاهبرداران
- تشخیص رفتار عادی
- تشخیص رفتار کلاهبردار
- خوشهبندی و بخشبندی کلاهبرداران
- شناسایی شعب با ریسک بالا
- تأیید تقلب
- رتبهبندی تقلب
- الگوریتم بازرسی کارت پاداش
تیم علم داده شرکت های هوش مصن.ومجموعه دادههای شرکت را که حاوی اطلاعات چند صد هزار کاربر بود، تحلیل کرد و به شش نوع تقلب احتمالی دست یافت. این موارد بر اساس تعداد تراکنشها، الگوهای زمانی رفتاری، رفتار خرج کردن و جمعآوری امتیاز و غیره دستهبندی شده بودند.
با استفاده از الگوریتمهای تشخیص ناهنجاری، کاربران شرکت به دو دسته کلاهبردار (Fraudster) و غیرکلاهبردار تفکیک شدند. ویژگیهای کلیدی و توصیفی برای رفتارهای کلاهبردارانه ساخته شد. طبقهبندی رفتارهای غیرعادی کاربران کمک کرد تا کلاهبرداران به سرعت در یکی از شش نوع تقلب جای گیرند.
این تیم بینشهای ارزشمندی درباره انواع تقلبها با استفاده از کارتهای وفاداری کشف کرد. برای مثال، کلاهبرداران خیلی بیشتر از حد معمول موجودی کارت خود را بررسی میکنند؛ کاری که افراد عادی انجام نمیدهند. علاوه بر این، بسیاری از خریدهای تقلبی معمولاً در طول شب انجام میشوند و این تراکنشها بازتابدهنده مبلغ زیادی پول در مدت زمانی کوتاه هستند.
برای شناسایی کلاهبرداران، این تیم یک مدل تشخیص ناهنجاری ساخت که از VAEGMM (مدل ترکیبی گاوسی خودکدگذار واریاسیون) استفاده میکرد. رویکردهای دیگر مبتنی بر تکنیکهای یادگیری ماشین بدون نظارت مانند Isolation Forest، OneClassSVM و خوشهبندی (DBSCAN) در طول مرحله انتخاب مدل آزمایش شدند. رویکردهای اخیر در مقایسه با VAEGMM عملکرد خوبی نداشتند و به همین دلیل انتخاب نشدند.
این سیستم به شناسایی تمامی کارتهای پاداش کلاهبرداران کمک کرد، زیرا برخی از کلاهبرداران از کارتهای متفاوتی برای انواع تراکنشها استفاده میکردند. در نتیجه، مشتری چندین گزارش دریافت کرد:
- گزارشی از مکانهایی که تقلبها در آنها رخ میداد.
- گزارشی از کارتهای پاداشی که برای تراکنشهای تقلبی استفاده شده بودند.
- گزارشی از سایر کارتهایی که کلاهبرداران برای جمعآوری پاداشها استفاده میکردند.
اثبات مفهومی (POC) تشخیص ناهنجاری، تقلب را با دقت بالا شناسایی کرد که نتیجه آن افزایش رضایت کاربران، ارتقای امنیت و بهبود جریانهای کاری بود.
چالشهای تشخیص ناهنجاری (Challenges of anomaly detection)
تشخیص فعالیتهای ناهنجار مانند تقلب، نفوذ به شبکه و سایر فعالیتهای مشکوک ممکن است دشوار باشد، زیرا الگوهای غیرعادی کمیاب هستند و معمولاً به وفور در مجموعه داده ظاهر نمیشوند. علاوه بر این، آنها پراکنده و از بسیاری جهات ناهمسان هستند، که این امر مانع از کارایی تکنیکهای معمولی آمادهسازی داده میشود.
علاوه بر کمیاب بودن، نقاط داده غیرعادی به طور مساوی نیز نمایش داده نمیشوند. برای مثال، پس از اعمال یک تکنیک طبقهبندی روی مجموعه داده، یک دانشمند داده ممکن است مدلی با نتایج ۸۵ درصد دقت به دست آورد. با این حال، پس از بررسی بیشتر، مشخص میشود که ۸۵ درصد از نقاط داده تنها به یک کلاس تعلق دارند. این یک نمونه بینقص از چیزی است که دادههای نامتوازن (Imbalanced Data) نامیده میشود و نشان میدهد چگونه میتواند نتایج نادرستی تولید کند.
نفرین ابعاد (Curse of dimensionality)
در مجموعههای داده بزرگ که شامل تعداد زیادی از صفات و ویژگیها هستند، حجم دادههایی که باید عمومیتدهی (Generalize) شوند بسیار زیاد است. این امر منجر به پراکندگی دادهها میشود؛ جایی که نقاط داده پراکندهتر و منزویتر هستند. پراکندگی دادهها از طریق چندین متغیر نامربوط که ناهنجاریهای واقعی را میپوشانند، سطوح نویز بالایی ایجاد میکند. این چالش «نفرین ابعاد» یا در برخی منابع چندوجهی (Multimodality) نامیده میشود که مانعی برای تکنیکهای تشخیص ناهنجاری ایجاد میکند.
برچسبگذاری دشوار و طاقتفرسا (Cumbersome labeling)
هنگام تحلیل دادهها برای یافتن ناهنجاریها، به دست آوردن دادههای با برچسب دقیق که تمام انواع رفتارهای ناهنجار را نشان دهند دشوار است. به همین دلیل، برچسبگذاری اغلب به صورت دستی انجام میشود که به دلیل نیاز به دانش تخصصی بالا، پرهزینه است. این فرآیند همچنین به دلیل زمانبر بودن، بسیار خستهکننده و ملالآور است.
دیدگاهتان را بنویسید