
واژهنامه · فنی
توکن(Token) چیست و چه کاربردی دارد؟
تعریف به زبان ساده
یک توکن کوچکترین واحد متنی است که یک سیستم هوش مصنوعی برای تفسیر و تولید زبان از آن استفاده میکند و میتواند نمایانگر یک کلمه کامل، بخشی از یک کلمه، یک کاراکتر یا حتی یک عبارت کوتاه باشد. قبل از پردازش، متن توکنیزه میشود و به بخشهای معنادار تقسیم میشود تا مدلها بتوانند الگوها را تشخیص دهند و کلمات ناآشنا را با ترکیب قطعات شناخته شده درک کنند.
توکنها با کلمات و کاراکترها متفاوت هستند زیرا برای کارایی محاسباتی بهینه شدهاند و به مدلها اجازه میدهند اندازه واژگان را مدیریت کنند، الگوها را در زبانهای مختلف تشخیص دهند و در محدوده حافظه عمل کنند. آنها همچنین محدودیتهای عملی مانند ظرقیت ورودی(context windows) را تعریف میکنند که بر میزان اطلاعاتی که یک مدل میتواند به خاطر بسپارد و هزینه، زمان پاسخ و کیفیت خروجی تأثیر میگذارند. برای توسعهدهندگان و معماران داده، درک توکنها برای طراحی اعلانهای کارآمد، ساختاردهی دادهها برای بازیابی و پیشبینی عملکرد، تأخیر و نیازهای زیرساختی در برنامههای هوش مصنوعی دنیای واقعی ضروری است.
نکته مهم
توکن در هوش مصنوعی(واحد متنی) با توکنهای کریپتوکارنسی و بلاکچین متفاوت است.
توکن شامل چه چیزهایی میشود؟
قبل از اینکه یک مدل هوش مصنوعی هرگونه ورودی را پردازش کند، متن را به این واحدها تقسیم میکند و تجزیه و تحلیل و تولید پاسخها را آسانتر میکند. با این حال، توکنها همیشه دقیقاً در مرز کلمات برش نمیخورند؛ آنها میتوانند شامل فضاهای انتهایی یا زیرکلمات باشند. به عنوان مثال، “unbreakable” ممکن است به “un-” و “breakable” تقسیم شود. این انعطافپذیری به مدلهای هوش مصنوعی کمک میکند تا ساختارهای مختلف زبانی را مدیریت کنند. درک طول توکن میتواند دشوار باشد، اما چند قانون کلی مفید وجود دارد:
به طور کلی:
- ۱ توکن ≈ ۴ کاراکتر انگلیسی
- ۱ توکن ≈ ¾ کلمه
- ۱۰۰ توکن ≈ ۷۵ کلمه
توکنسازی همچنین وابسته به زبان است، به این معنی که توکنها در انگلیسی ممکن است با توکنهای سایر زبانها متفاوت باشند. برای مثال، «Cómo estás» (به اسپانیایی به معنی «حالت چطور است») به ۵ توکن ترجمه میشود، حتی اگر فقط ۱۰ کاراکتر داشته باشد. این تنوع میتواند بر هزینه و پیچیدگی پردازش متن در زبانهای مختلف تأثیر بگذارد. مدلهای OpenAI، از جمله GPT-3.5 و GPT-4، از توکنسازهای تخصصی برای مدیریت این تفاوتها استفاده میکنند و توکنسازی را به فرآیندی انعطافپذیر و کارآمد تبدیل میکنند.
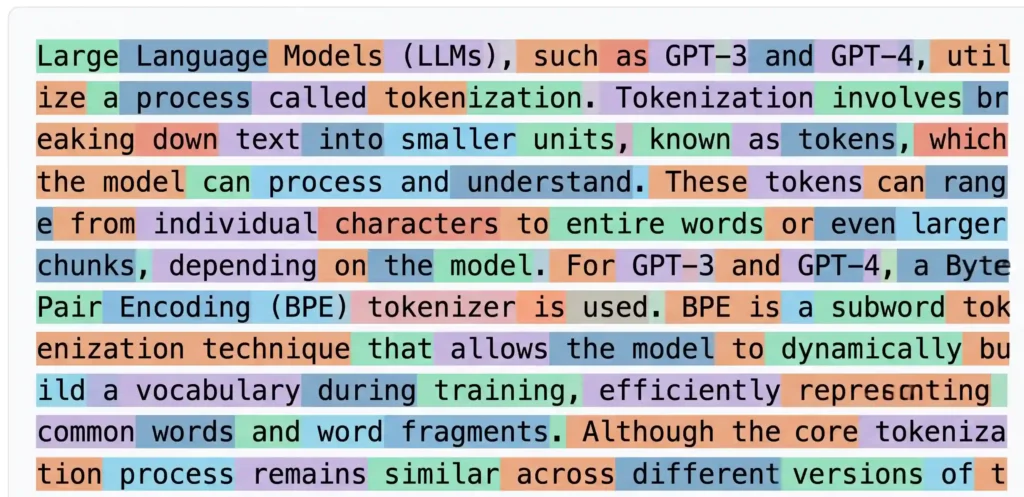
فرآیند توکنسازی(Tokenization) چیست؟
توکنسازی فرآیند ترجمهای است که قبل از اینکه هوش مصنوعی متن شما را ببیند، اتفاق میافتد. این فرآیند به عنوان پلی بین زبان انسان و منطق ماشین عمل میکند. وقتی جملهای را به یک مدل هوش مصنوعی میدهید، یک توکنساز آن متن خام را به قطعات کوچکتر تقسیم میکند. این توکن رشته کاراکترها را تجزیه و تحلیل میکند و کارآمدترین راه برای گروهبندی آنها بر اساس واژگان از پیش تعریف شده را پیدا میکند.
برای مثال، کلمه «tokenization» را در نظر بگیرید.
- یک انسان یک کلمه را میبیند.
- یک tokenizer ممکن است دو token ببیند: «token» و «ization».
این اتفاق میافتد زیرا مدل یاد گرفته است که «token» یک مفهوم رایج و «ization» یک پسوند رایج است. با تقسیم آنها، مدل میتواند معنی ریشه و اصلاح را بدون نیاز به حفظ کردن «tokenization» به عنوان یک ورودی جداگانه و منحصر به فرد در فرهنگ لغت خود بفهمد. این به هوش مصنوعی اجازه میدهد تا کلماتی را که مرتباً ندیده است با شکستن آنها به بخشهای آشنا درک کند.
رویکردهای مختلفی برای توکنسازی وجود دارد، اما اکثر LLM های مدرن از توکنسازی زیرکلمات استفاده میکنند. این روش تعادلی بین تحلیل مبتنی بر کاراکتر (که بیش از حد جزئی است) و تحلیل مبتنی بر کلمه (که به واژگان عظیم و غیرقابل مدیریت نیاز دارد) برقرار میکند.
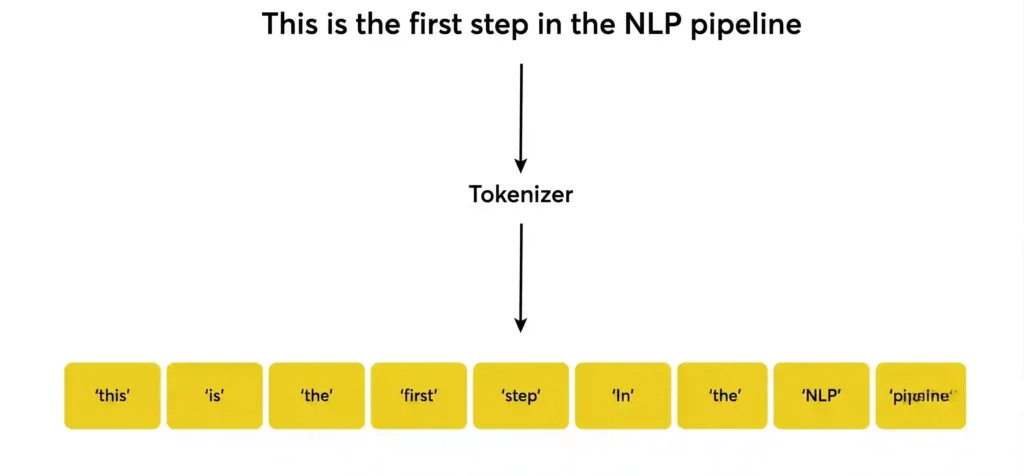
تاریخچه توکن سازی
- پردازش زبان طبیعی اولیه و پردازش متن (دهههای ۱۹۶۰ تا ۱۹۸۰): توکنسازی به عنوان روشی ساده برای تقسیمبندی متن برای جستجو و نمایهسازی در سیستمهای بازیابی اطلاعات اولیه آغاز شد. در این مرحله، توکنسازی معمولاً شامل تقسیم متن بر اساس فاصله و علائم نگارشی و ایجاد توکنهای سطح کلمه برای تحلیل اولیه زبان بود.
- مدلهای آماری پردازش زبان طبیعی (دهه ۱۹۹۰ تا ۲۰۰۰): با رواج روشهای آماری، توکنسازی پیچیدهتر شد. مدلهایی مانند سیستمهای ترجمه ماشینی برای ترجمه صحیح زبان به تقسیمبندی جمله و مرزهای دقیق کلمات نیاز دارند. توکنسازی پایه برای تطبیق با علائم نگارشی، خط فاصله و کلمات مرکب گسترش یافت.
- رمزگذاری زیرکلمه و جفت بایت در یادگیری عمیق (دهه ۲۰۱۰): با ظهور مدلهای یادگیری عمیق مانند Word2Vec و BERT، روشهای توکنسازی برای مدیریت کارآمد واژگان بزرگ و متن چندزبانه تکامل یافتند. تکنیکهای توکنسازی زیرکلمه مانند رمزگذاری جفت بایت (BPE) محبوب شدند و به مدلها اجازه دادند کلمات نادر یا پیچیده را به بخشهای کوچکتر و معنادار تجزیه کنند.
- مدلهای پیشرفته زبان و بهینهسازی توکنسازی (اواخر دهه ۲۰۱۰ تاکنون): توکنسازی با مدلهای پیشرفتهای مانند GPT-3 و GPT-4 به سطوح جدیدی از پیچیدگی رسیده است. این مدلها برای مدیریت کارآمد پیکرههای متنی بزرگ و در عین حال حفظ مفهوم متن، به تکنیکهای پیشرفته توکنسازی متکی هستند. توکنسازهایی مانند SentencePiece و WordPiece به این مدلها کمک میکنند تا زبانهای ظریف را در متنها و زبانهای مختلف درک کنند.
انواع توکنسازی در AI
برنامههای مختلف هوش مصنوعی از روشهای توکنسازی متنوعی استفاده میکنند که هر کدام مزایا و معایبی دارند. در اینجا خلاصهای از آنها آورده شده است:
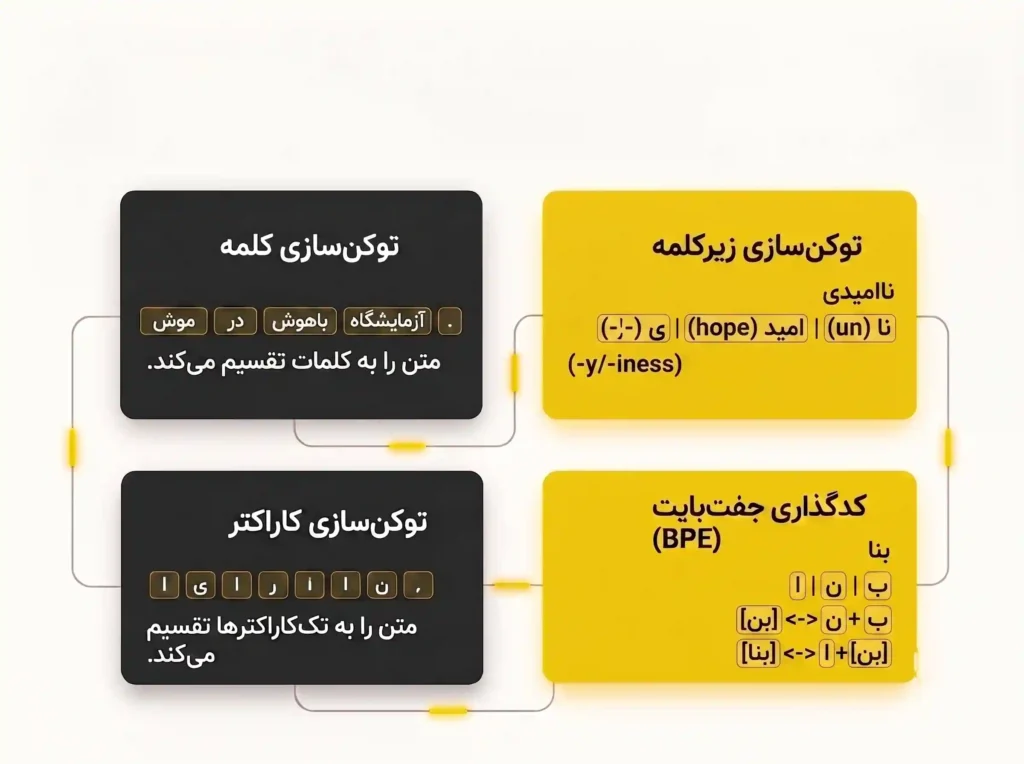
- توکنسازی کلمه(Word tokenization): در توکنسازی کلمه، متن بر اساس فاصلهها و علائم نگارشی تقسیم میشود تا کلمات را جدا کند. این روش برای زبانهایی که کلمات را با فاصله از هم جدا میکنند، خوب کار میکند، اما با زبانهایی که از سیستمهای کاراکتری پیچیده استفاده میکنند، مشکل دارد. همچنین اگر واژگان زیاد باشد، میتواند ناکارآمد باشد، زیرا هر کلمه به توکن مخصوص به خود تبدیل میشود.
- توکنسازی زیرکلمه(Character tokenization): توکنسازی زیرکلمات، که در مدلهایی مانند GPT و BERT محبوب است، کلمات را به واحدهای کوچکتر میشکند. این رویکرد به رفع مشکلات خارج از واژگان کمک میکند و تعداد توکنها را برای کلمات ریشهای پرتکرار کاهش میدهد. ابزارهایی مانند WordPiece یا SentencePiece از روشهای آماری برای تصمیمگیری در مورد بهترین روش تقسیم کلمات بر اساس فراوانی آنها در یک مجموعه آموزشی استفاده میکنند.
- توکنسازی کاراکتر(Character tokenization): توکنسازی در سطح کاراکتر، هر کاراکتر را به عنوان یک توکن در نظر میگیرد. اگرچه این روش پوشش هر زبان یا نمادی را تضمین میکند، اما اغلب منجر به توالیهای طولانیتر میشود و آموزش را کندتر میکند. با این حال، میتواند برای زبانهایی با ساختارهای مورفولوژیکی غنی یا وظایفی که در آنها تفاوتهای ظریف کاراکتر به طور قابل توجهی بر معنای متن تأثیر میگذارند، مفید باشد.
- رمزگذاری جفتبایتی(Byte pair encoding (BPE)): رمزگذاری جفتبایتی (BPE) به صورت تکراری، جفتهای پرتکرار کاراکترها یا زیرکلمات را ادغام میکند. این روش به طور مؤثر متن را به توکنها فشرده میکند و در عین حال به اندازه کافی انعطافپذیر است تا کلمات نادر را مدیریت کند. BPE به طور گسترده در معماریهای ترانسفورماتور مورد استفاده قرار میگیرد و اندازه واژگان و عملکرد مدل را متعادل میکند و آن را به انتخابی برتر برای بسیاری از وظایف NLP تبدیل میکند.
چرا LLM ها از توکن ها استفاده می کنند؟
مدلهای زبانی بزرگ(LLM) از ترکیبی از این انواع توکن برای درک و پردازش مؤثر ورودیها استفاده میکنند. توکنهای متنی محتوای اصلی را ارائه میدهند، توکنهای نقطهگذاری به انتقال دقیق معنا کمک میکنند و توکنهای ویژه، جریان و قالببندی متن را مدیریت میکنند. استفاده از این انواع توکن در کنار هم به مدلهای LLM کمک میکند تا پاسخهای منسجم، آگاه از متن و از نظر دستوری صحیح تولید کنند. این امر به مدلهای LLM اجازه میدهد تا وظایف مختلفی را از تولید متن ساده گرفته تا دیالوگهای پیچیدهتر و تکمیل کد، انجام دهند.
انواع توکنهایی که در LLm استفاده میشوند
مدلهای زبان بزرگ (LLM) از انواع مختلفی از توکنها برای درک متن استفاده میکنند. در اینجا تفاوت هر نوع آورده شده است:
- توکنهای متنی (Text Tokens): توکنهای متنی نشاندهنده کلمات یا بخشهایی از کلمات هستند. آنها رایجترین نوع هستند. برای مثال، جمله «AI سرگرمکننده است» به [«AI»، «is»، «fun»] تبدیل میشود. گاهی اوقات، آنها به بخشهایی مانند [«A»، «I»، «is»، «fun»] تجزیه میشوند. توکنهای متنی به مدلهای زبانی بزرگ(LLM) کمک میکنند تا ایده اصلی را درک کنند. آنها الگوهای زبان مدل، دستور زبان و زمینه را آموزش میدهند.
- علائم نگارشی (Punctuation Tokens): نشانههای نگارشی شامل ویرگول، نقطه و علامت تعجب هستند. آنها ساختار و جریان متن را حفظ میکنند. برای مثال، در جملهی «وای، چه باحال!»، نشانههای نگارشی «،» و «!» هستند. بنابراین، این نشانهها به صورت [«وای،» «،» «،» «!»] در میآیند. آنها به زبانآموزان کمک میکنند تا بفهمند کجا مکث کنند، تأکید کنند یا انتهای جمله را علامت بزنند. بدون نشانههای نگارشی، متن تولید شده توسط هوش مصنوعی، رباتیک به نظر میرسد.
- توکنهای ویژه (Special Tokens): توکنهای ویژه متن را مدیریت میکنند. آنها نحوه رفتار مدل را کنترل میکنند. نمونههای رایج عبارتند از:
- پایان متن (
<|endoftext|>): این علامت مانند نقطه (.) که پایان جمله را نشان میدهد، به مدل علامت میدهد که عملکرد خود را متوقف کند. - خط جدید (
\n): نشاندهندهی پرش به خط جدید است. آن را مانند فشردن کلید «Enter» روی صفحه کلید خود در نظر بگیرید. - توکن پرکننده (
<pad>): آنها فضا را پر میکنند. هنگام کار با دستههایی از ورودیها مفید هستند. - تفکیککننده (
<|sep|>): دستورالعملهای ویژه (<|sep|>): آنها بخشهایی از اعلان را از هم جدا میکنند. برای دیالوگها یا وظایف مفید هستند.
ظرقیت ورودی(context windows)
هر LLM در تعداد توکنهایی که میتواند همزمان پردازش کند، محدود است. این محدودیتها (ظرقیت ورودی(context windows)) کلیدی هستند زیرا بر عملکرد، هزینه و کارایی تأثیر میگذارند. محدودیتهای توکن، میزان زمینهای را که یک LLM میتواند مدیریت کند، تعریف میکنند. زمینه شامل اعلانها، دستورالعملها و تبادلات گذشته است. محدودیتهای بالاتر توکن به این معنی است که مدل میتواند ورودیهای طولانیتری را مدیریت کند و زمینه را در مکالمات طولانیتر حفظ کند.
این امر منجر به پاسخهای مرتبطتر و دقیقتر، به ویژه برای وظایفی با متنهای طولانی یا دیالوگهای چند نوبتی میشود. مدلهایی با محدودیت توکن بالاتر میتوانند خروجیهای دقیقتر و ظریفتری ارائه دهند. با این حال، افزایش اندازه پنجره زمینه همیشه منجر به عملکرد بهتر نمیشود.
در اینجا نحوه تعیین محدودیتهای توکن توسط محبوبترین مدلهای LLM آورده شده است:
| مدل | ظرقیت ورودی (تقریباً) | استفاده |
|---|---|---|
| جمنای (Gemini 1.5 Pro) | ~ 2,000,000 توکن | بی رقیب در پردازش فایلها و ویدیوهای سنگین، تحلیل کل پروژههای برنامهنویسی و کتابهای بسیار طولانی. |
| کلود (Claude 3.5 Sonnet) | ~ 200,000 توکن | فوقالعاده برای نگارش متون طبیعی، تحلیل دقیق کدهای پیچیده، بررسی اسناد فنی و استدلالهای عمیق. |
| جی پی تی (GPT-4o) | ~ 128,000 توکن | ایدهآل برای برنامهنویسی، کارهای چندرسانهای (متن، صوت، تصویر) و مکالمات روزمره و هوشمند. |
| لاما (Llama 3.1 / 3.3) | ~ 128,000 توکن | قدرتمندترین مدل متنباز؛ عالی برای توسعهدهندگان، پیادهسازی روی سرورهای شخصی و وظایف سفارشیسازیشده. |
| دیپ سیک (DeepSeek V3 / R1) | ~ 64,000 – 128,000 توکن | متخصص در ریاضیات، استدلالهای منطقی سخت و برنامهنویسی با هزینه پردازش بسیار پایین و سرعت بالا. |
جمعبندی
توکنها بخش مهمی از نحوه عملکرد هوش مصنوعی هستند. آنها به مدلها اجازه میدهند اطلاعات را تجزیه، تحلیل و درک کنند. با این حال، استفاده هوشمندانه از توکنها کلید دستیابی به بهترین نتایج است. مهندسی سریع کارآمد – واضح و مختصر نگه داشتن ورودیها – به صرفهجویی در توکنها و بهبود کیفیت خروجی کمک میکند.
همچنین میتوانید قالبهای خاصی مانند نقاط بولت یا جداول را درخواست کنید تا پاسخهای واضحتر و کارآمدتری دریافت کنید. با تکامل هوش مصنوعی، درک توکنسازی در صنایع مختلف اهمیت بیشتری پیدا خواهد کرد. هوش مصنوعی در حال حاضر فراتر از توانمندسازی چتباتها و پردازش دادهها عمل میکند. مردم به طور فزایندهای از این ابزار برای سادهسازی کارهای روزمره، بهبود ارتباطات و مدیریت مؤثر دادهها استفاده میکنند. دانستن نحوه بهینهسازی استفاده از توکن تضمین میکند که هوش مصنوعی همچنان ابزاری کاربردی و قدرتمند برای کسبوکار شما باقی بماند.