
واژهنامه · حاکمیت
Human-in-the-loop چیست و چه کاربردی دارد؟
تعریف به زبان ساده
انسان در حلقه به سیستمهای هوش مصنوعی اشاره دارد که بازخورد یا مداخله انسانی را به عنوان بخشی از عملکرد خود در نظر میگیرند.
هوش مصنوعی امروزه قدرت بینظیری پیدا کرده و در حوزههای مختلفی عملکرد قابل توجهی نشان داده است. با این وجود همچنان در مورد سپردن برخی وظایف حساس به هوش مصنوعی تریدهایی وجود دارد. به نظر میرسد با توجه به محدودیتهای ذاتی این رباتها، اتوماسیون در موقعیتهایی که نیاز به تصمیمگیریهای پیچیده دارند مانند حوزههای بهداشت و درمان، امور مالی، فرآیندهای حقوقی و سیستمهای خودکار امکان پذیر نیست.
این موقعیتها نیازمند درک بافت ( context)، قضاوتهای اخلاقی و پاسخگویی هستند که هوش مصنوعی هنوز قادر به ارائه آنها نیست. این مسئله منجر به توسعه روشهای مختلف «انسان در حلقه» (HITL) شده است.
در این سیستمها، انسانها ممکن است جهتدهی، اصلاح خطاها، یا تصمیمگیریهای نهایی را انجام دهند تا دقت و قابلیت اطمینان هوش مصنوعی ارتقا یابد. این رویکرد، نقاط قوت انسان و ماشین را تلفیق میکند و تضمین میکند که وظایف پیچیده یا حساس (با ریسک بالا) از قضاوت و نظارت انسانی بهرهمند شوند.
سه الگوی اصلی مشارکت انسان در سیستمهای هوش مصنوعی
یکی از رایجترین روشهای طبقهبندی تعامل انسان و هوش مصنوعی، بر اساس جایگاه انسان در حلقه تصمیمگیری است. این دیدگاه سه الگوی اصلی را معرفی میکند که میزان مشارکت و مسئولیت انسان را در عملکرد سیستم مشخص میسازند.
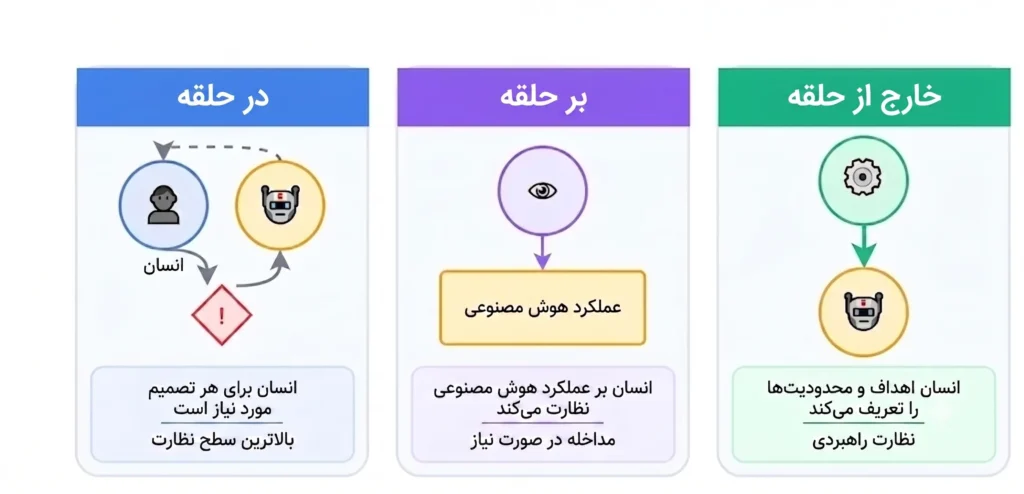
1. انسان در حلقه (Human-in-the-Loop)
این مدل بیشترین میزان دخالت و مشارکت مستقیم انسان را دارد. هوش مصنوعی بخشی از کار را انجام میدهد — معمولاً پیشنهاد، پیشبینی یا امتیازی را تولید میکند — اما بدون تأیید انسان نمیتواند تصمیم نهایی را بگیرد.
مثالها عبارتند از:
ابزار رادیولوژی: برنامهای که اسکنهای غیرطبیعی را نشانهگذاری میکند، اما پزشک متخصص پیش از اعلام نهایی، تشخیص را تأیید میکند.
سیستم درخواست وام: جایی که هوش مصنوعی میزان اعتبار مالی فرد را ارزیابی میکند، اما یک کارشناس انسانی وام، هر پرونده را تأیید یا رد میکند.
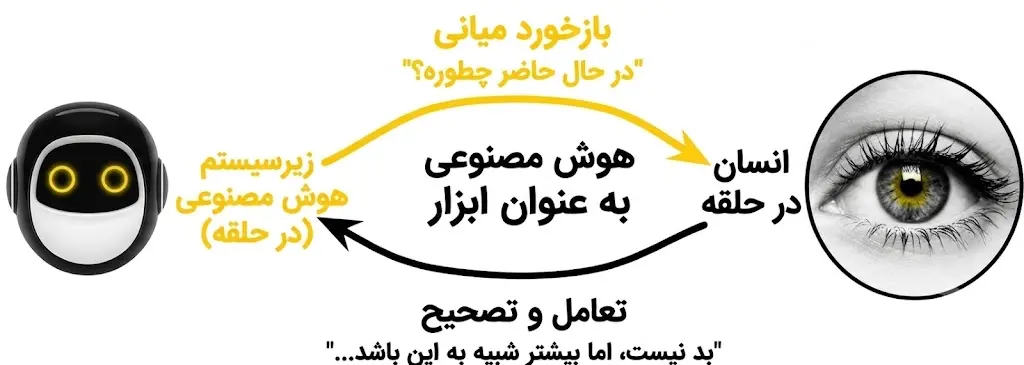
۲. انسان بر حلقه(Human-on-the-Loop)
در این حالت، هوش مصنوعی بهصورت مستقلتری عمل میکند. تصمیمات را در لحظه میگیرد و اجرا میکند — اما یک انسان همچنان بر روند کار نظارت دارد. انسانها نتایج را رصد میکنند، تصمیمات را ممیزی میکنند و در صورت نیاز مداخله میکنند.
نمونههای آن عبارتند از:
داشبورد تشخیص تقلب که در آن تحلیلگران بر تراکنشهای مشکوکنشانهگذاریشده نظارت دارند، الگوهای مشکوک را ارجاع میدهند و قوانین سیستم را در لحظه تنظیم میکنند.
خودرو خودران مجهز به یک تیم نظارت از راه دور که میتواند در شرایط خاص و پیچیده، کنترل خودرو را به دست بگیرد.
۳. انسان خارج از حلقه (Human-out-of-the-Loop)
در این سطح، سیستم کاملاً خودکار است. کارهای خود را بدون دخالت انسان انجام میدهد — نه نیازی به پایش دارد، نه مرحلهای برای تأیید و نه نظارت لحظهای.
نمونههای آن عبارتند از:
- غلطگیرهای املایی که اشتباهات تایپی شما را فورا اصلاح میکنند.
- موتورهای پیشنهاددهنده که محتوا را به کاربر ارائه میدهند.
- سیاستهای مقیاسبندی خودکار که منابع پردازش ابری را در لحظه تنظیم میکنند.
| الگوی مشارکت | نحوه عملکرد و میزان خودمختاری هوش مصنوعی | حوزه کاربردی رایج |
|---|---|---|
| انسان در حلقه (Human-in-the-Loop) | مشارکت مستقیم انسانی | پزشکی، امور حقوقی، سامانههای امنیتی حساس |
| انسان بر حلقه (Human-on-the-Loop) | نظارت، مداخله انسانی تنها در صورت لزوم | کارخانههای صنعتی اتوماتیک، مانیتورینگ شبکه |
| انسان خارج از حلقه (Human-out-of-the-Loop) | بدون نظارت یا مداخله مستقیم انسان | تجارت الگوریتمی پرسرعت، پیشنهاد خودکار محتوا |
نقاط مداخله انسانی در حلقه توسعه و اجرای هوش مصنوعی
در طراحی سامانههای انسان در حلقه (Human-in-the-Loop)، مسئله اصلی فقط این نیست که «آیا انسان در سیستم حضور دارد یا نه»، بلکه این است که انسان در چه مرحلهای از حلقه عمر هوش مصنوعی وارد فرآیند میشود؟ این محلهای ورود یا نقاط مداخله مشخص میکنند که کنترل انسانی در کدام بخش از مسیر توسعه، تنظیم یا استفاده از سیستم اعمال شود.
بهطور کلی، سه نقطه اصلی برای ورود انسان وجود دارد:
۱. زمان آموزش مدل (Training Time)
در مرحله آموزش، انسان نقش اصلی را در فراهمکردن دانش اولیهای دارد که مدل بر اساس آن یاد میگیرد. در این مرحله، انسان معمولاً دادهها را برچسبگذاری میکند و مشخص میسازد که خروجی درست یا نادرست چیست. این اطلاعات بهعنوان حقیقت مبنا (Ground Truth) عمل میکند و پایه یادگیری مدل را شکل میدهد.
مثال: در یک سیستم تشخیص تصویر، انسان هزاران تصویر را بررسی کرده و مشخص میکند که کدام تصویر شامل «تابلو ایست» است. مدل با مشاهده این نمونهها، الگوهای لازم برای تشخیص این مفهوم را یاد میگیرد.
روشهای بهینهسازی: یکی از روشها یادگیری فعال (Active Learning) است. در این روش، انسان به جای برچسبگذاری حجم عظیمی از دادهها، تنها روی نمونههایی تمرکز میکند که مدل درباره آنها مطمئن نیست یا بیشترین ابهام را دارد. در نتیجه، هزینه و زمان مشارکت انسانی کاهش پیدا میکند، در حالی که کیفیت یادگیری حفظ میشود.
۲. زمان تنظیم و اصلاح مدل (Tuning Time)
پس از آموزش اولیه، مدل معمولاً نیاز دارد رفتار خود را با اهداف انسانی هماهنگتر کند. بسیاری از ویژگیهای مطلوب مانند «مفید بودن»، «ایمن بودن» یا «پاسخ مناسب در شرایط مختلف» بهسادگی با یک دستور ریاضی مشخص قابل تعریف نیستند. در این مرحله، انسان نقش ارزیاب و تنظیمکننده رفتار مدل را ایفا میکند.
روشهای بهینهسازی: یکی از مهمترین روشها در این مرحله، یادگیری تقویتی از بازخورد انسانی است. در این روش، انسان چند خروجی مختلف مدل را مقایسه میکند و مشخص میکند کدام پاسخ بهتر است. این ترجیحات انسانی سپس به یک مدل پاداش تبدیل میشوند تا سیستم یاد بگیرد چه نوع رفتاری مطلوبتر است.
۳. زمان استنتاج و استفاده واقعی از سیستم (Inference Time)
این مرحله مربوط به زمانی است که مدل در محیط واقعی به کار گرفته شده و تصمیمگیری میکند. در اینجا، مشارکت انسانی معمولاً با هدف کنترل، نظارت و جلوگیری از خطاهای مهم طراحی میشود.
این نوع مداخله بهویژه در سیستمهای عاملمحور (Agentic AI) اهمیت زیادی دارد؛ زیرا چنین سیستمهایی ممکن است بتوانند اقداماتی مانند اجرای کد، تغییر دادهها یا انجام عملیات خودکار را انجام دهند.
روشهای مختلف Human-in-the-Loop
روشهای مختلف Human-in-the-Loop را میتوان بر اساس معیارهایی مانند حوزه کاربرد، نوع مشارکت انسان، هزینه تعامل، مقیاسپذیری، قابلیت استفاده در زمان واقعی و میزان مقاومت در برابر تغییر توزیع دادهها یا حملات خصمانه با یکدیگر مقایسه کرد. هر یک از این روشها برای شرایط خاصی طراحی شدهاند و انتخاب مناسب آنها به ویژگیهای مسئله، محدودیتهای عملیاتی و میزان ریسک کاربرد بستگی دارد.
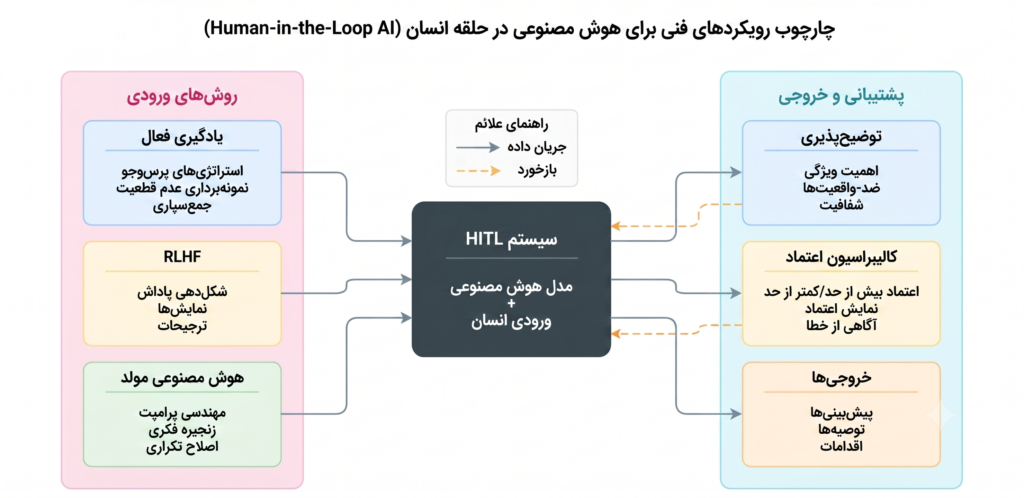
سیستم HITL (مرکز): هسته ترکیبی مدل هوش مصنوعی و ورودی انسان.
پشتیبانی و خروجی (سمت راست): ارائه نتایج نهایی همراه با ابزارهای توضیحپذیری و کالیبراسیون اعتماد برای ارزیابی و بازگرداندن بازخورد به سیستم.
یادگیری فعال (Active learning) و برچسبگذاری انسانی (Human annotation)، در حوزههایی که با کمبود داده مواجه هستند و کیفیتِ برچسبها گلوگاه اصلی محسوب میشود، مزیتهایی دارند؛ این تکنیکها کنترلپذیری بالایی ارائه میدهند، اما در سناریوهای برچسبگذاری در مقیاس بزرگ، میتوانند بهشدت هزینهبر شوند.
یادگیری تقویتی از بازخورد انسانی (RLHF) و بهینهسازی ترجیحات، میتوانند در همسوسازی رفتاری مدلهای مولد مؤثر باشند، اما از هزینههای تعاملی بالاتر رنج میبرند و نیازمند اقدامات متقابل قویتری در برابر پدیدههایی مانند «هک پاداش» (reward hacking)، انحراف ترجیحات و عدم ثباتِ ارزیابان هستند.
مدلهای یادگیری ماشین تعاملی و راهنمایی انسانی، زمانی بهترین کارایی را دارند که امکان تکرار (Iteration) در طول فرآیند توسعه وجود داشته باشد و متخصصان حوزه در دسترس باشند؛ این مدلها امکان انطباق سریع با نیازهای محلیِ هر وظیفه را فراهم میکنند، اما در عین حال مستعدِ بازخوردهای غیرایستا و تفاوت در عملکرد اپراتورها نیز هستند.
رویکردهای اعتبارسنجی پسرویدادی (Post hoc) و ارجاع به سطوح بالاتر (Escalation)، برای مقیاسپذیری و سهولت در پیادهسازی مناسبترند (بهویژه زمانی که جداسازی و اولویتبندی بر اساس عدم قطعیت مؤثر باشد)، اما اگر مشکلات مربوط به داده یا مدل برطرف نشود، این روشها در رفع مسائل ساختاری مدل کارایی ندارند.
نکته مهم
به طور کلی، انتخاب هر یک از روشهای Human-in-the-Loop تنها به افزایش دقت مدل وابسته نیست، بلکه باید میان کیفیت عملکرد، هزینه مشارکت انسان، سرعت پاسخگویی و مقیاسپذیری سیستم تعادل برقرار شود.
مقایسه نهایی روشها
روشهایی که به تعامل گسترده با انسان متکی هستند، معمولاً همراستایی و دقت بیشتری ایجاد میکنند، اما هزینه و زمان اجرای بالاتری دارند.
در مقابل، روشهایی که مداخله انسانی را به حداقل میرسانند، برای حفظ قابلیت اطمینان خود نیازمند سازوکارهای دقیق ارزیابی عدم قطعیت، ارجاع هوشمند و چارچوبهای نظارتی مناسب هستند.
این موازنه میان استقلال هوش مصنوعی و نظارت انسانی یکی از مهمترین چالشهای طراحی سامانههای HITL در کاربردهای واقعی به شمار میرود.
| رویکرد | مکانیزم | نوع ورودی انسانی |
|---|---|---|
| یادگیری فعال | انتخاب استراتژیک نمونههای آموزنده برای برچسبگذاری | برچسبها، نشانهگذاریها |
| نمونهبرداری عدم قطعیت | جستجوی نمونههایی که اعتماد مدل در آنها کمترین است | اصلاح، اعتبارسنجی |
| برچسبگذاری جمعسپاریشده | برچسبگذاری توزیعشده از طریق پلتفرمهای آنلاین | برچسبها، قضاوتهای کیفیت |
| برچسبگذاری تخصصی | متخصصان حوزه، برچسبهای تخصصی ارائه میدهند | برچسبهای بالینی/فنی |
| شکلدهی پاداش انسانی | سیگنالهای پاداش مستقیم بر اساس ارزیابی رفتار | بازخورد ارزیاب |
| یادگیری ترجیحی | مقایسههای زوجی بین گزینههای جایگزین | ترجیحات نسبی |
| یادگیری نمایشی | آموزش از طریق تقلید رفتار متخصص | نمایشهای وظیفه |
| مهندسی پرامپت | استراتژیهای بلاغی برای ارتباط مؤثر با هوش مصنوعی | طراحی پرامپت، پالایش |
| پالایش تکراری | تولید چندمرحلهای با بازخورد انسانی | ارزیابی خروجی، اصلاح |
چالشهای فنی در طراحی HITL
اگرچه مشارکت انسان میتواند دقت و قابلیت اعتماد سامانههای هوش مصنوعی را افزایش دهد، اما این رویکرد با چالشهای فنی متعددی نیز همراه است. وابستگی بیش از حد به نیروی انسانی میتواند باعث کاهش سرعت پردازش، افزایش هزینههای عملیاتی و محدود شدن مقیاسپذیری سیستم شود.
علاوه بر این، کیفیت بازخوردهای انسانی همواره یکنواخت نیست و ممکن است تحت تأثیر عواملی مانند خستگی، سوگیریهای شناختی یا اختلاف نظر میان ارزیابان قرار گیرد.
به همین دلیل، پژوهشهای اخیر بیش از افزایش صرف میزان مشارکت انسان، بر توسعه سازوکارهایی تمرکز دارند که بتوانند زمان، شیوه و میزان مداخله انسانی را بهصورت هوشمند و بهینه تعیین کنند.
| چالش (Challenge) | توضیح (Description) | رویکردهای فعلی (Current Approaches) | مسیرهای تحقیقاتی آینده (Future Research Directions) |
|---|---|---|---|
| مقیاسپذیری نظارت انسانی (Scalability of Human Oversight) |
ظرفیت و توان انسانی برای حجم بالای تصمیمگیریهای هوش مصنوعی در مقیاس وسیع ناکافی است. | یادگیری فعال (Active learning)؛ نظارت چندسطحی و لایهای؛ حسابرسیهای مبتنی بر نمونهگیری | کمیسازی عدم قطعیت (Uncertainty quantification)؛ خودارزیابی هوش مصنوعی؛ پیکربندی و ساختاربندی تیمها |
| محدودیتهای شناختی انسان (Human Cognitive Limitations) |
خستگی، حواسپرتی و خطاهای توجه، و سوگیریهای شناختی بر کیفیت نظارت انسانی تأثیر منفی میگذارند. | مدیریت بار کاری؛ برنامههای آموزشی؛ طراحی بهینه رابط کاربری | سیستمهای تطبیقی پاسخگو به وضعیت شناختی؛ ساختارهای کاری پایدار و مداوم |
| تناقض در بازخوردهای انسانی (Conflicting Human Feedback) |
وجود عدم اتفاقنظر و اختلاف میان برچسبزنندگان دادهها (Annotators) و ذینفعان مختلف. | رأیگیری اکثریت؛ تجمیع وزنی بازخوردها؛ معیارهای سنجش کیفیت | رویکردهای مشورتی و گفتگومحور؛ مشخصسازی و دستهبندی انحرافات/اختلافات؛ روشهای دستیابی به اجماع |
| دستکاری و حملات خصمانه (Adversarial Manipulation) |
مهندسی اجتماعی و حملاتی که عناصر و کاربران انسانی سیستم را هدف قرار میدهند. | اقدامات امنیتی فنی؛ کنترلهای سطح دسترسی | مدلهای تهدید اختصاصی HITL؛ کشف و تشخیص دستکاری؛ تمهیدات و رویههای حفاظتی فرآیندی |
| معماریهای تطبیقی (Adaptive Architectures) |
پیکربندیها و تنظیمات ثابت سیستم ممکن است با نیازهای متغیر و پویا همخوانی نداشته باشند. | تعیین نقاط مداخله و مشارکت انسانی از پیش مشخصشده | تنظیم و تعدیل پویا بر اساس میزان ریسک؛ سیستمهای خودتنظیمگر؛ نظارت در سطح متا (Meta-level) |
تنظیم اعتماد به هوش مصنوعی
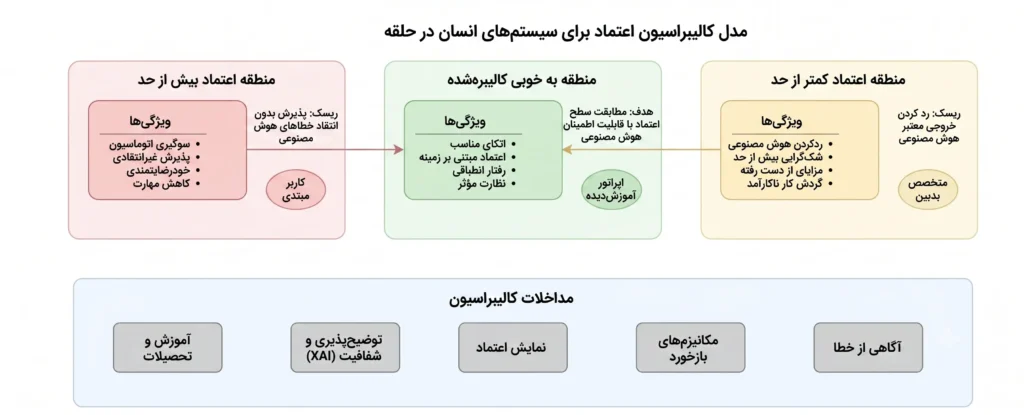
پژوهشها نشان دادهاند که تنظیم اعتماد (Trust Calibration) نقش مهمی در جلوگیری از اعتماد بیش از حد یا بیاعتمادی غیرمنطقی نسبت به سیستمهای هوش مصنوعی دارد. تکنیکهای هوش مصنوعی توضیحپذیر (Explainable AI) به کاربران کمک میکنند تصمیمهای مدل را بهتر درک کنند و اعتماد مناسبتری به آن داشته باشند.
کاربرد این فناوریها در حوزههایی مانند سلامت، سامانههای خودران و امنیت سایبری نیز نشان میدهد که حضور انسان همچنان برای تصمیمهای حساس ضروری است و طراحی سامانه باید متناسب با ویژگیهای هر حوزه انجام شود.
سخن آخر
انسان و هوش مصنوعی بهجای رابطه صرفاً نظارتی، بهعنوان دو شریک همکاری میکنند و نقش هر یک بهصورت پویا و متناسب با شرایط تغییر میکند. با این حال، در تصمیمهای حساس و پرریسک، باید همواره امکان لغو یا متوقف کردن تصمیم هوش مصنوعی توسط انسان و سازوکارهای روشن پاسخگویی حفظ شود.
بخشی از توضیحات ما برگرفته از این مقاله مروری است که تمام ابعاد موضوع را کاملا پوشش داده است. در صورت تمایل میتوانید متن کامل این مقاله را از طریق لنک زیر دانلود نمایید.
Human-in-the-Loop Artificial Intelligence: A Systematic Review of Concepts, Methods, and Applications
مرور سیستماتیک مفاهیم، روشها، چالشها و کاربردهای هوش مصنوعی با حضور انسان در چرخه (HITL)
دانلود PDFسایر منابع: